Trion-1:连接文字、蛋白序列与结构
将蛋白问答、折叠、逆折叠和文字条件设计放进统一框架,对照不同任务的成绩与可靠性。
清华大学 GenSI、AIR × 上海人工智能实验室等 · 2026-10-22
Trion-1把蛋白问答、结构预测与设计放进同一套框架;关键进步在于补强结构能力,而非每项任务都拿第一。
给模型一条蛋白序列,它可以解释可能的功能;再让它预测三维结构,往往就得换工具。反过来,想按一段功能描述设计蛋白,又要连接另一套生成系统。研究者真正需要的,可能是让这些能力能够在同一个接口里连续使用。
清华大学与上海人工智能实验室等团队提出的 Trion-1,尝试把这件事交给约40亿参数的模型完成。它不只是给语言模型加一个结构查看器,而是把语言、氨基酸序列和蛋白骨架都变成可以读取、生成的符号。论文最值得看的,是这套统一表示能否兼顾“说得明白”和“折得像”。
论文信息
| Title | Trion-1: Unifying Language, Protein Sequence, and Structure with Diffusion Language Models |
| Journal | arXiv |
| Posted | 2026-10-22 |
| URL | https://arxiv.org/abs/2610.31215 |
三种信息,六个方向,不再各用一套模型
Trion-1覆盖的六类任务,其实就是三种信息之间的双向转换:序列与结构互转,对应折叠和逆折叠;序列或结构转成文字,对应蛋白理解;文字转成序列或结构,对应条件设计。
实现的关键,是扩展 Qwen3-4B 的词表。普通文字、氨基酸符号和结构标记从第一层起共用一个 Transformer。三维骨架先由 DPLM2 的结构分词器压缩为离散标记,生成后再解码回骨架。可以把它理解成给模型增加一套“结构字母”,而不是直接让普通文本承载全部原子坐标。
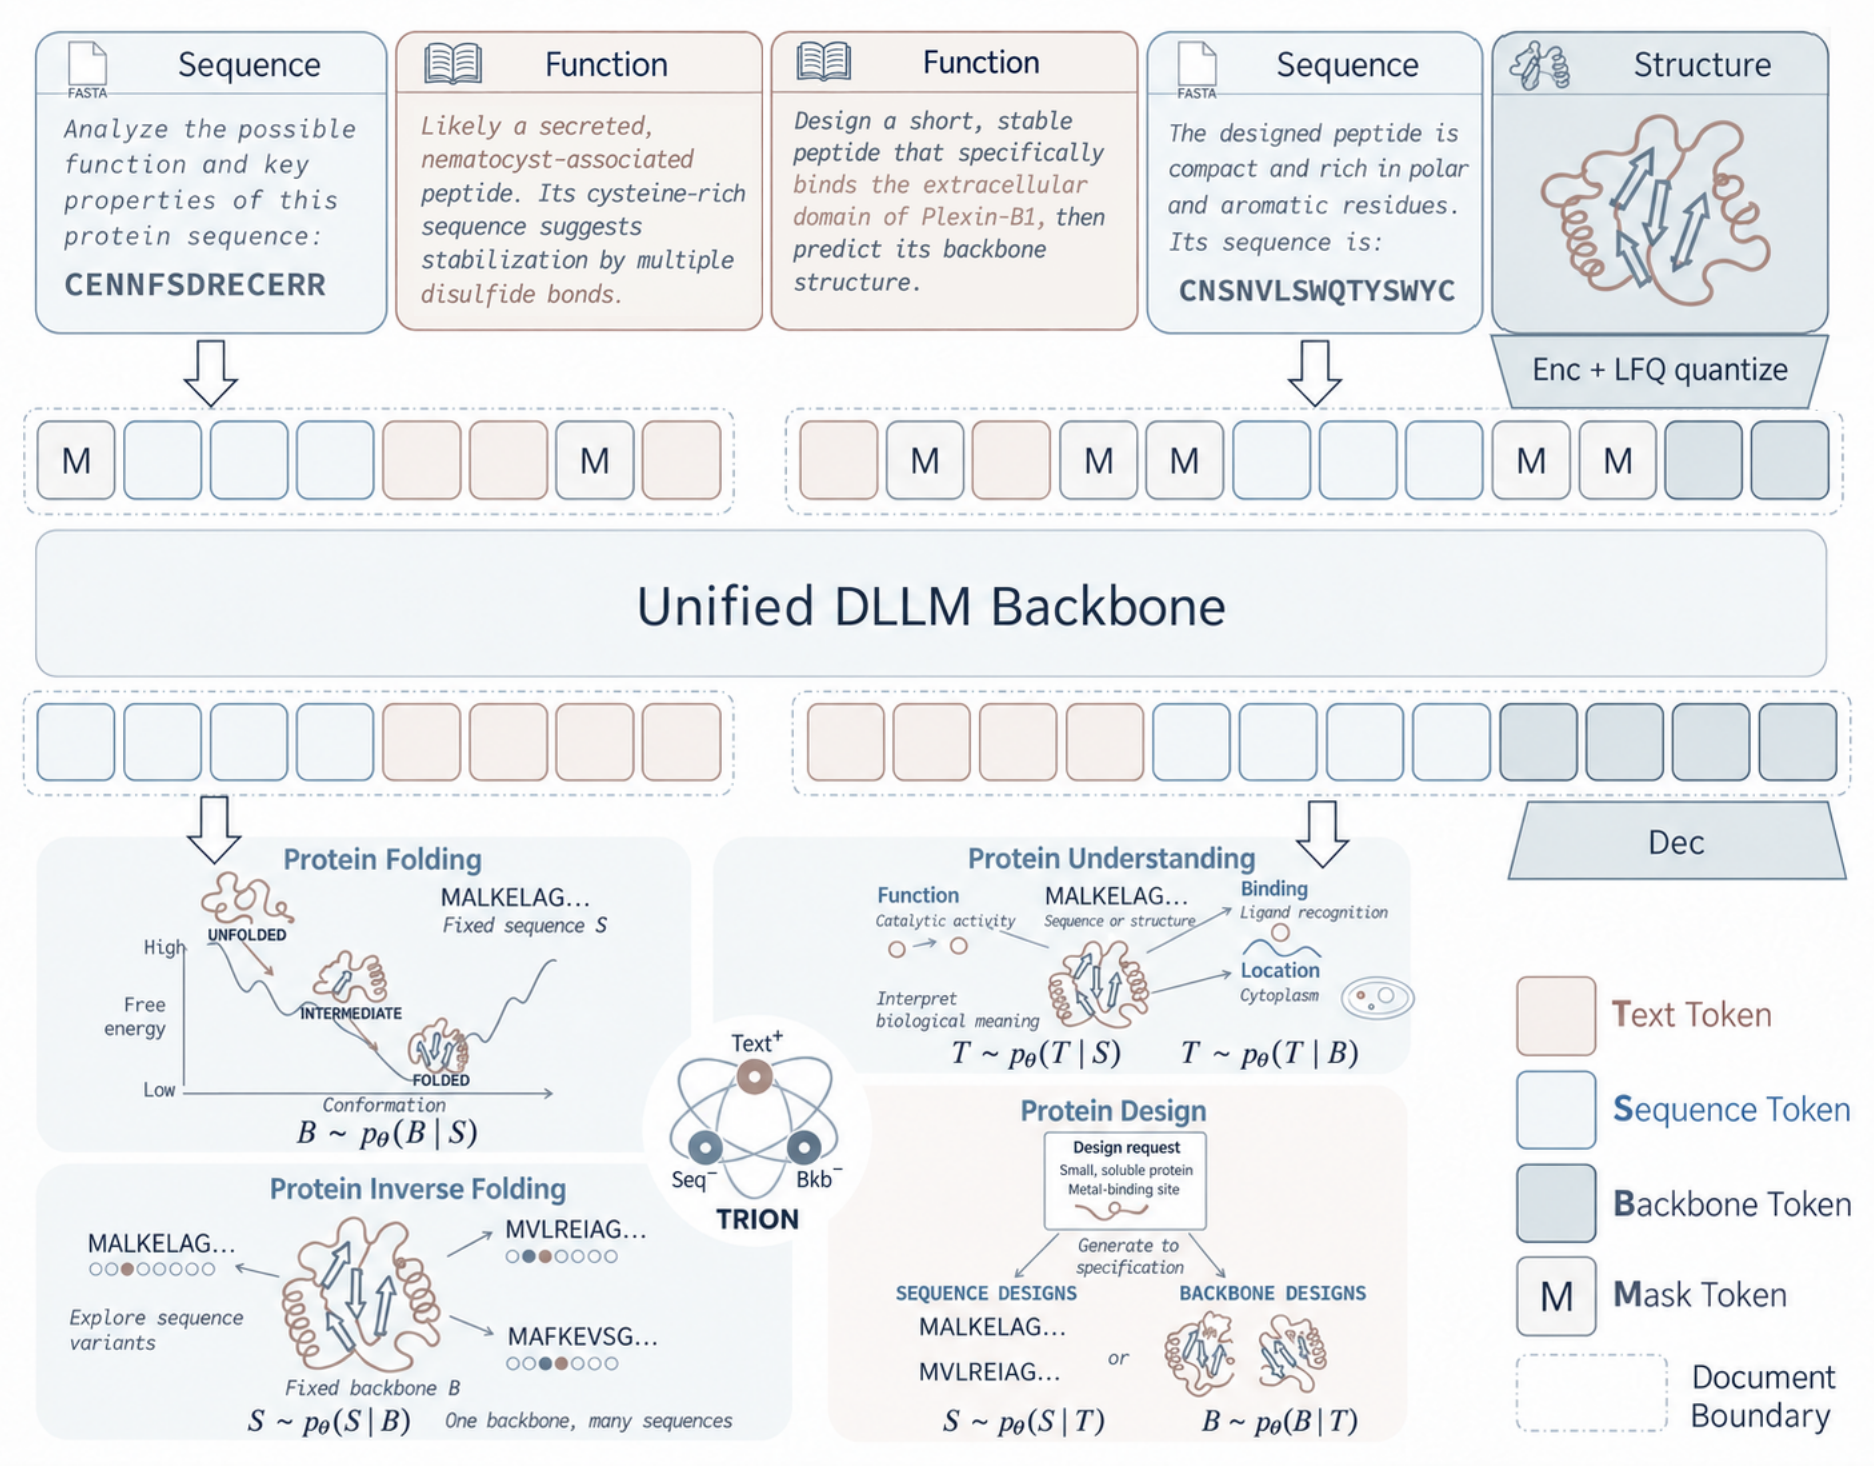
另一项改变是生成顺序。蛋白里相互接触的残基,在序列中可能相隔很远;严格从左到右生成结构时,前面的决定看不到尚未生成的后半段。扩散语言模型则从被遮住的标记开始,逐步补全,让更多位置可以交换信息。这里的“扩散”是离散标记的去噪生成,不是模拟真实折叠轨迹。
作者比较了两种版本:Trion-1(MDLM)允许全局双向交互;Trion-1(BDLM)分块生成,块内双向、块间从左到右。前者更擅长结构预测,后者在问答和序列设计上更占优势,后文的最好成绩并不全来自同一个版本。
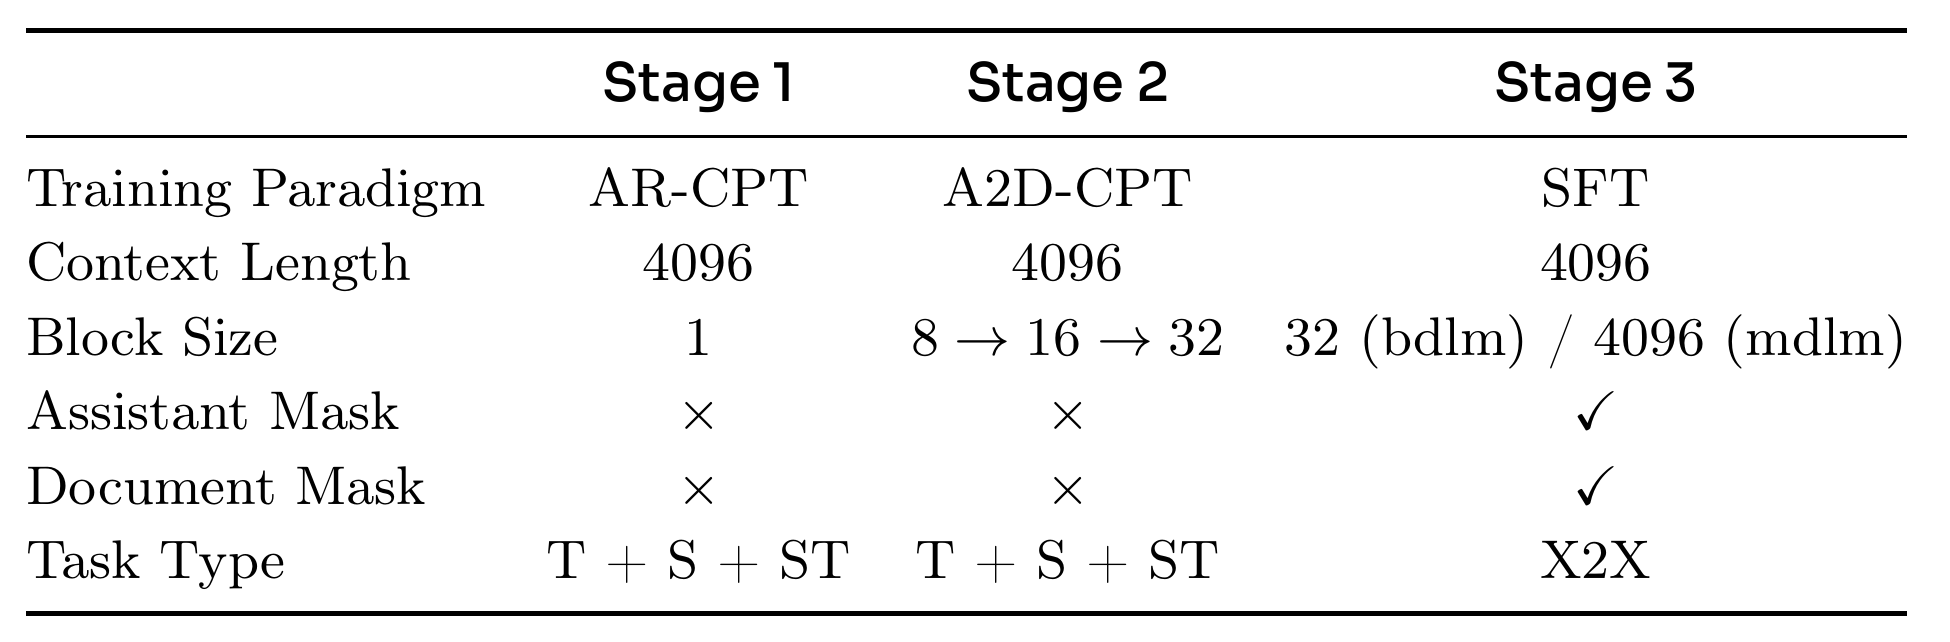
训练也分三步:先让基础模型学习蛋白序列与文字,再适配扩散生成,最后通过监督微调接入全部六类任务。结构数据只在最后阶段加入,不是从头用三模态数据一起训练。
最硬的一关:一次采样能折得多准
折叠与逆折叠测试共包含632个单体蛋白:CAMEO 2022的183个目标,以及 PDB日期划分的449个目标。为保持输入条件可比,作者没有纳入需要多序列比对输入的 AlphaFold 配置。
在PDB划分中,单次采样的 Trion-1(MDLM) 达到 TM分数0.86,同为三模态模型的 BioMatrix 单次采样为0.60。即使后者生成200个候选、按每项指标分别选出最好的结果,主TM分数也为0.82。对统一蛋白模型而言,这说明改善生成方式,有机会减少对反复抽样的依赖。
但“1次对200次”是候选数量比较,不能换算成200倍速度提升;这里的择优还借助了真实结构,不是实际使用时自动可用的选择器。专用模型仍然更强:同一表中 ESMFold 为0.94,SimpleFold 为0.95。
逆折叠则检查生成序列能否折回给定骨架。PDB划分上,MDLM版的氨基酸恢复率为58.03%,自洽性分数为0.92。前者衡量与原序列的相同程度,后者借助 ESMFold 预测检验骨架一致性;两者都不等于实验功能。
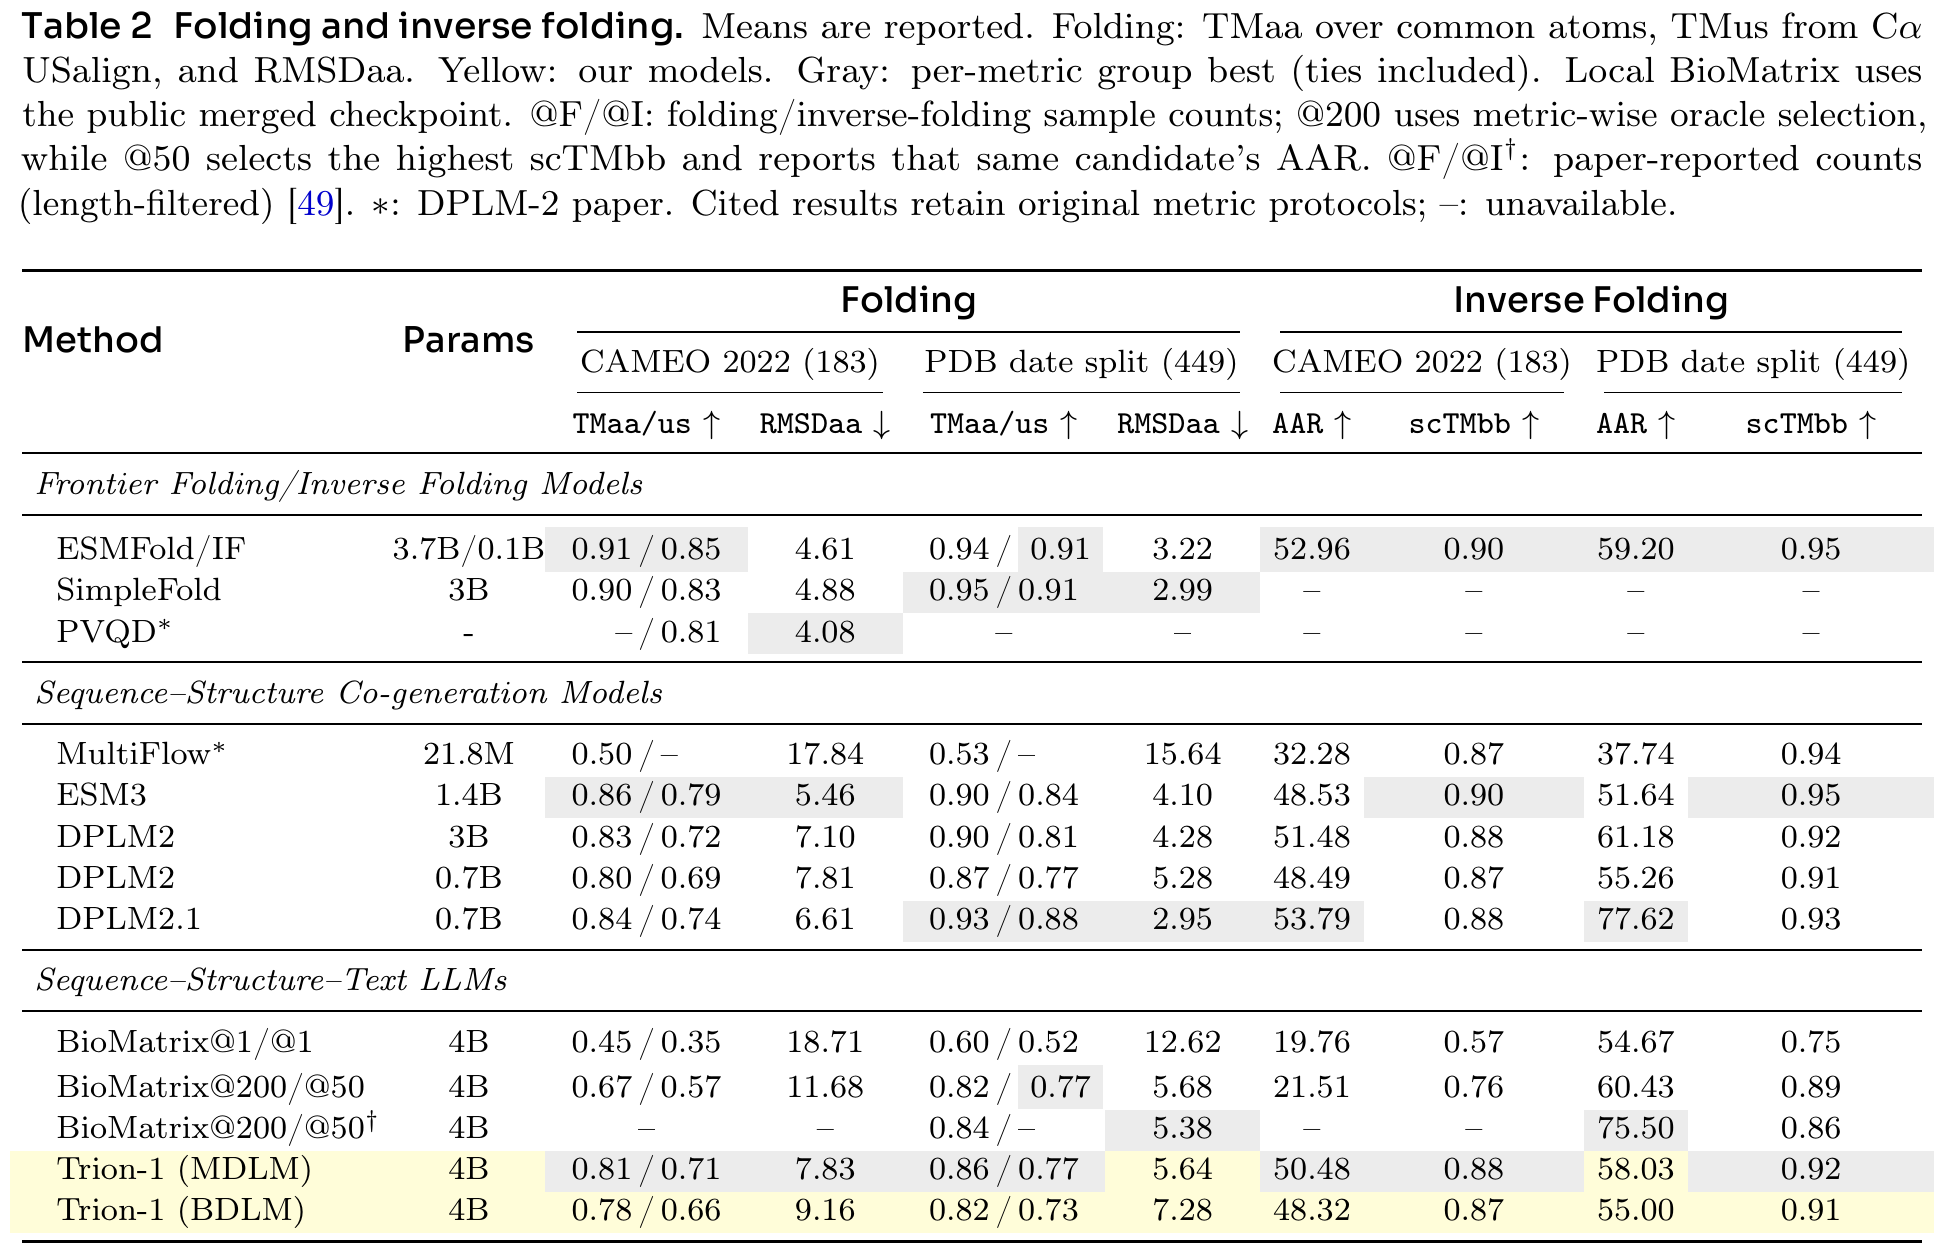
数值口径需留意:以上折叠分数按原文表2的主TM列(TMaa)引用;附录C另写为TMbb/TMca,指标名称与计算描述并不完全一致。跨论文比较时,不宜把这些口径直接混为一谈。
会预测骨架,也要回答生物学问题
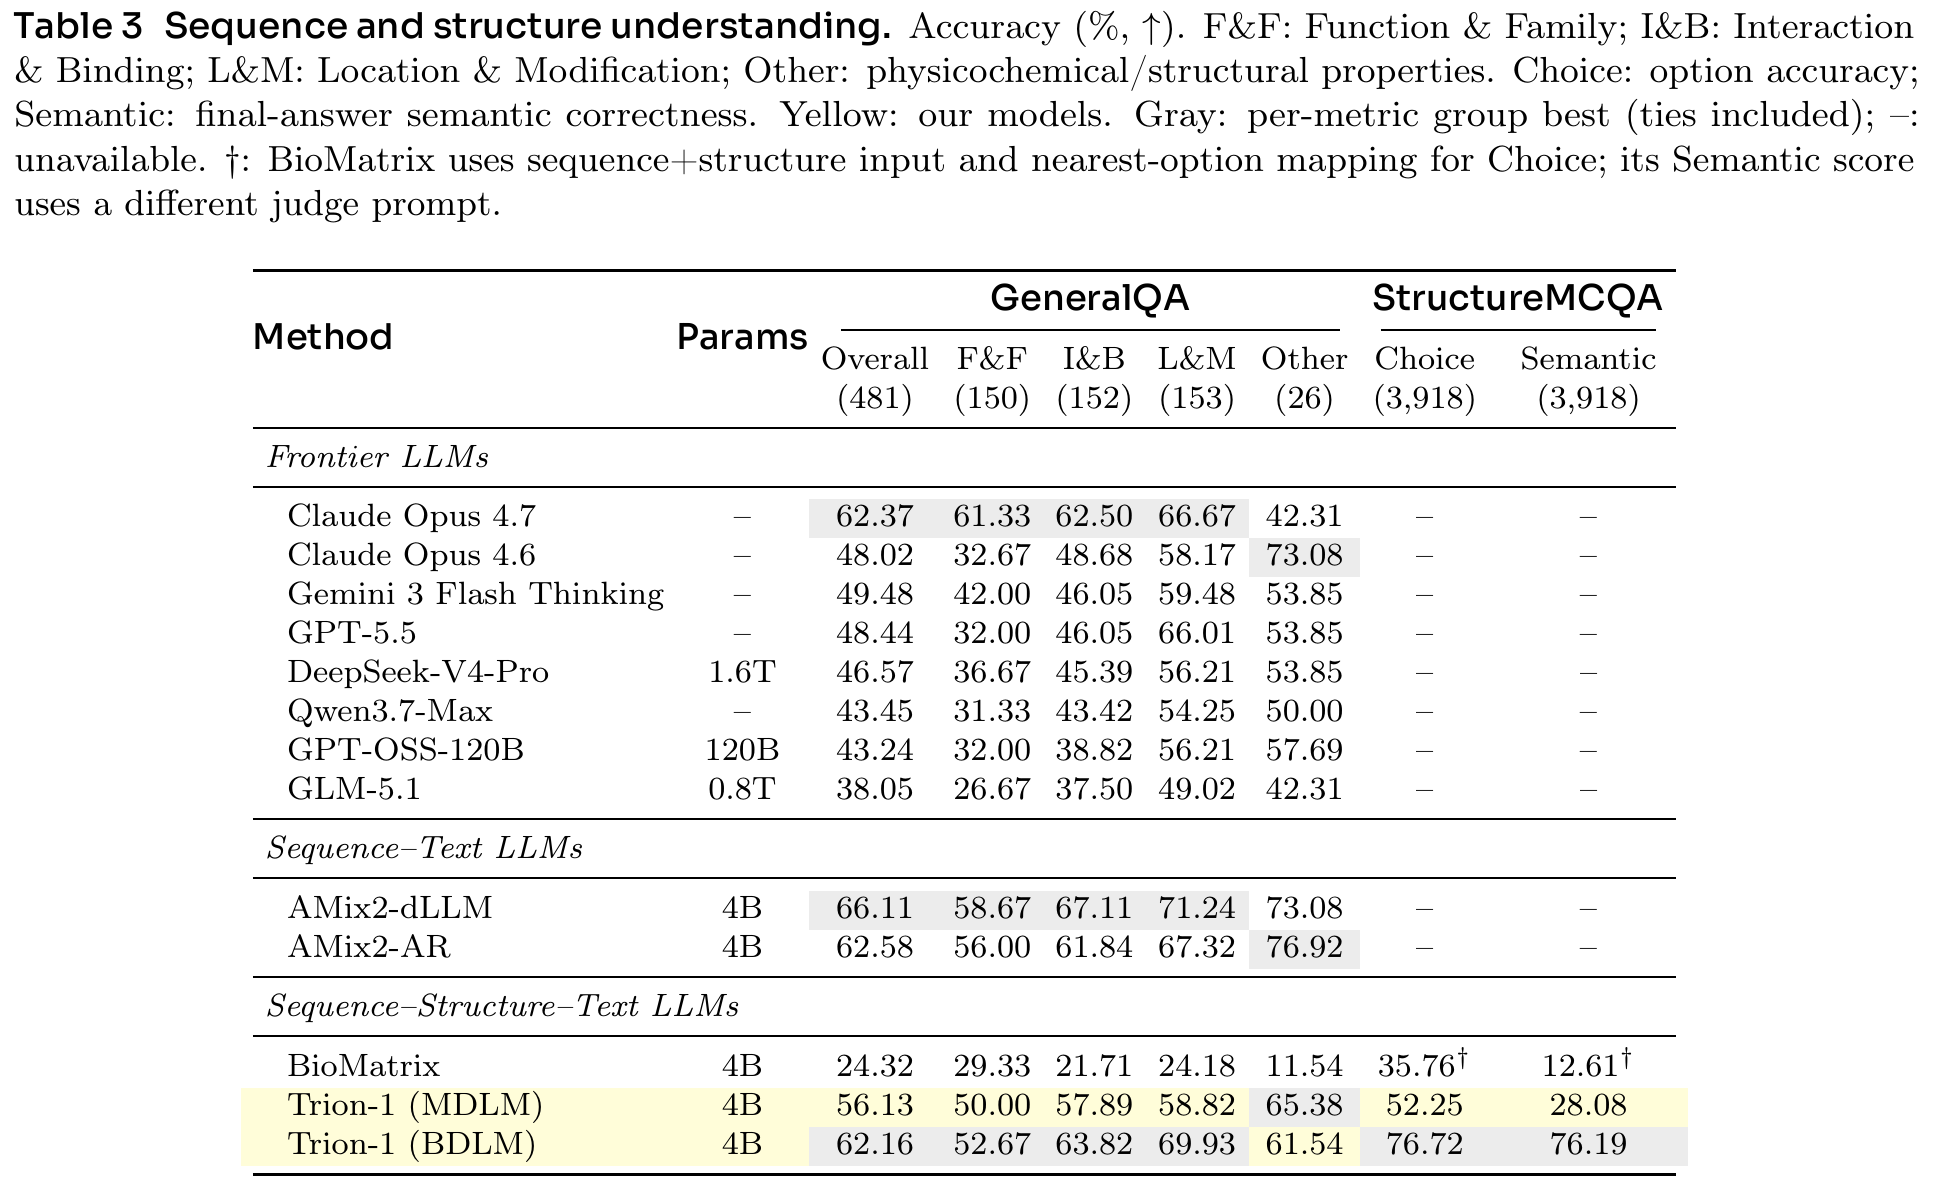
在481道 GeneralQA 蛋白序列问答中,Trion-1(BDLM)准确率为62.16%,接近 Claude Opus 4.7 的62.37%,但低于 AMix2-dLLM 的66.11%。问题涉及功能与家族、互作与结合、定位与修饰等,由基于 Gemini 的评判器判断回答与参考答案是否在生物学上等价。
这项成绩说明小规模专业模型能在特定蛋白问答集上接近大型通用模型,不能据此说它的通用推理能力已经追平后者。分项也不均衡:BDLM版对定位与修饰的回答好于功能与家族,平均分不会抹平任务难度。
结构理解测试则给出骨架,让模型完成3,918道四选一问题。BDLM版仅凭骨架输入获得76.72%的选项准确率。表中 BioMatrix 同时接收序列和结构,且部分答案需要映射到最近选项,评分协议不同,因此不宜把差距解读为严格同条件的提升幅度。
按文字设计蛋白,质量和可靠输出是两回事
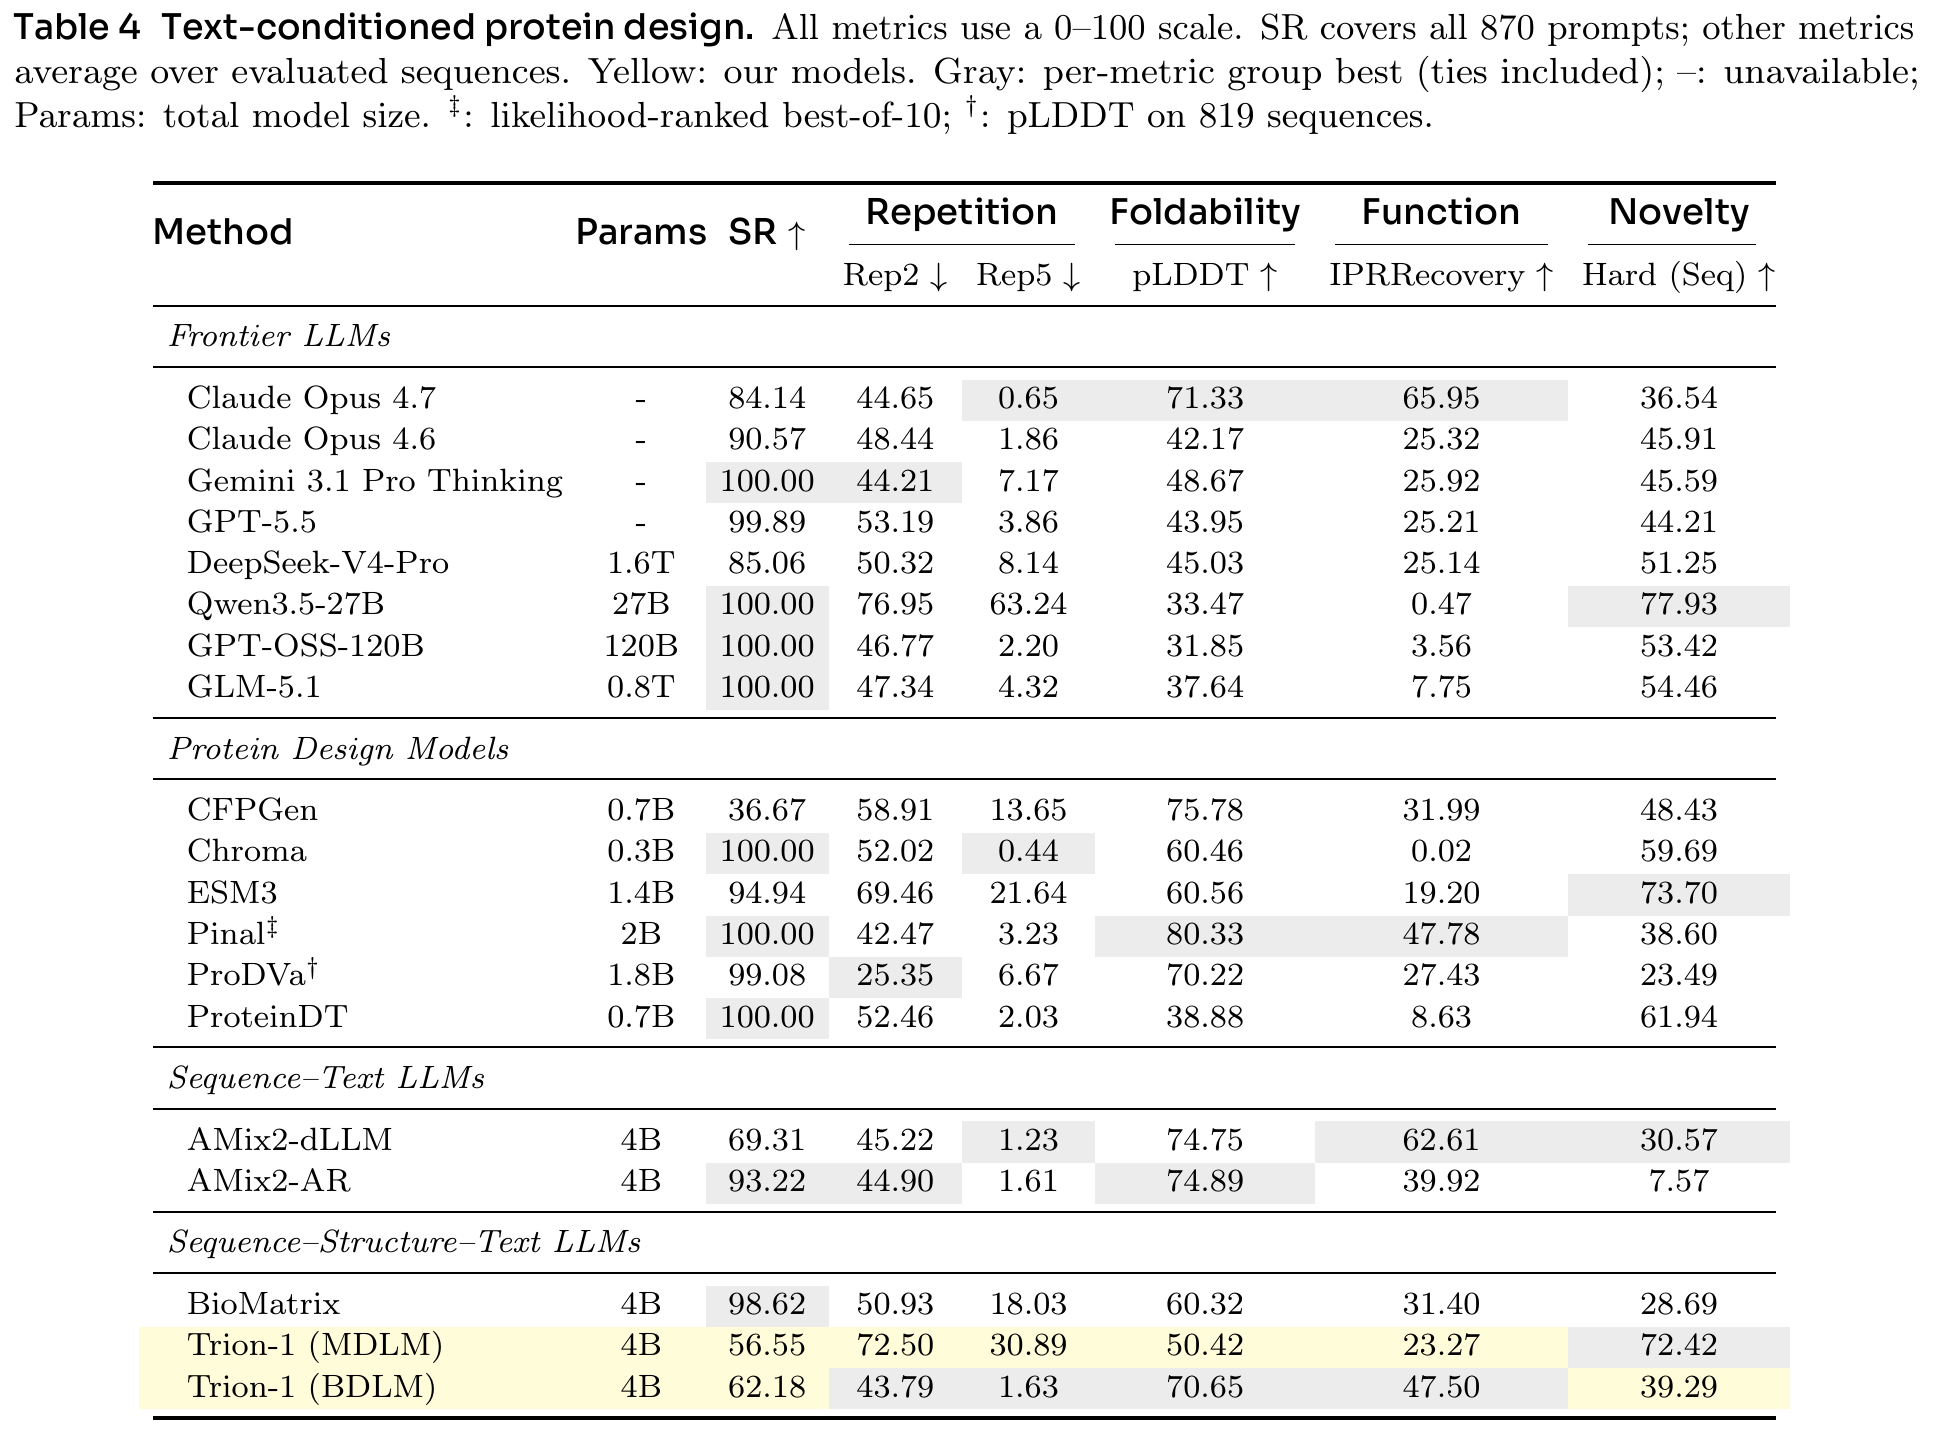
设计评测使用870条基于 InterPro 的提示,要求生成具有指定家族、结构域等特征的序列。这里必须拆开两个问题:模型能否输出可评估的序列,以及输出后看起来有多符合目标。
在可评估结果中,Trion-1(BDLM) 的结构预测置信度pLDDT为70.65,高于 BioMatrix 的60.32;InterPro注释恢复指标为47.50,高于31.40,重复片段也更少。然而,它的可评估序列输出率只有62.18%,而对照为98.62%。各模型质量分数还来自各自成功输出的子集,并非完全相同的一组提示。
所以,表中的SR不是“功能设计成功率”。pLDDT是预测置信度,注释恢复是计算注释的重合程度,都没有证明蛋白能表达、稳定存在或实现目标功能。BDLM版在这些指标上也仍落后于 AMix2-dLLM,不能笼统称为最强文字蛋白设计模型。
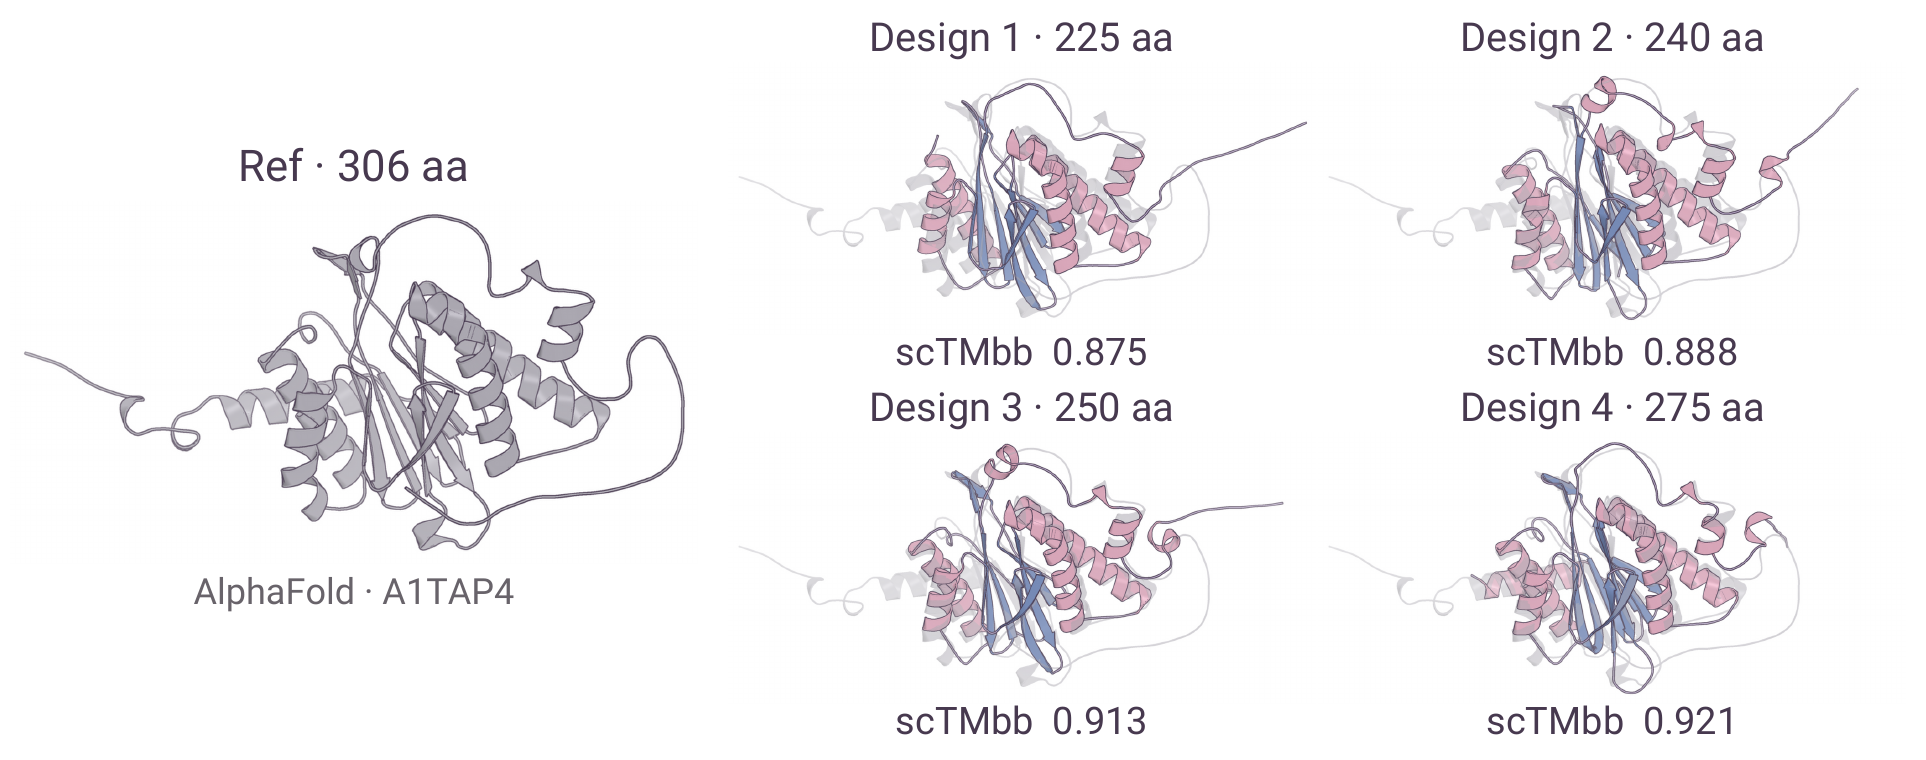
文字也可以直接引导骨架生成,但这部分尚无合适的统一基准,论文主要给出案例。以蛋白酶体亚基PrcB为例,作者展示了225至275个残基的四个设计,结构自洽分数为0.875–0.921。
这个分数来自 ProteinMPNN 配序列、再由 ESMFold 折回,与设计骨架比较,不是与天然蛋白的功能相似度。设计保留了参考折叠并发生局部变化,作者也承认呈现“类似检索”的行为。因此,它支持文字到骨架的可行性,还不足以证明创造了新折叠或有活性的蛋白酶体。
序列与结构,在模型里建立了什么联系
把三种输入放在一起,并不保证模型真正利用了它们之间的关系。作者从内部表示找到两条线索。
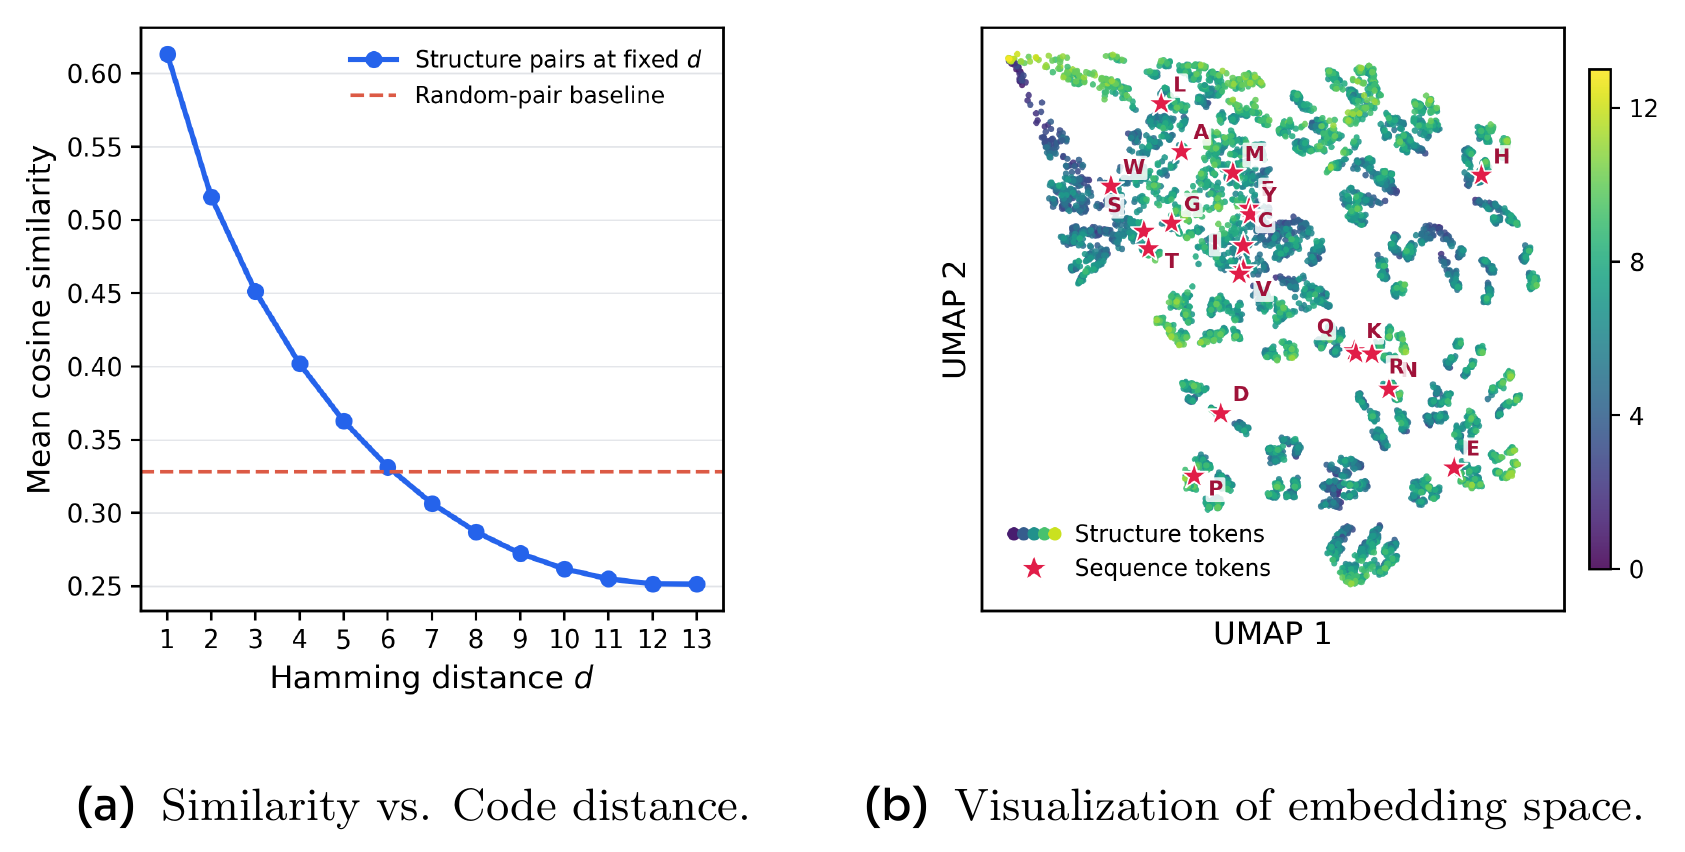
首先,结构编码越接近,其学到的向量通常也越相似;部分氨基酸标记靠近特定的结构标记区域。这说明结构分词器原有的编码关系,没有在接入语言模型后完全丢失。但二维降维图中的邻近关系,不等于模型已经掌握全部折叠物理规律。
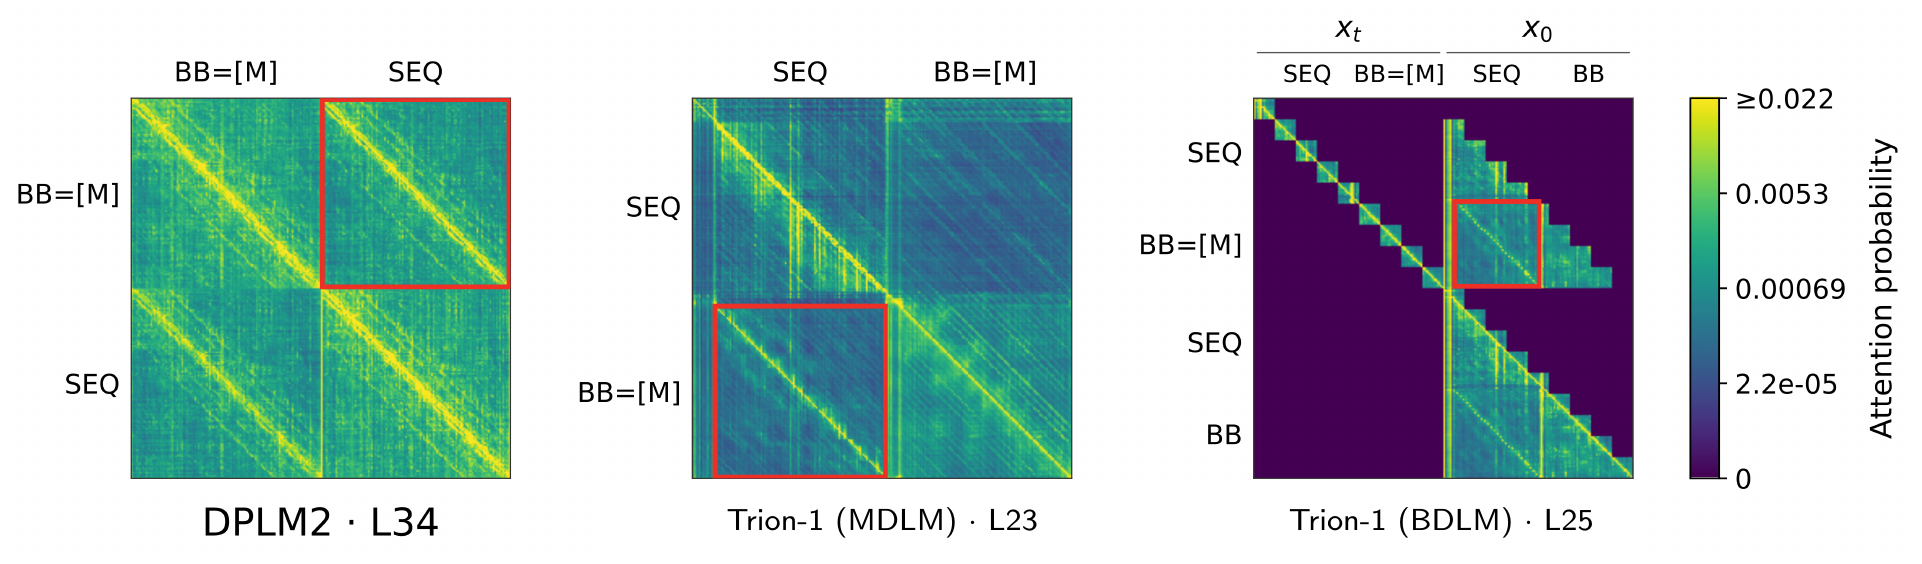
其次,在6WEB蛋白的注意力图中,结构位置会较强地关注相应的序列位置。即使用全局位置编码,这种近对角线模式仍然出现,支持模型学习到了残基层面的序列到结构对应。
这些结果与双向建模有利于折叠的解释相符,但注意力图是描述性证据,不能单独证明性能提升完全由某条机制造成。全局双向版本在序列设计中反而更容易重复,也提醒我们:适合结构推断的生成方式,不一定最适合所有输出任务。
走向统一工具,但还不是全能设计平台
综合来看,Trion-1证明了统一模型的结构能力可以明显增强,同时保留语言交互和跨模态生成。不过,雷达图里的能力并非由一个版本在所有方向上同时实现最优,结构预测也尚未赶上最强专用模型。
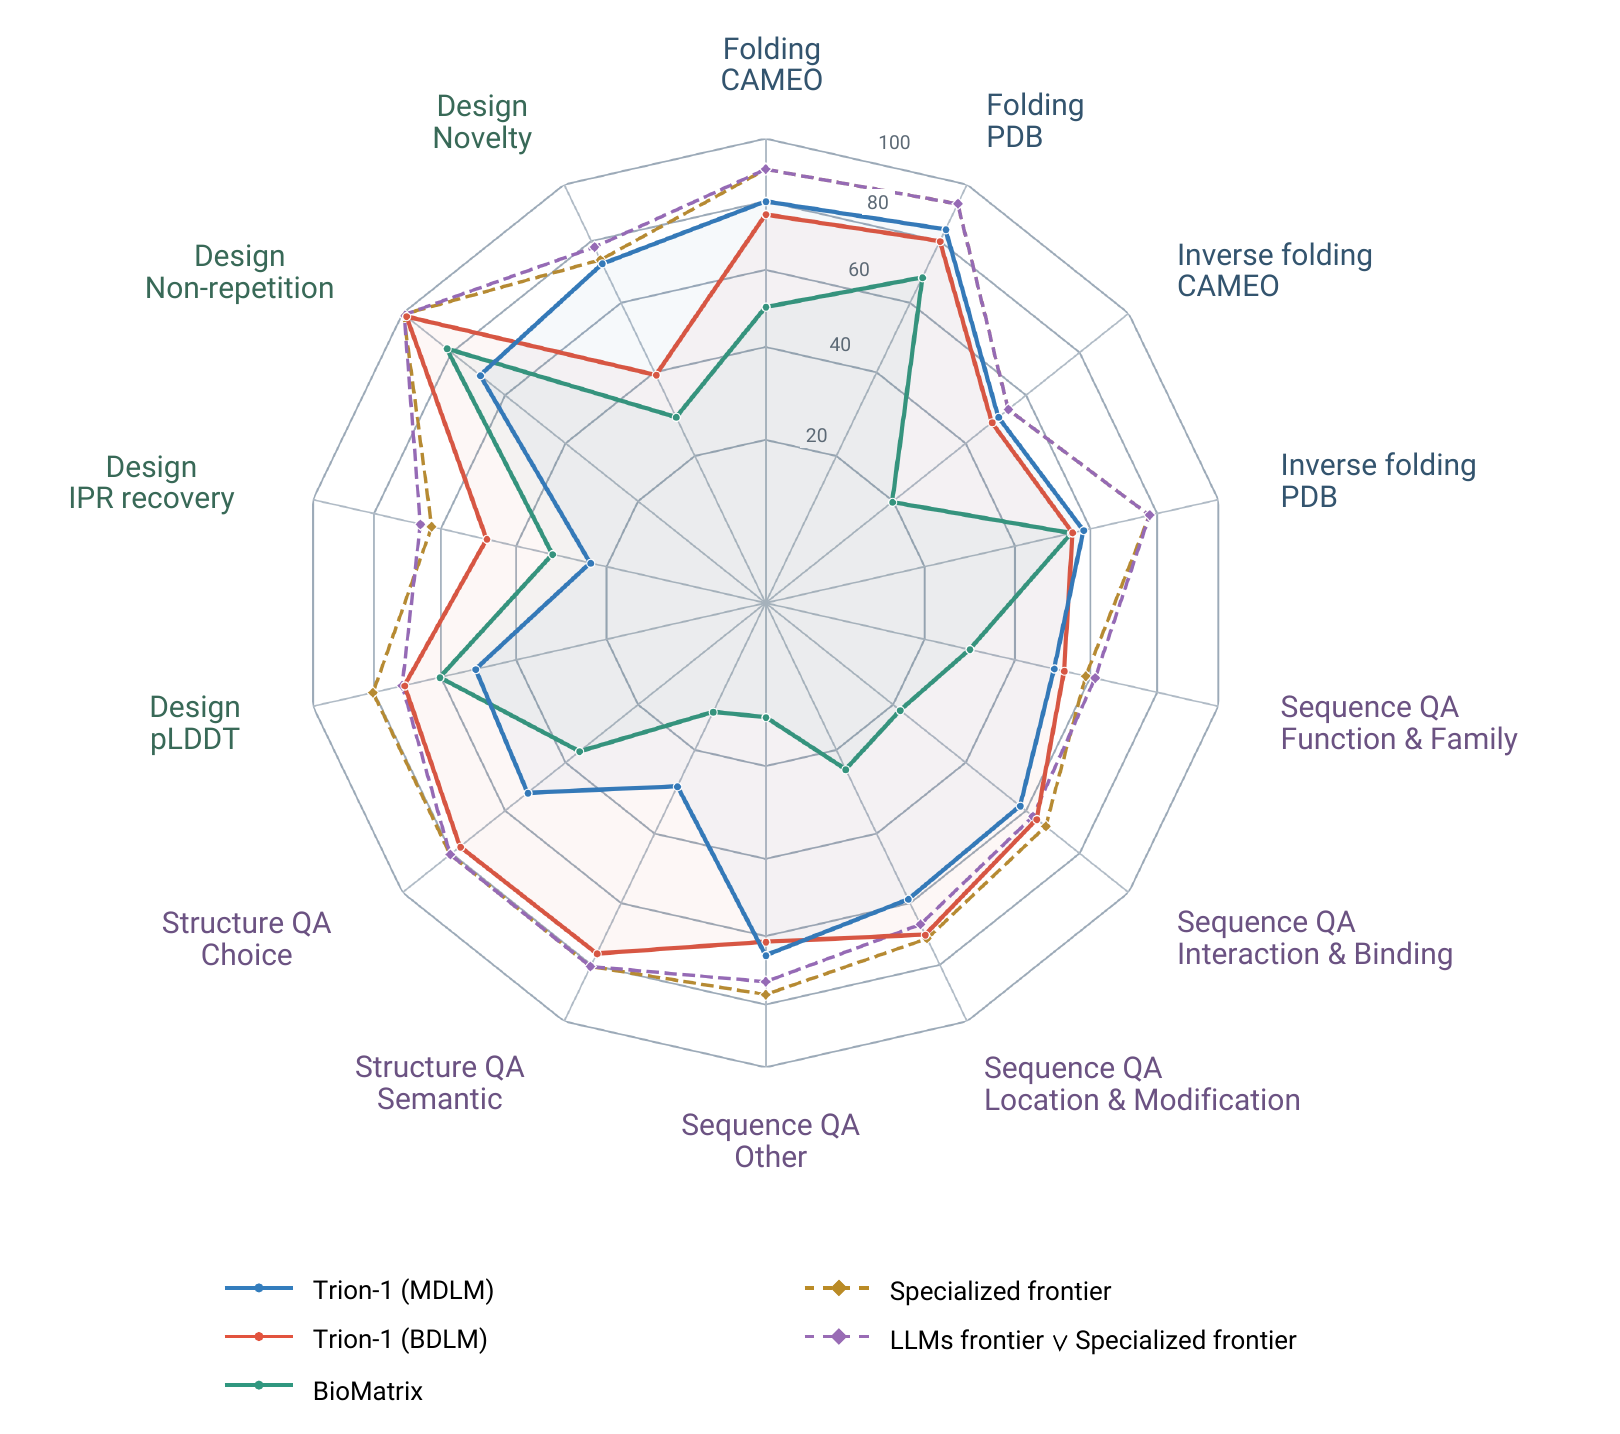
目前研究仅覆盖蛋白本身,尚未延伸到复合物、配体和核酸,也没有报告湿实验功能验证。把“生成、评估、修改”交错起来、借助更多推理计算不断改进设计,是作者提出的下一步,而不是已经完成的自动发现流程。
这篇预印本的价值,是把蛋白语言模型从“解释序列”推向能在序列、骨架和文字之间转换的工具。对使用者来说,值得期待的是少一些工具切换;必须保留的判断则是:能理解设计意图,距离设计出真正可用的蛋白,仍有验证工作要做。
沿着问题继续