BioEmu2: what accelerated molecular dynamics can reveal, and what remains unverified
BioEmu2 combines structure prediction, equilibrium sampling and time propagation. Official demonstrations and author responses explain its potential, while binding rates, membrane-protein dynamics and hardware performance still require validation.
Microsoft Research AI for Science · 2026-10-20
BioEmu2让生成模型开始预测分子接下来怎样运动;一段结合演示和作者的公开问答,说明了它的用途与待验证之处。
预测蛋白质长什么样,和知道它接下来会怎样运动,之间还隔着很长的计算时间。对于结合、开合和构象转换,仅有一张静态结构往往不够。
微软AI for Science团队公开了BioEmu2:一个约5亿参数的全原子扩散模型,支持蛋白质、核酸、配体和多链复合物,并开放代码与权重。它引人关注的演示,是让一条多肽逐渐靠近受体、形成结构并进入结合位点。
作者还报告了一项醒目的结果:生成覆盖5毫秒的轨迹约需40分钟;同一GPU上的传统分子动力学(MD)成本被估计为超过10年。这组数字对应给定体系与设置。要理解加速带来了什么,先看画面,再看它如何产生这些画面。
先看这段演示:多肽如何结合受体
看视频时,可以追踪金色的PUMA多肽:起初位于受体外侧,随后靠近并进入凹槽,逐步形成螺旋。后段叠加灰色NMR参考结构,展示生成构象与实验结构的对应关系。
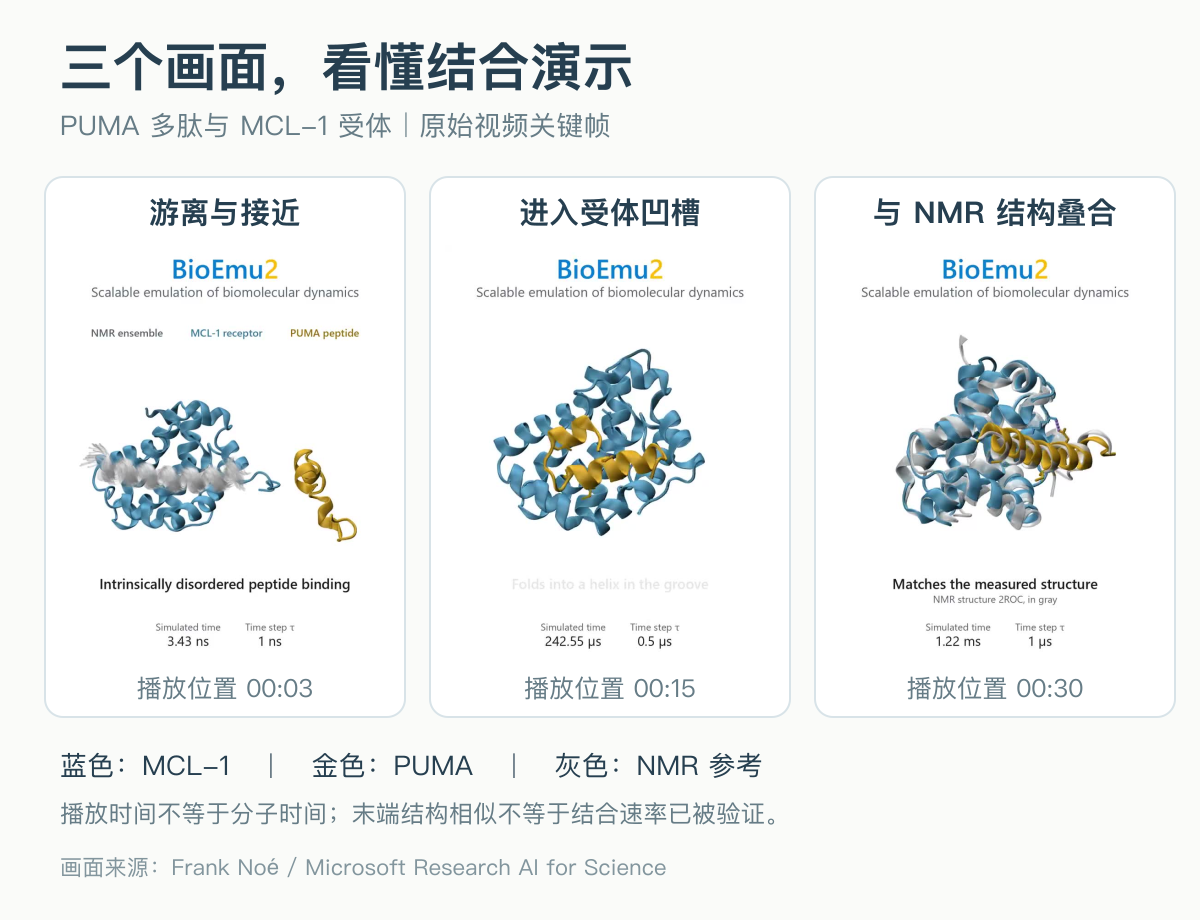
这段演示同时包含两种时间:播放器走过几十秒,画面底部的“Simulated time”则表示生成轨迹对应的分子时间。“Time step”是模型推进的间隔,视频中会随展示阶段变化。末端结构与NMR参考相似,并不能单独证明结合速率准确。这也正是后面评论区追问的重点。
一套模型,三种不同的输出
理解BioEmu2,先分清结构、构象集合和轨迹。三者都可以画成分子动画,科学含义却不同。
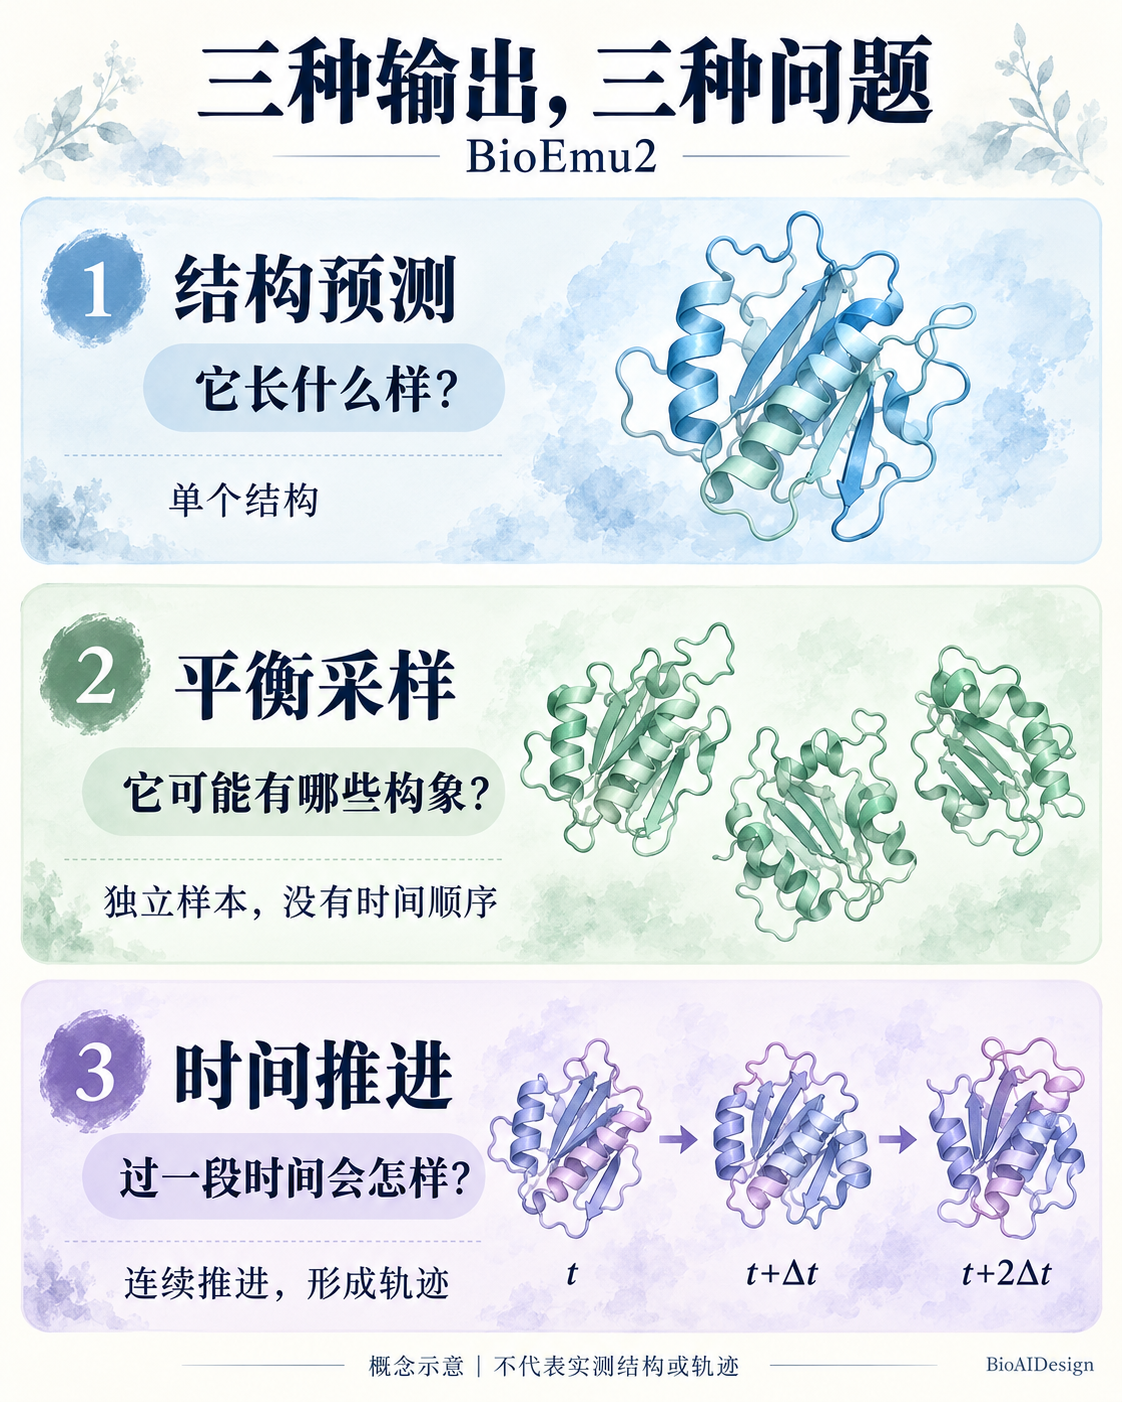
结构预测回答“它可能长什么样”,倾向得到清晰的折叠结构。平衡采样回答“它可能有哪些构象”,返回一组独立样本,排列顺序没有时间含义。时间推进则给定当前结构与时间间隔,采样未来状态;连续调用,才组成有先后关系的轨迹。
模型接收已有分子组成或序列,本身不负责设计新的氨基酸序列。把独立样本依次播放,也不能把平衡采样变成动力学模拟。
40分钟的加速,跨过了哪些计算
传统MD沿着时间轴,以大量微小时间步逐步积分。BioEmu2使用隐式转移算子(implicit transfer operator),学习在给定时间间隔后,体系可能到达什么状态。
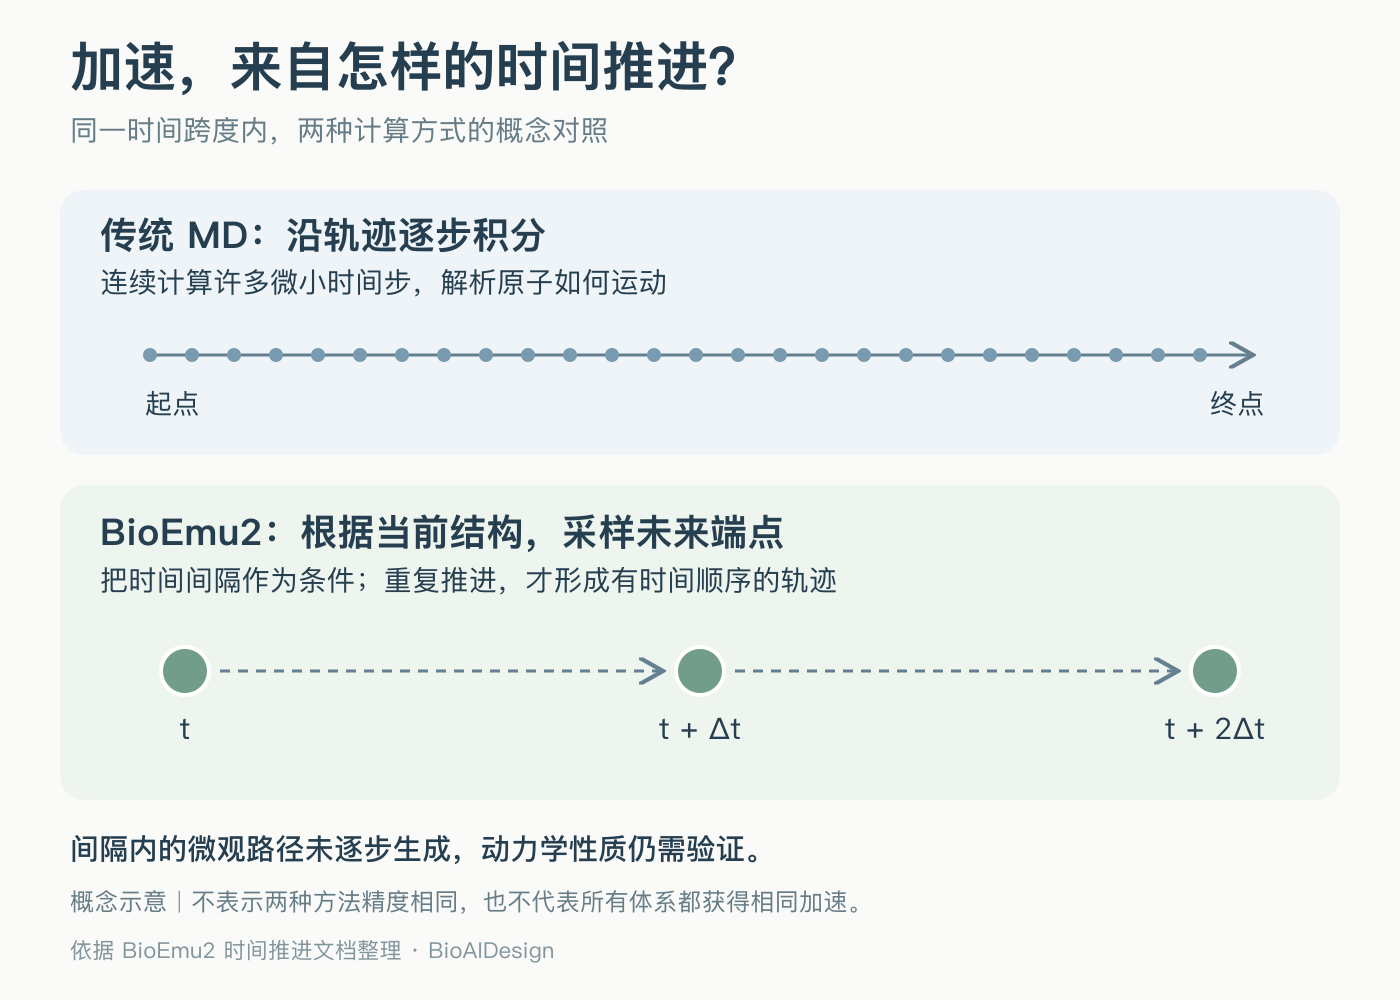
可以把它理解为:当前结构加上“往后走多远”的条件,生成下一站,再从下一站继续。加速来自这种跨步预测;间隔内每一个原子如何移动,并没有逐步计算并输出。
发布帖以PUMA–MCL-1体系、5微秒推进间隔、5毫秒总时长说明加速,并据同GPU的传统MD成本估算给出超过十万倍的数字。这属于作者的特定演示与估算,不能外推为所有MD任务的实测性能。
官方文档常规建议的推进间隔是1–1000纳秒,对应训练中较常见的范围;发布示例使用的5微秒更长。因此,能跨更大一步与跨步后仍保留正确的动力学统计,需要分别检验。
配体加入后,蛋白质的开合怎样改变
腺苷酸激酶的例子,把“生成一组构象”的用途讲得更具体。它催化ATP与AMP转化为两个ADP,口袋开合与底物结合密切相关。
作者展示:未结合配体时,模型可采到打开与闭合状态;加入ATP后,较大的口袋闭合;再加入AMP,两处口袋都趋于闭合。
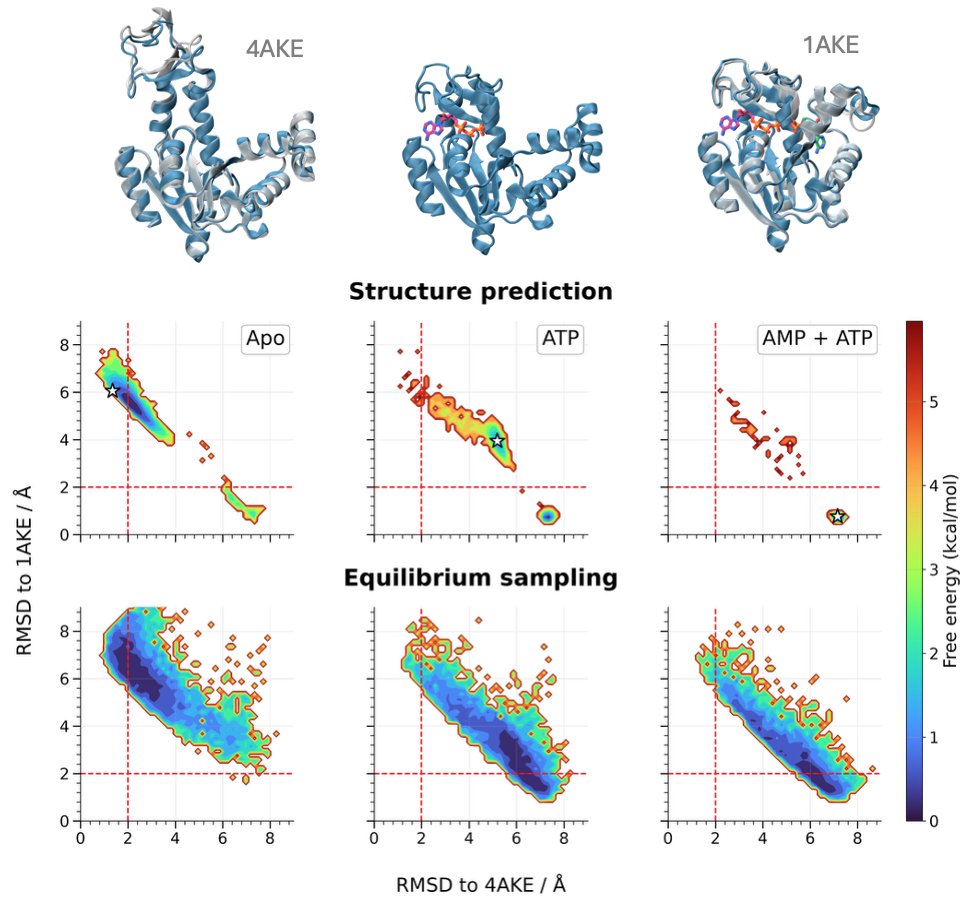
读这张图,先横向比较三列:它们改变的是配体条件。再纵向比较中、下两排:结构预测更集中,平衡采样覆盖更宽的区域。
横轴是相对开放参考结构4AKE的偏差,纵轴是相对闭合参考结构1AKE的偏差,单位均为埃。越靠近某一轴的低值,表示越接近对应参考。颜色展示作者按采样分布绘制的自由能形式,并非对所有新体系都已校准的实验自由能。
这类结果的价值,是把“加入配体后可能偏向哪类构象”变成可比较的输出,而不只展示一张闭合结构。
与MD接近,具体接近在哪里
作者报告,在给定平衡采样基准中,相对MD参考的自由能曲面误差约为1 kcal/mol,结构覆盖率约50%–100%。理解这些结果,需要同时看分布偏差与状态覆盖。
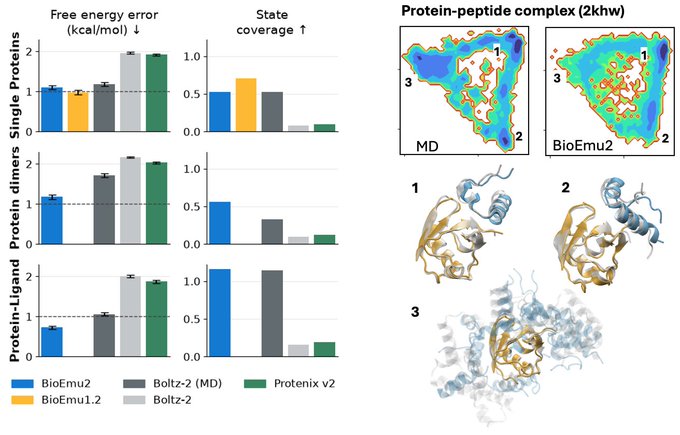
左侧第一列是自由能误差,越低越好;第二列是状态覆盖,越高越好。右侧则把MD与模型的二维分布放在一起,下方列出三个代表构象。关注点不只是能否生成这些形状,还包括是否找到多个区域,以及区域的分布是否相似。
但公开模型卡明确提醒:采样频率不能直接当作已校准的玻尔兹曼概率或定量自由能,结合亲和力与绝对自由能也不属于已验证用途。测试体系上复现MD分布特征,距离给任意新靶点报出可靠的结合常数,还有一步验证。
评论区的关键问题,作者怎样回答
以下为作者公开回复的中文转述,结合官方文档补充说明。相关原始回复分别讨论了结合速率、GPCR、游戏显卡和训练规模。
能预测结合和解离速率了吗?
Woong问:预测的结合、解离速率是否与实验比较过?
Noé回答,模型尚未用实验结合速率微调,还需要方法开发,当前的on/off rates很可能尚不可靠。他把现阶段定位为可继续微调的基础模型。
看到“结合发生了”,与知道“结合多快、停留多久”,对应不同的验证目标。演示可以启发机制假设,定量速率则需要专门校准。
GPCR等膜蛋白可以用吗?
作者说,训练包含膜蛋白结构,但没有相应的膜蛋白MD;他们尚未测试GPCR。他推测可能得到合理结构,对动力学表现则不确定。
因此,GPCR活化或构象切换仍需独立评测,不能从输入支持推导出动力学已经可靠。
4090能跑吗,速度取决于什么?
面对游戏显卡和双精度的询问,Noé表示应该不需要FP64,但尚未测试游戏显卡性能。README要求Linux和NVIDIA GPU;不需要双精度,并不等于4090已经实测可用。
官方耗时图进一步说明:速度还随体系大小和所需样本数变化。
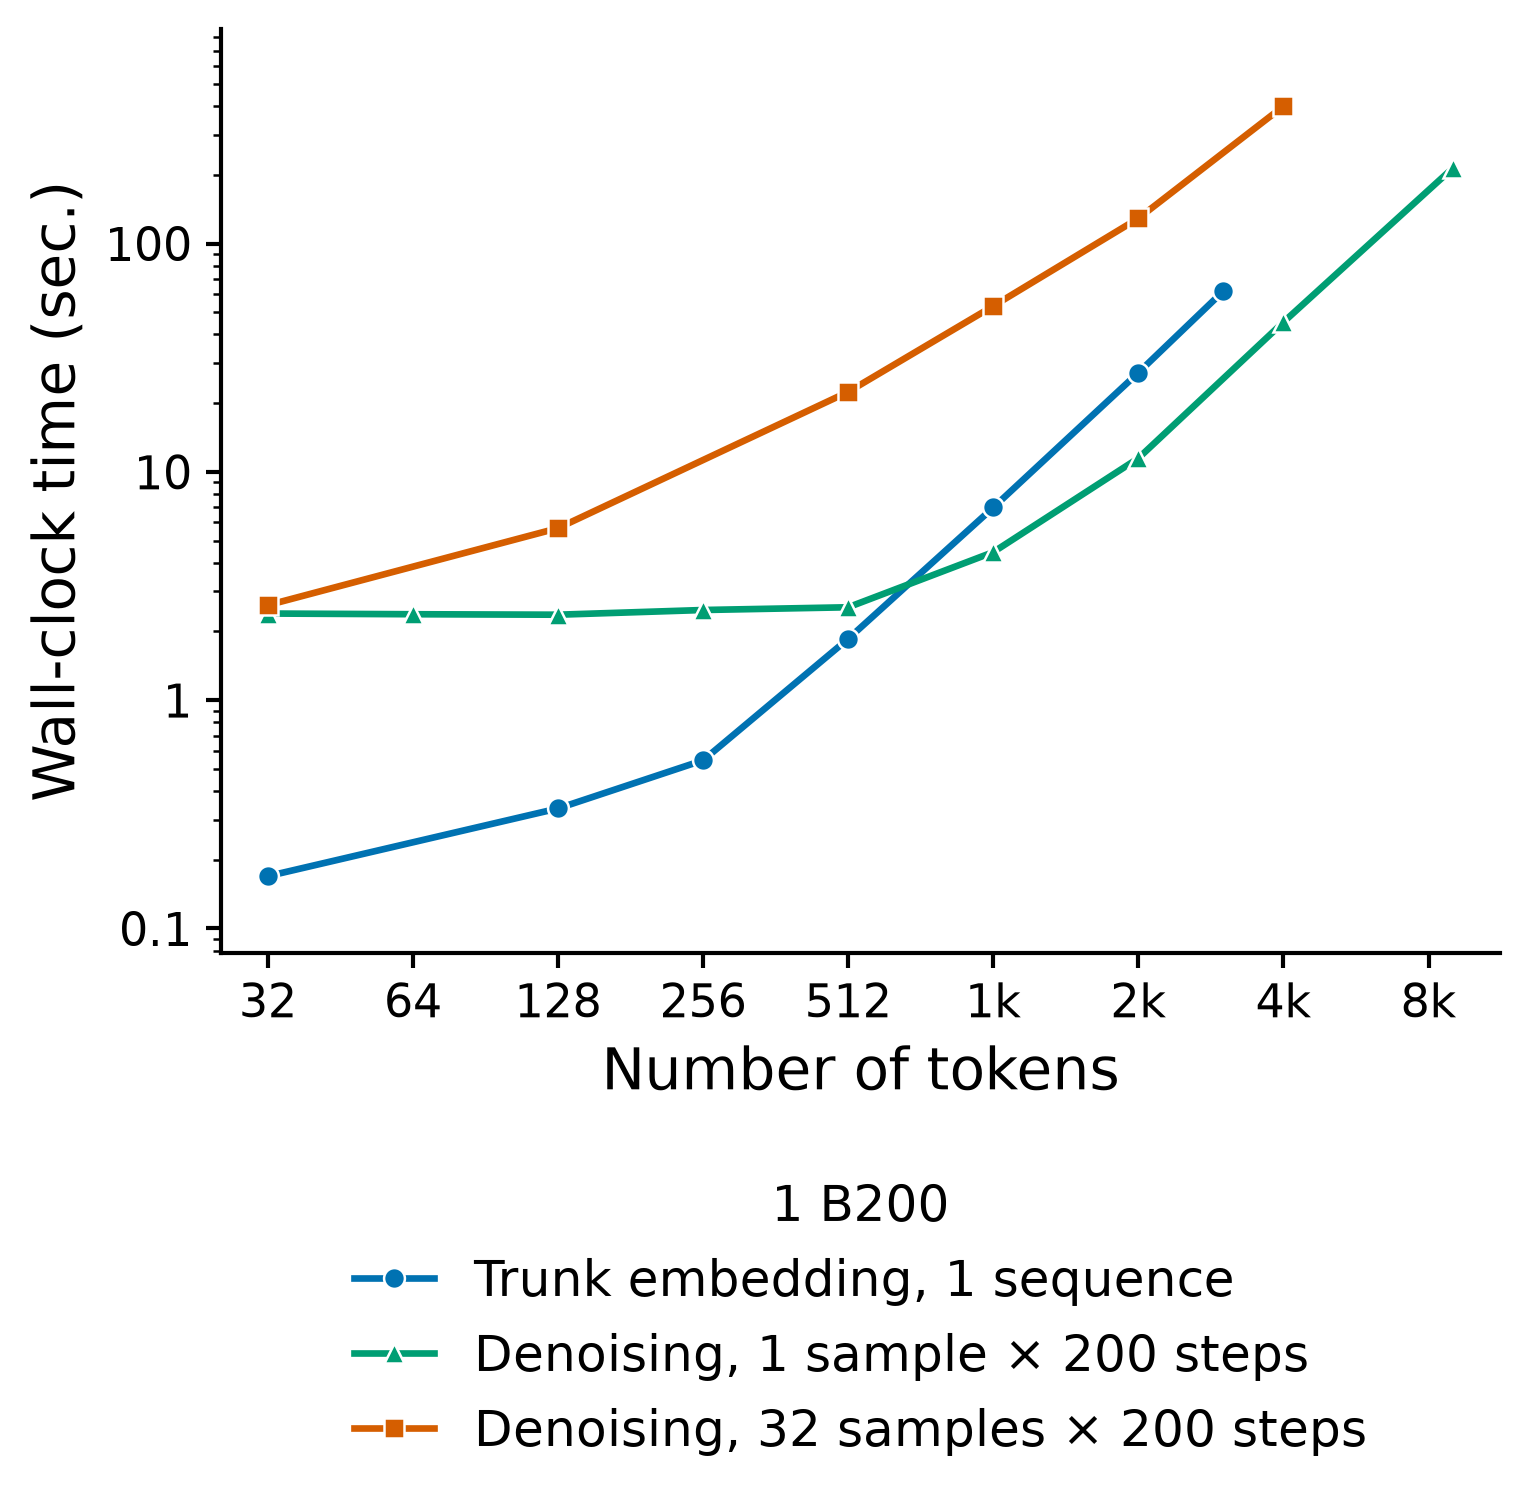
蓝线对应每个体系的主干特征计算,绿线和橙线对应后续采样。小体系的32样本批次并不需要单样本的32倍时间;当体系变大,两条去噪曲线都明显上升。批处理可以提高吞吐,但这张图测的是B200上的特定计算阶段,不能拿来承诺4090的运行时间。
训练究竟用了多少MD?
Gina El Nesr追问模拟规模,以及是否包含结合与未结合状态。作者以玩笑回应,没有在这条回复里给出可引用的总时长。模型卡列出多个MD数据集与系统数,也包含apo/free类别;系统数量不能换算成总模拟时长。
开源以后,值得先验证自己的体系
截至原稿核查日(2026年10月20日),BioEmu2处于公开预览阶段,仓库提供v0.1.0rc0预发布版本,默认权重为bioemu2-preview,代码与默认权重标注MIT许可,第三方组件另有说明。
准备尝试时,可以从已有实验或MD参照的小体系开始。先明确需要的是结构、构象集合还是时间相关行为,再固定模型与采样条件,检查是否复现已知差异。文档还提醒,不合格构象可能仍保留在输出中,需要另行检查和剔除。
从生成一个结构到预测一段运动,研究者获得了更多可检验的假设。接下来的关键,是把漂亮演示放回具体问题:构象是否合理、分布是否可信、速率是否经过验证。
来源与资源
内容依据微软官方仓库、模型卡、Frank Noé的发布内容及公开问答整理,资料核查日期为2026-10-20;本站发布于2026-10-21。视频与原始数据图来自作者团队;中文示意图为编辑整理。本文未独立运行模型或复现加速结果。
| 资源 | 内容 | 链接 |
|---|---|---|
| 代码与文档 | 官方实现、安装及使用说明 | https://github.com/microsoft/bioemu2 |
| 模型权重 | 官方公开预览权重 | https://huggingface.co/microsoft/bioemu2 |
| 模型卡 | 训练数据、评测与适用边界 | https://github.com/microsoft/bioemu2/blob/main/MODEL_CARD.md |
关键词
#分子动力学 #蛋白质结构 #生成模型 #AI4Science #BioAIDesign