CLEAN Database: finding candidate enzymes across over 55 million sequences
CLEAN Database connects enzyme-function predictions for over 55 million protein sequences with search, filtering, and mutation scoring. A guide to its uses and the limits of prediction confidence and ESM-2 scores.
找酶、查功能、筛候选,CLEAN 有了数据库版。2026年10月15日,伊利诺伊大学厄巴纳—香槟分校赵惠民团队在 Nucleic Acids Research 发表 CLEAN Database,将酶功能预测做成可直接检索、筛选和下载的开放资源。
从模型到5500万条序列
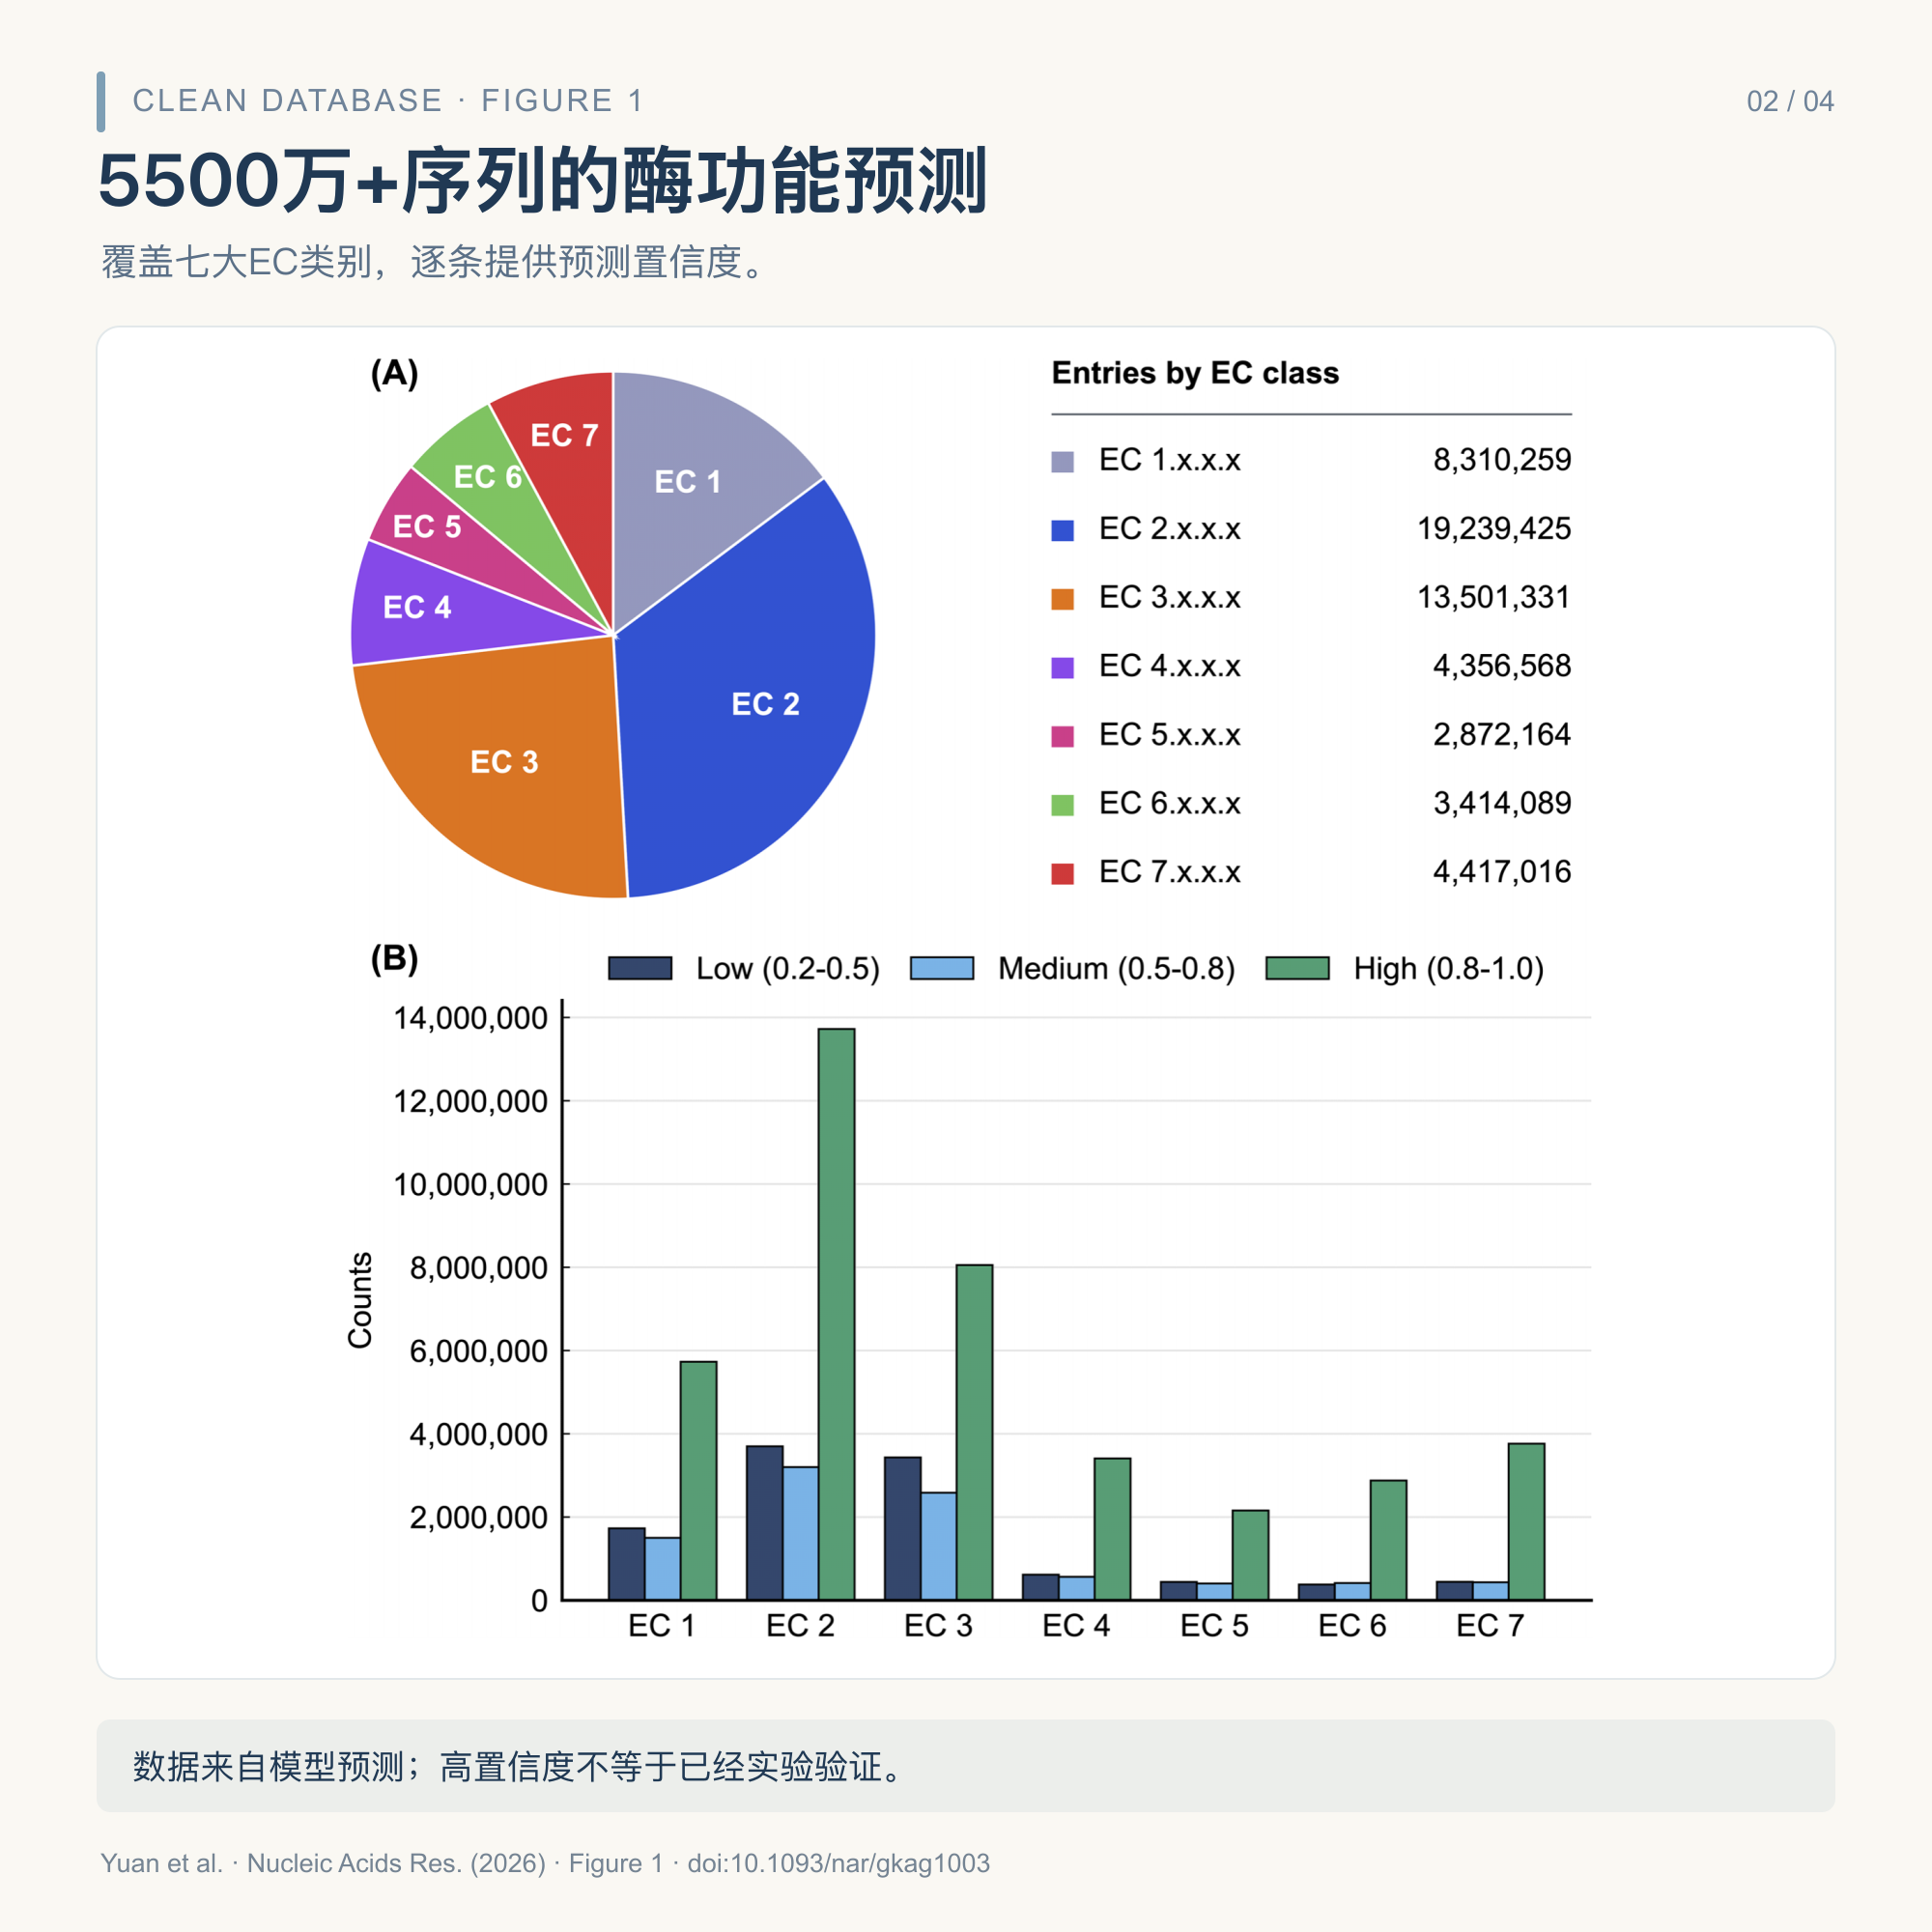
CLEAN 最初发表于2023年的 Science,通过对比学习预测酶的 EC 功能分类。本次研究从 UniProt 超过2.5亿条蛋白序列出发,经置信度与序列长度过滤,最终收录超过5500万条序列的功能预测,覆盖七大 EC 酶类别。
这里的规模指带有预测功能注释的序列,不是5500万个经实验验证的酶。置信度可以帮助排序与筛选,但高置信度仍不等于已经获得实验验证。
按功能找候选酶
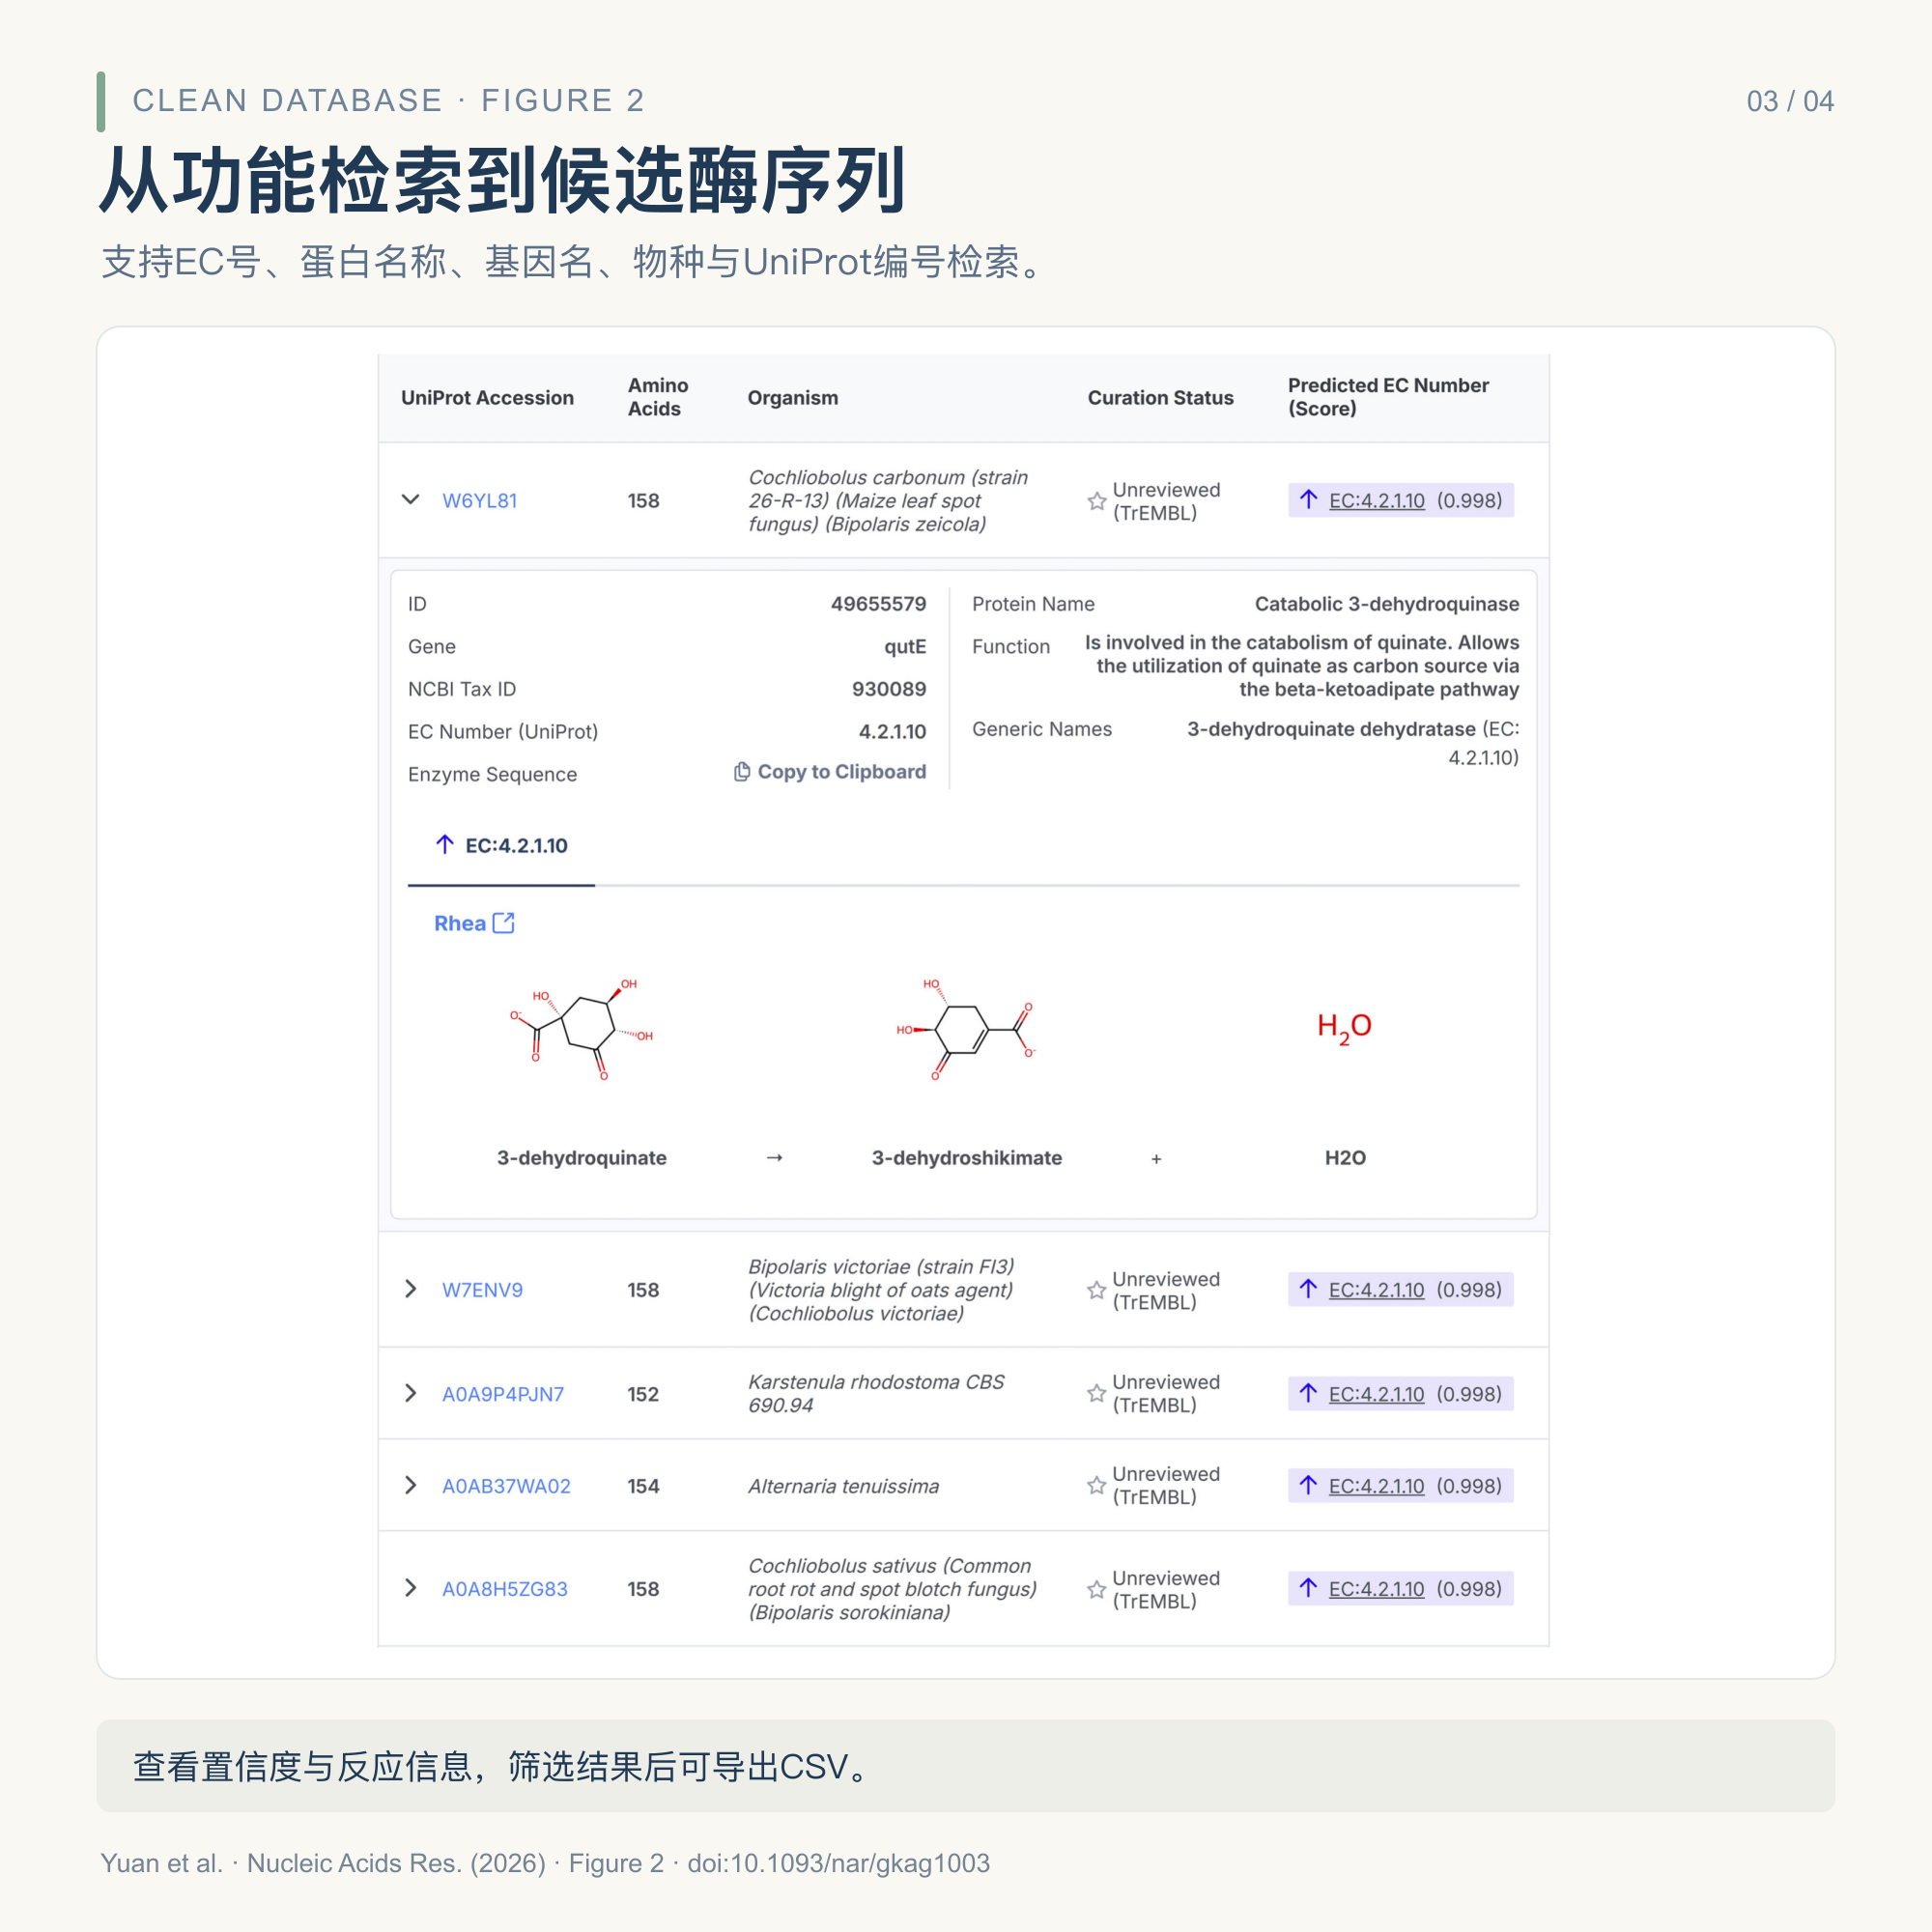
数据库支持 EC 号、蛋白名称、基因名、物种与 UniProt 编号检索。结果中可以查看预测功能、置信度、蛋白序列,以及可用的底物和产物信息;还可以按物种、置信度等条件筛选,导出 CSV 继续分析。
已知目标反应的 EC 号时,可以先检索不同物种的候选酶,再结合序列特征和预测置信度缩小实验范围。数据库无需登录即可访问,也提供 API 供批量查询。
把突变评分放回结构中看
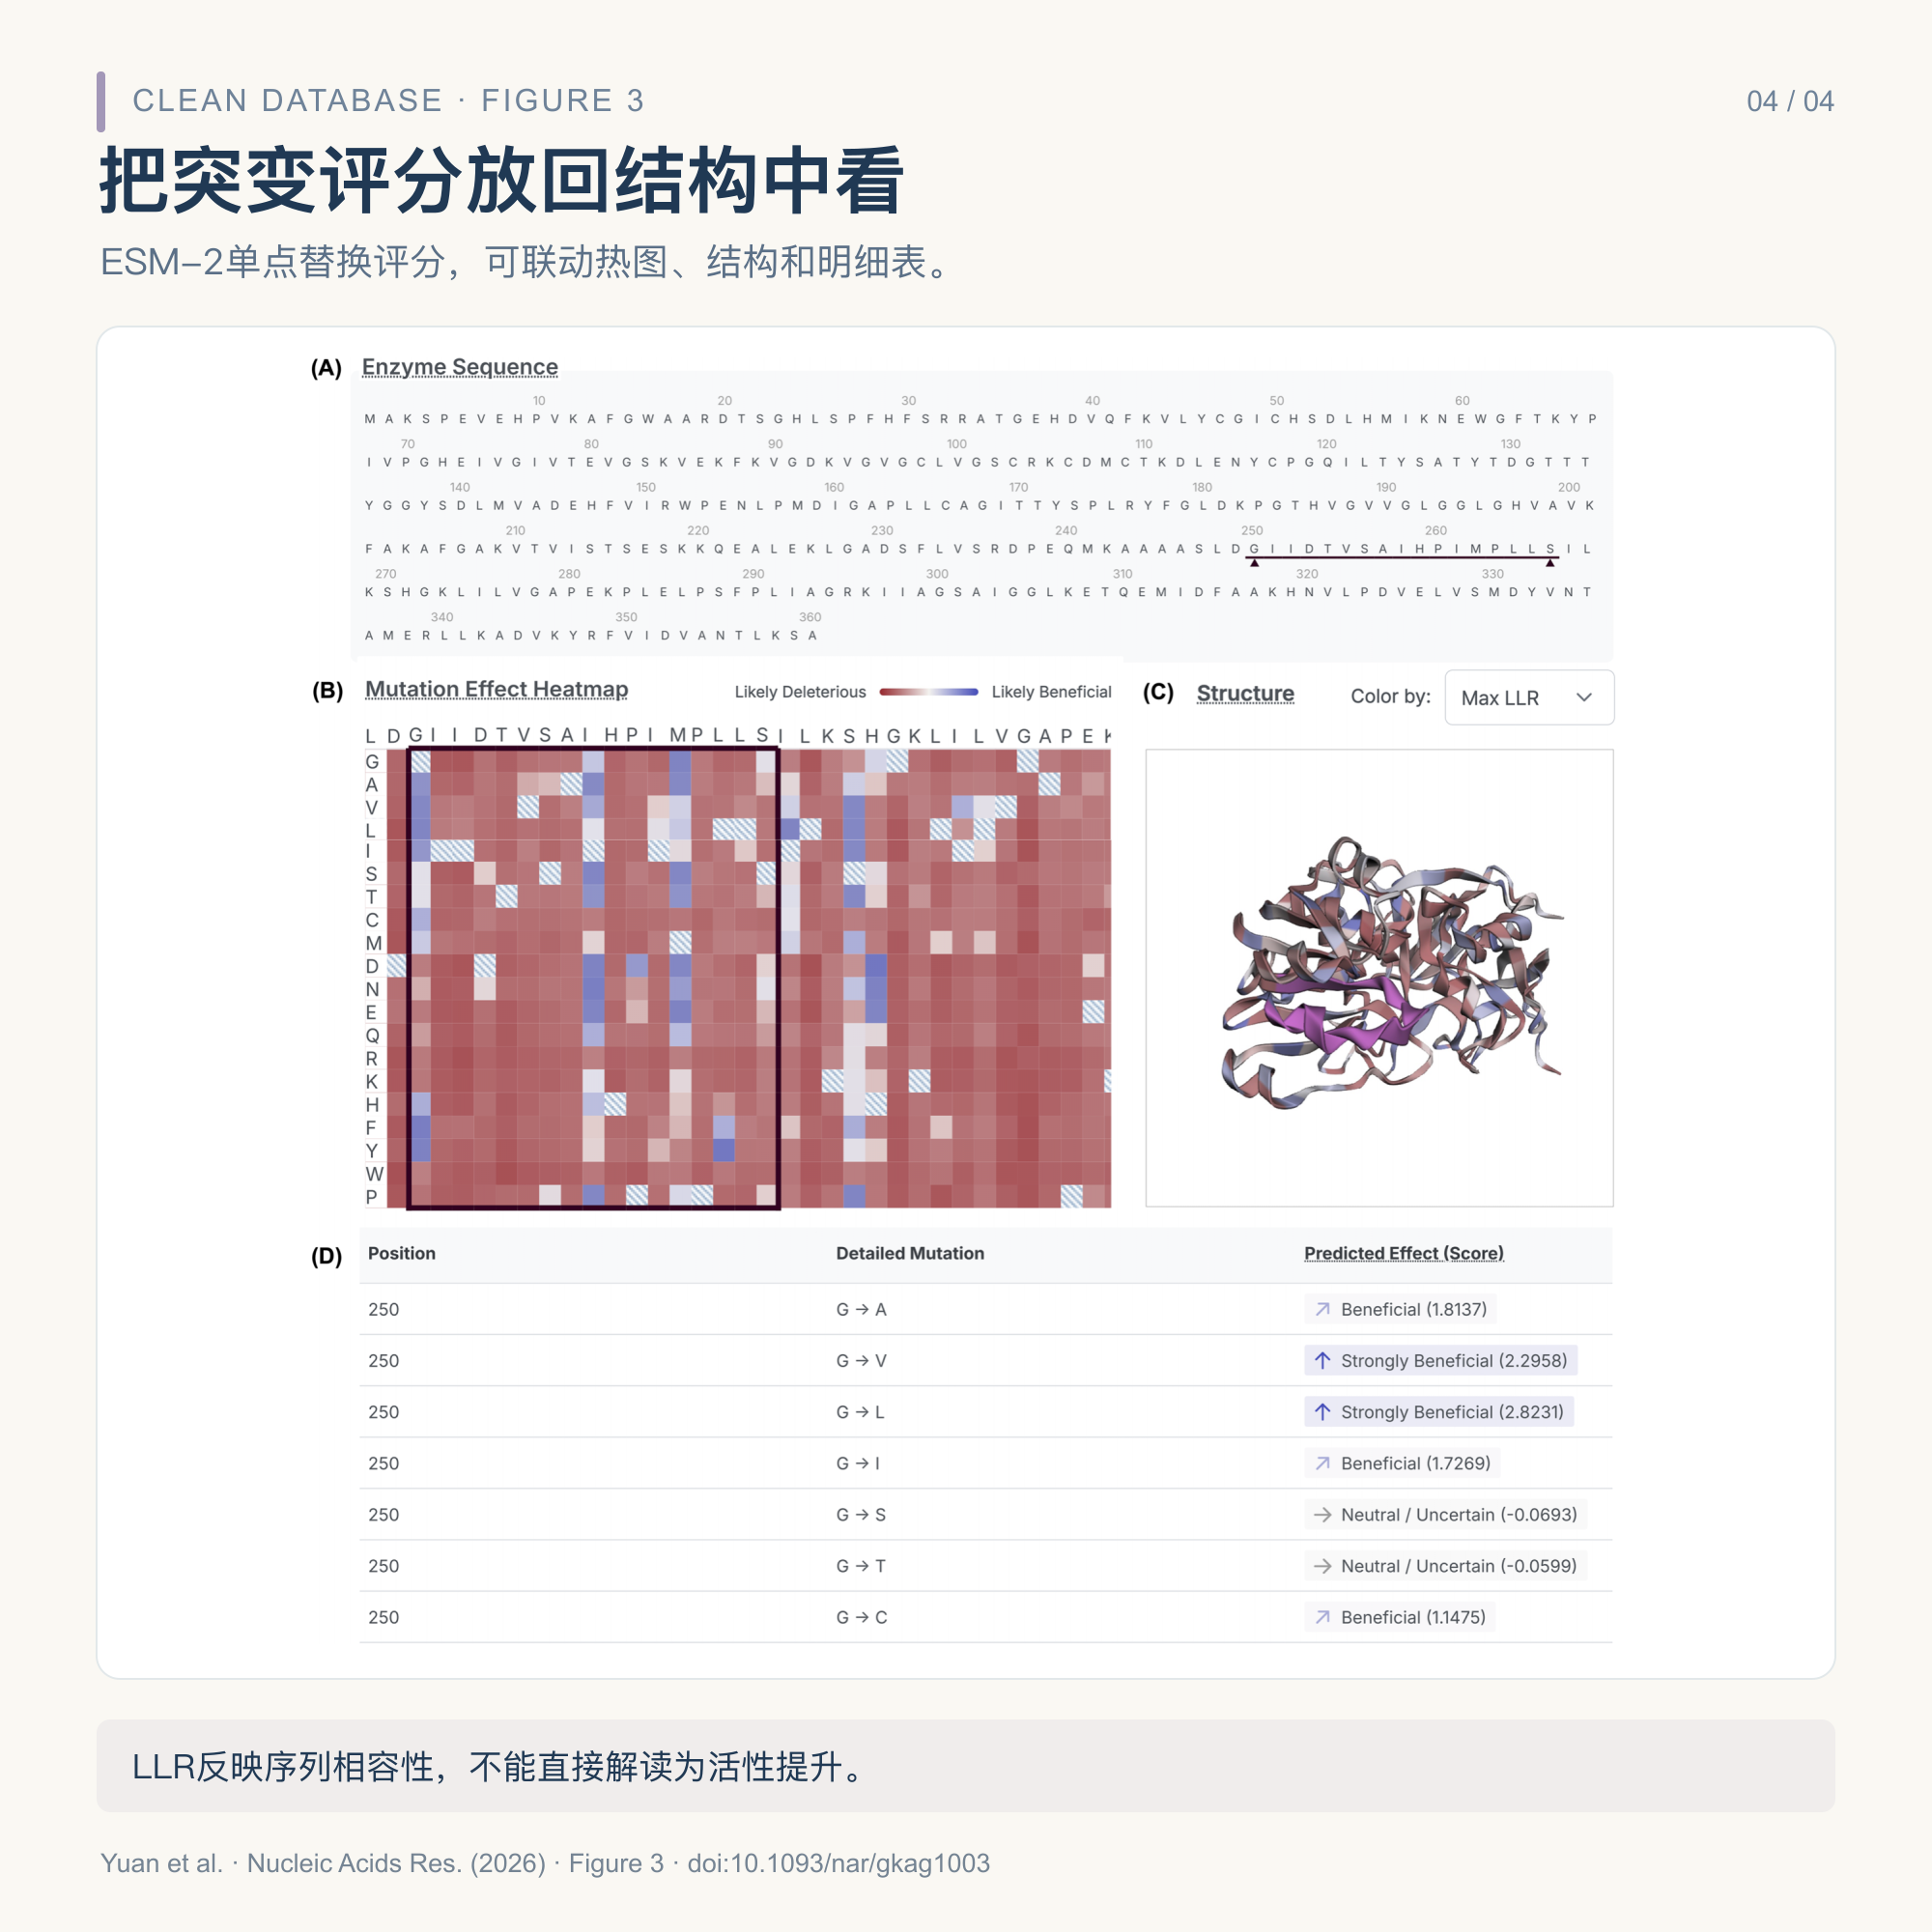
输入一条蛋白序列,平台可用 ESM-2 评估单点氨基酸替换,通过热图、三维结构与明细表联动展示。研究者可以结合催化残基、底物结合口袋等信息,挑选值得实验测试的突变。
需要区分两种评分:EC 预测置信度用于评估功能注释的可靠程度;ESM-2 的 LLR 主要反映模型学习到的序列相容性。LLR 高分不能直接当成酶活性提高,也不能替代突变后的功能测定。
来源与使用边界
CLEAN Database 适合作为候选酶检索和突变库规划的入口。关键候选仍应回到原始注释、研究文献与实验验证,不宜仅凭数据库分数作功能定论。
- 论文:CLEAN Database: providing enzyme function coverage for over 55 million sequences
- CLEAN Database 官方入口
- 数据库 API 文档
- Molecule Maker Lab 官方介绍
论文图以非商业科普解读用途按 CC BY-NC 4.0 使用,作者署名、论文链接与许可链接保留在对应图注中。本网页沿用已完成的图文排版,将图片无损转换为 WebP;未裁切原图数据或重新绘制结果。