专题综述 | AI虚拟细胞,离“在计算机里养一个细胞”还有多远
从细胞基础模型到全细胞机制模拟,从形态、代谢、空间互作到组织与胚胎,梳理虚拟细胞的研究进展、公开数据、代码平台和比赛,辨析已验证能力与发展目标,并附参考文献与上手路径。
BioAIDesign · 资料整理截至 2026-09-30;本网站发布于 2026-10-21。
从识别细胞到预测变化,从单细胞表达走向形态、代谢与组织发育,虚拟细胞的研究目标正在扩大。
把一份真实的细胞样本交给计算机,我们希望得到什么?辨认它属于哪种细胞,预测一次敲除后的表达变化,推断它将分化成什么,生成它在显微镜下的样子,还是让它在虚拟培养皿里持续生长、交流和分裂?这些问题都有人在做,但它们需要的数据、模型和实验验证并不相同。
2025—2026年,亿级单细胞语料、大规模药物与遗传干预数据、空间蛋白模型、最小细胞的四维机制模拟,以及面向胚胎发育的公开赛事接连出现;调控、代谢、形态和发育也各自形成了研究路线。本文先沿时间线回顾关键节点,再按具体问题梳理模型、机制、资源,以及每类结论目前验证到哪一步。
本文依据公开论文、预印本和官方文档整理,没有运行任何模型,也不声称穷尽全部文献。模型名称、数据规模和赛事状态均以文中注明的版本为准;方括号数字对应文末参考文献。
图表可点击查看原尺寸。
从一个表达向量到一个细胞
“虚拟细胞”在不同论文里指的东西并不一样:可能是一种细胞表示,可能是专门的干预预测器,可能是一组可组合的机制模型,也可能是能执行多步虚拟实验的系统。读一项工作,先要弄清它维护什么状态、怎样更新状态、给出哪些读出,又在什么条件下接受过检验。
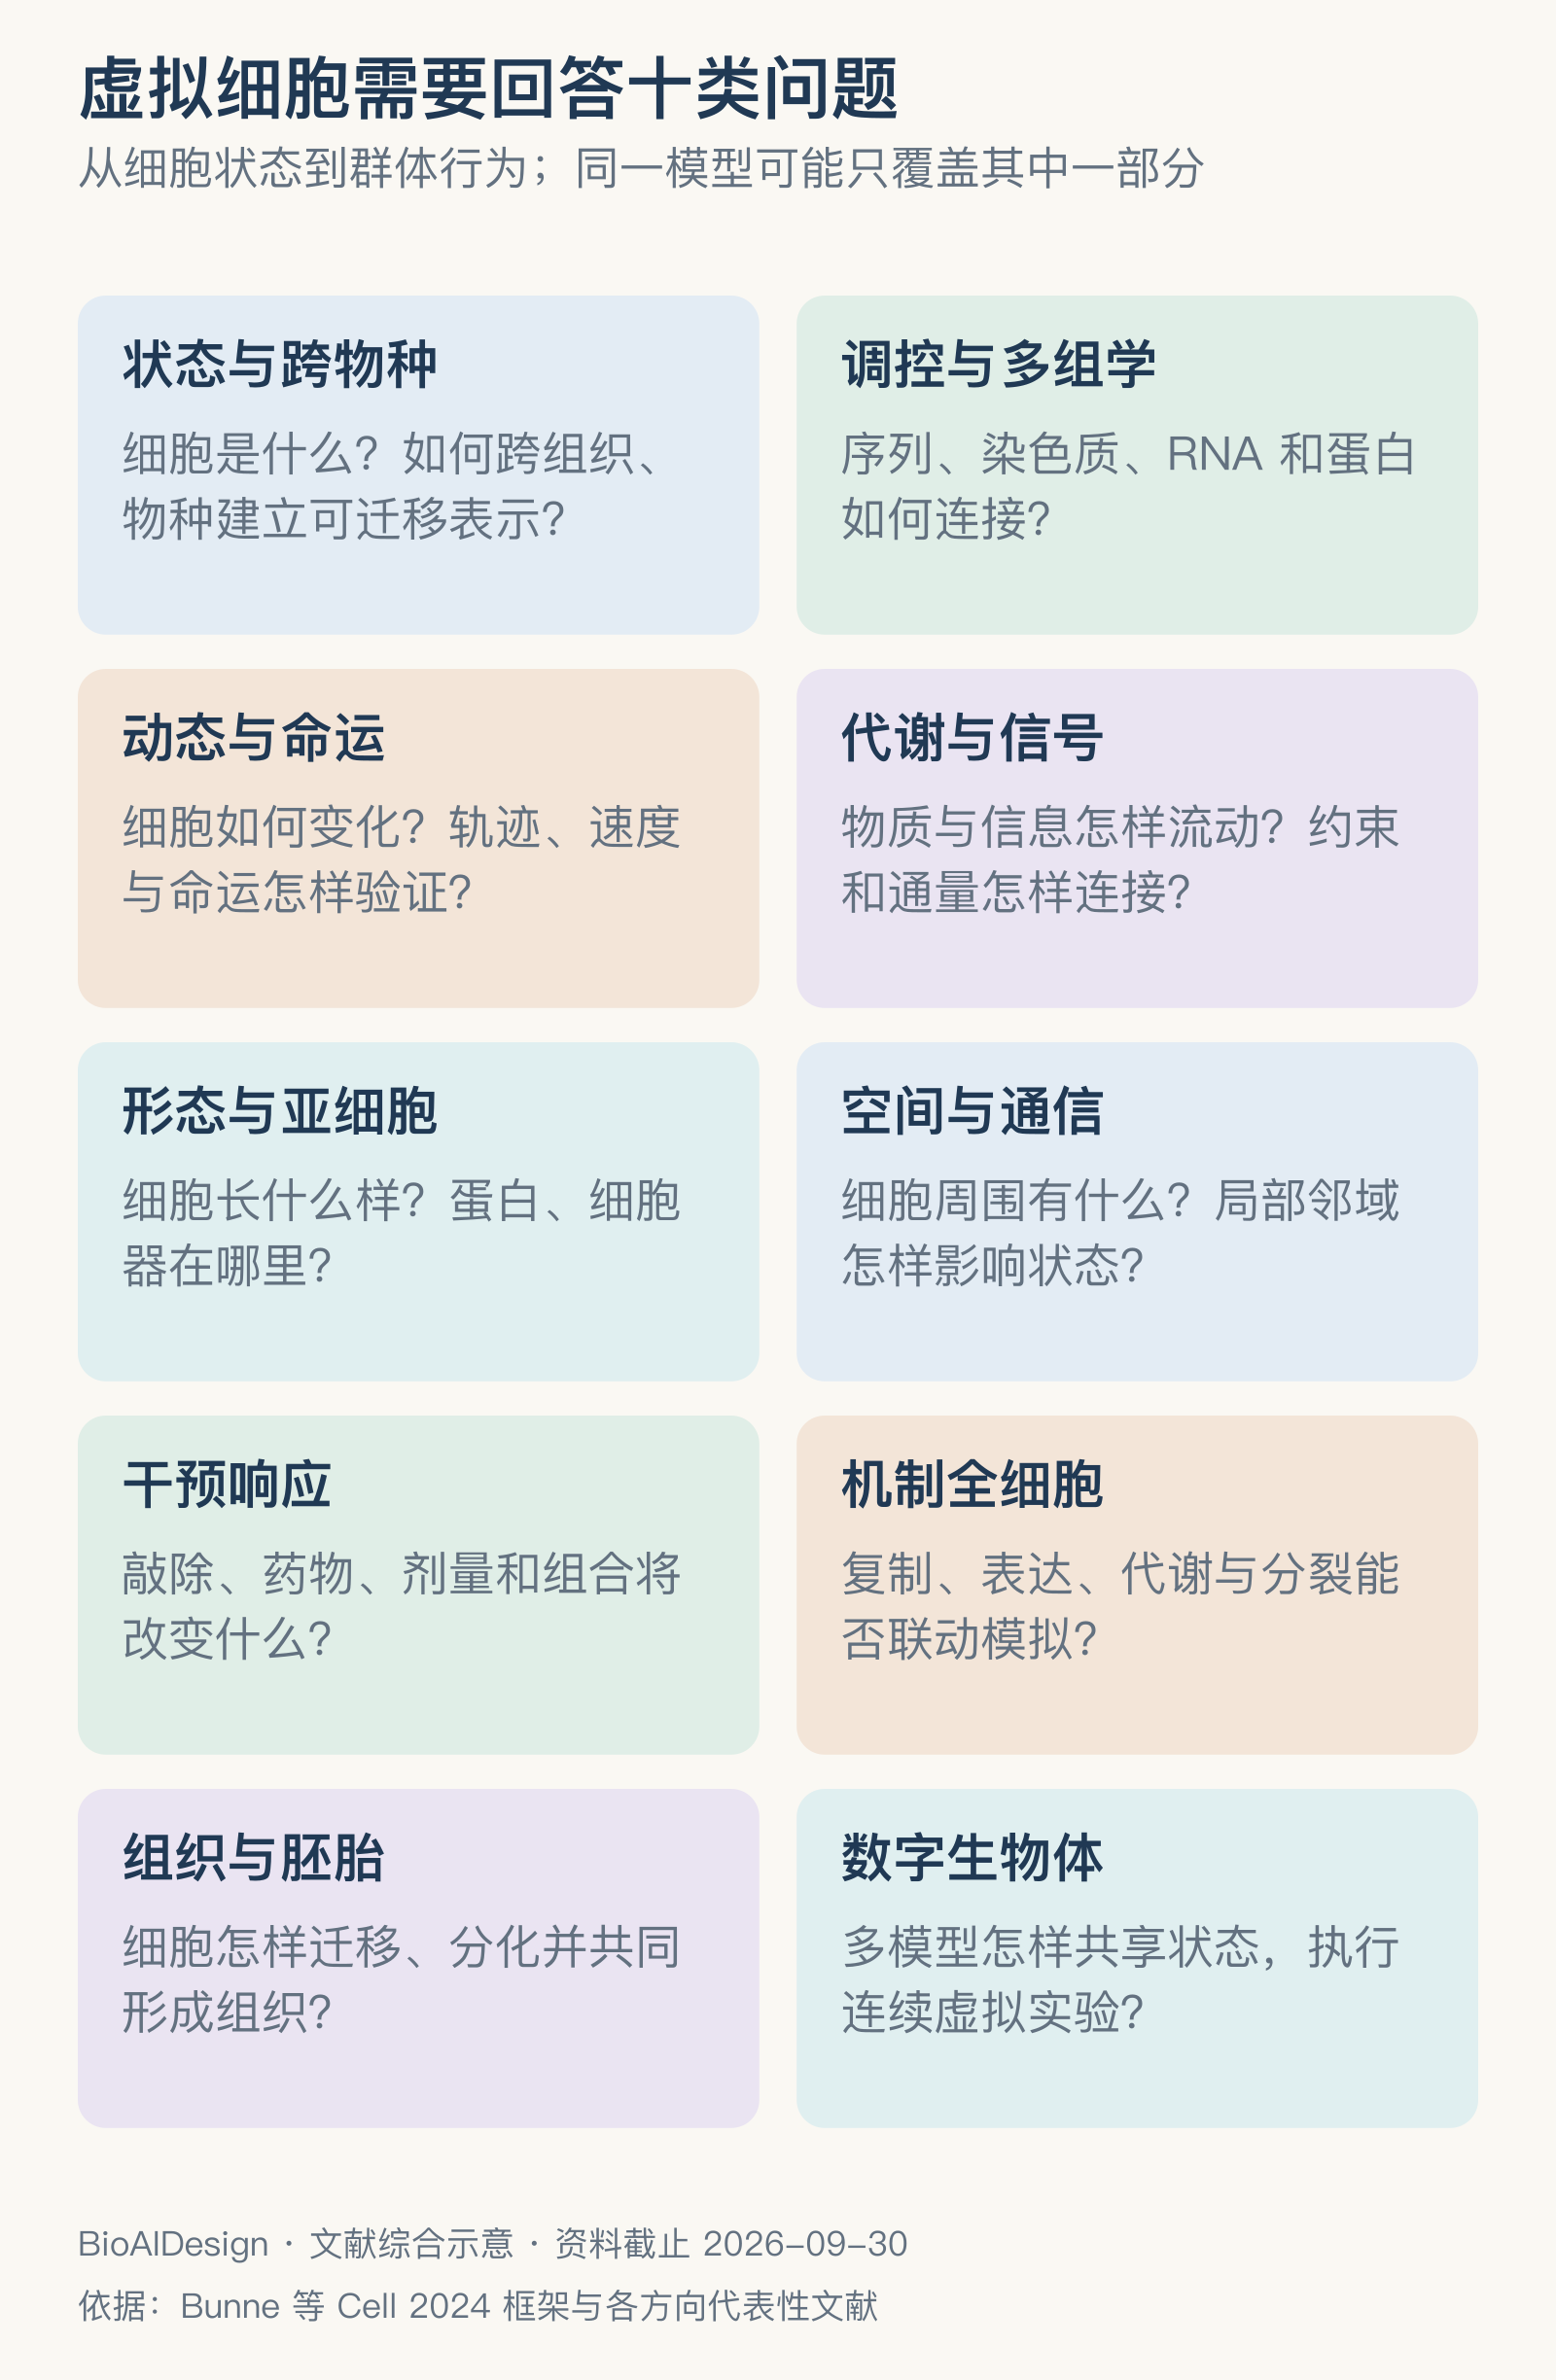
当前研究大致可以归为十类问题:状态与跨物种、调控与多组学、动态与命运、代谢与信号、形态与亚细胞、空间与通信、干预响应、机制全细胞、组织与胚胎,以及数字生物体与实验运行。它们在生物学上彼此相连:调控影响表达,表达和蛋白参与代谢,营养与信号影响命运,细胞的运动和分裂又会改变组织微环境。
2024年发表于Cell的框架文章[1]把参考图谱、连续动态、内源和外源干预,以及分子、细胞、多细胞三个尺度放进同一份议程。这是一张能力蓝图:它解释了为什么单一的RNA输出撑不起全部虚拟实验,并没有宣布这些能力已经在某个模型里实现。
评估一个虚拟细胞模型,可以依次问四件事:输入包含什么生物信息,输出对应什么实验量,预测的是观测状态、干预结果还是时间演化,测试是否涉及真正没见过的条件。
把这四点说清楚,比直接比较参数量更接近研究问题本身。
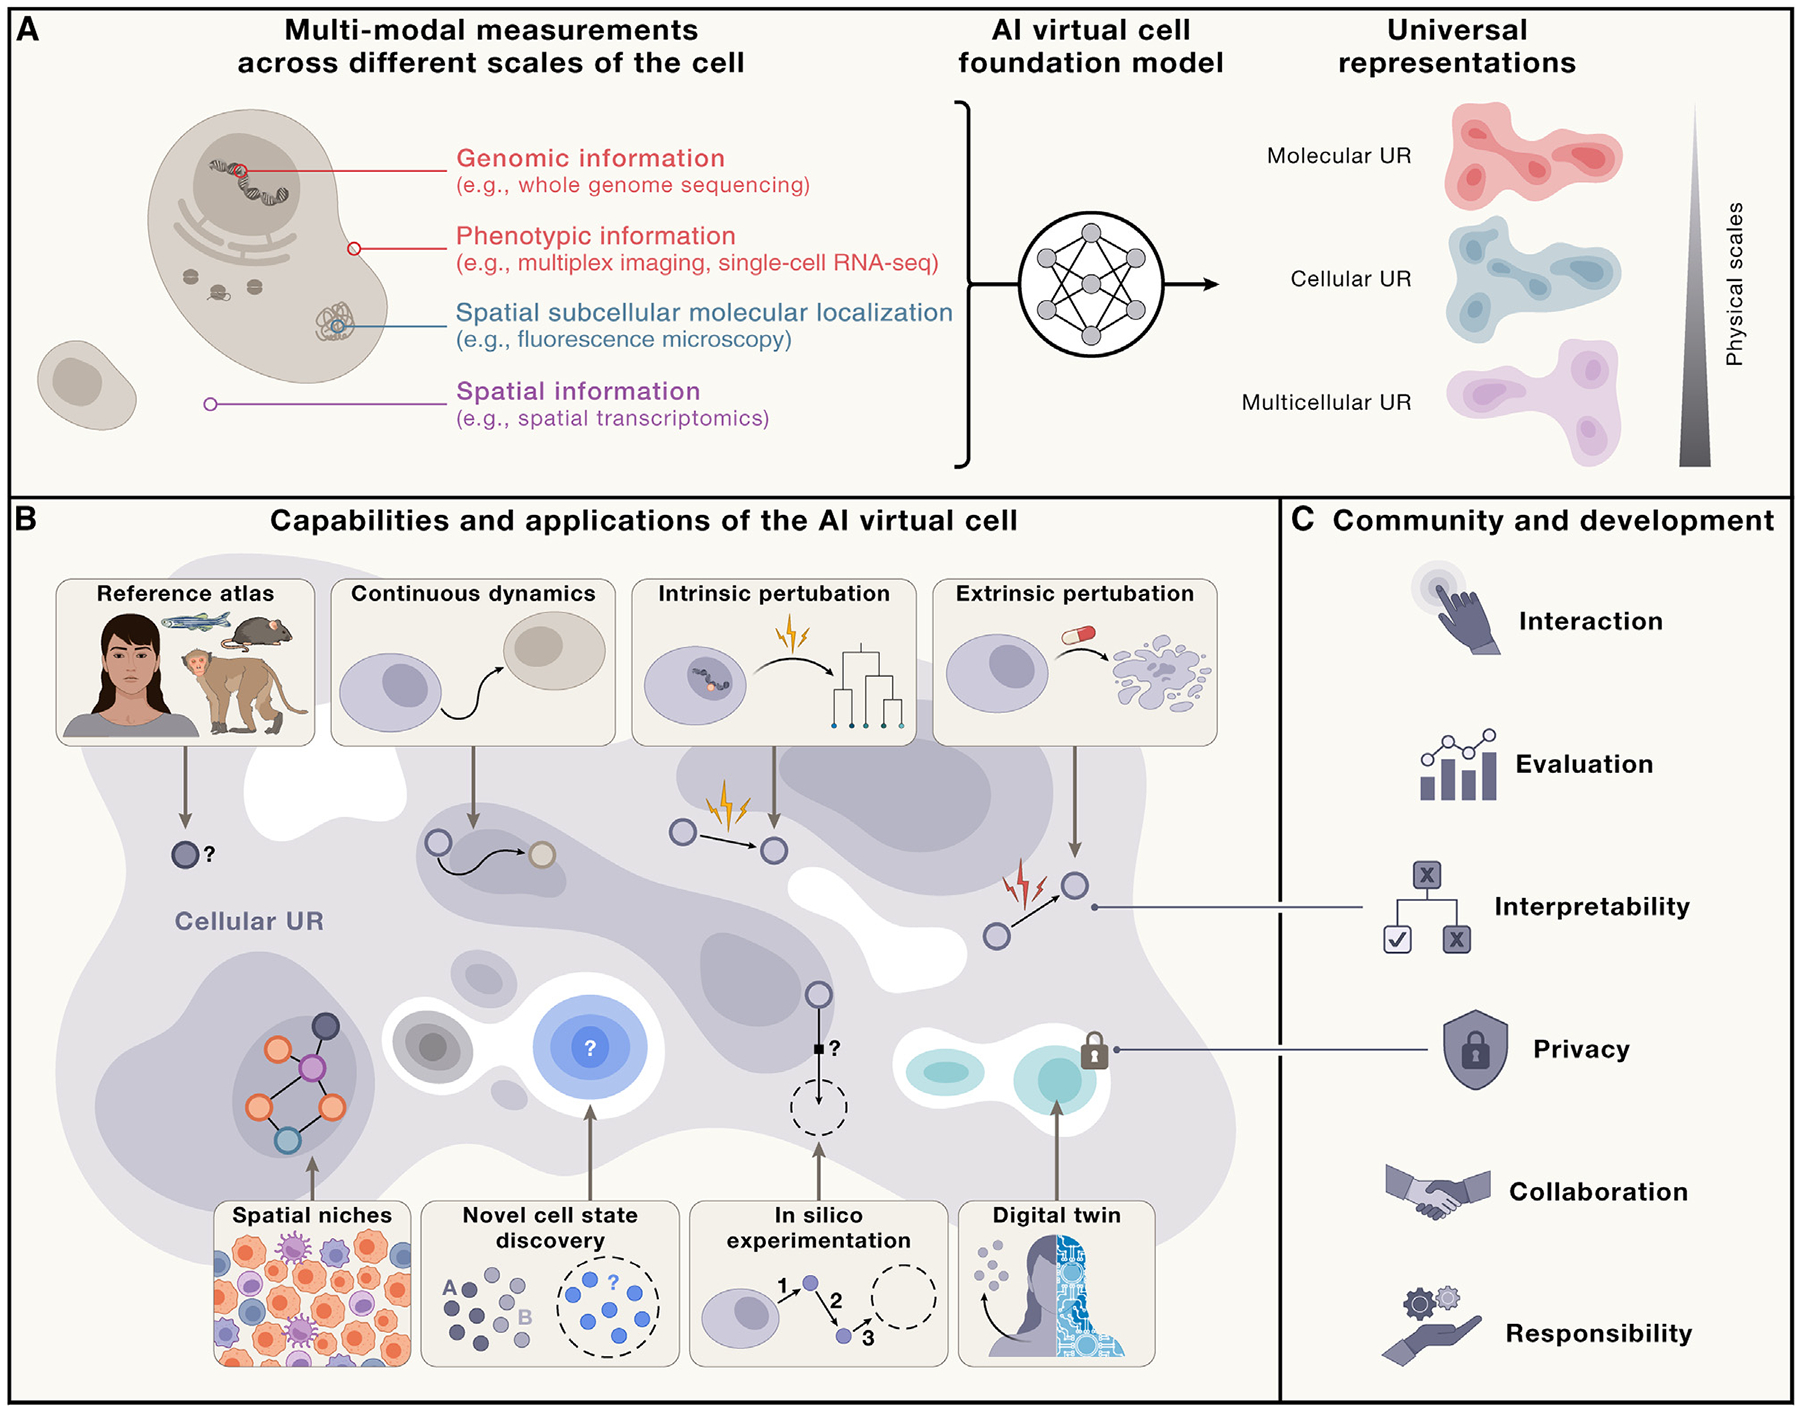
图源:Bunne et al., Cell 2024, Figure 1,doi:10.1016/j.cell.2024.11.015;CC BY 4.0,完整原图,未修改。
机制模拟与数据驱动的三十年
机制模拟的积累要早得多。E-Cell[2]、VCell[3]和COPASI[4]让研究者能在计算环境里指定反应、空间、初始状态和动力学参数。2012年,首个机制全细胞模型[5]把生殖支原体的多个细胞过程连接起来,开启了从基因型推断整细胞表型的研究。
随后,单细胞数据把关注点扩展到细胞群体的状态空间。2018年前后,scVI[6]提供了概率表征,RNA velocity[7]开始从剪接状态推断局部变化方向;2020—2022年,动态推断、最优传输、多组学整合和最小细胞模拟各自推进。2023—2024年,Geneformer、scGPT和scFoundation把大规模预训练带进了单细胞研究。
2025年的变化是数据和任务同时扩张:大规模扰动语料、State、Tahoe-x1、空间上下文模型和公开比赛,让“能否迁移到新条件”成了更直接的检验。2026年又加入空间蛋白、时间分辨蛋白组、四维最小细胞和虚拟胚胎等方向。需要留意的是版本:State、Tahoe-100M、UCE和TranscriptFormer在2026年都有了正式发表版,引用时不宜只沿用早期预印本的年份和结论。
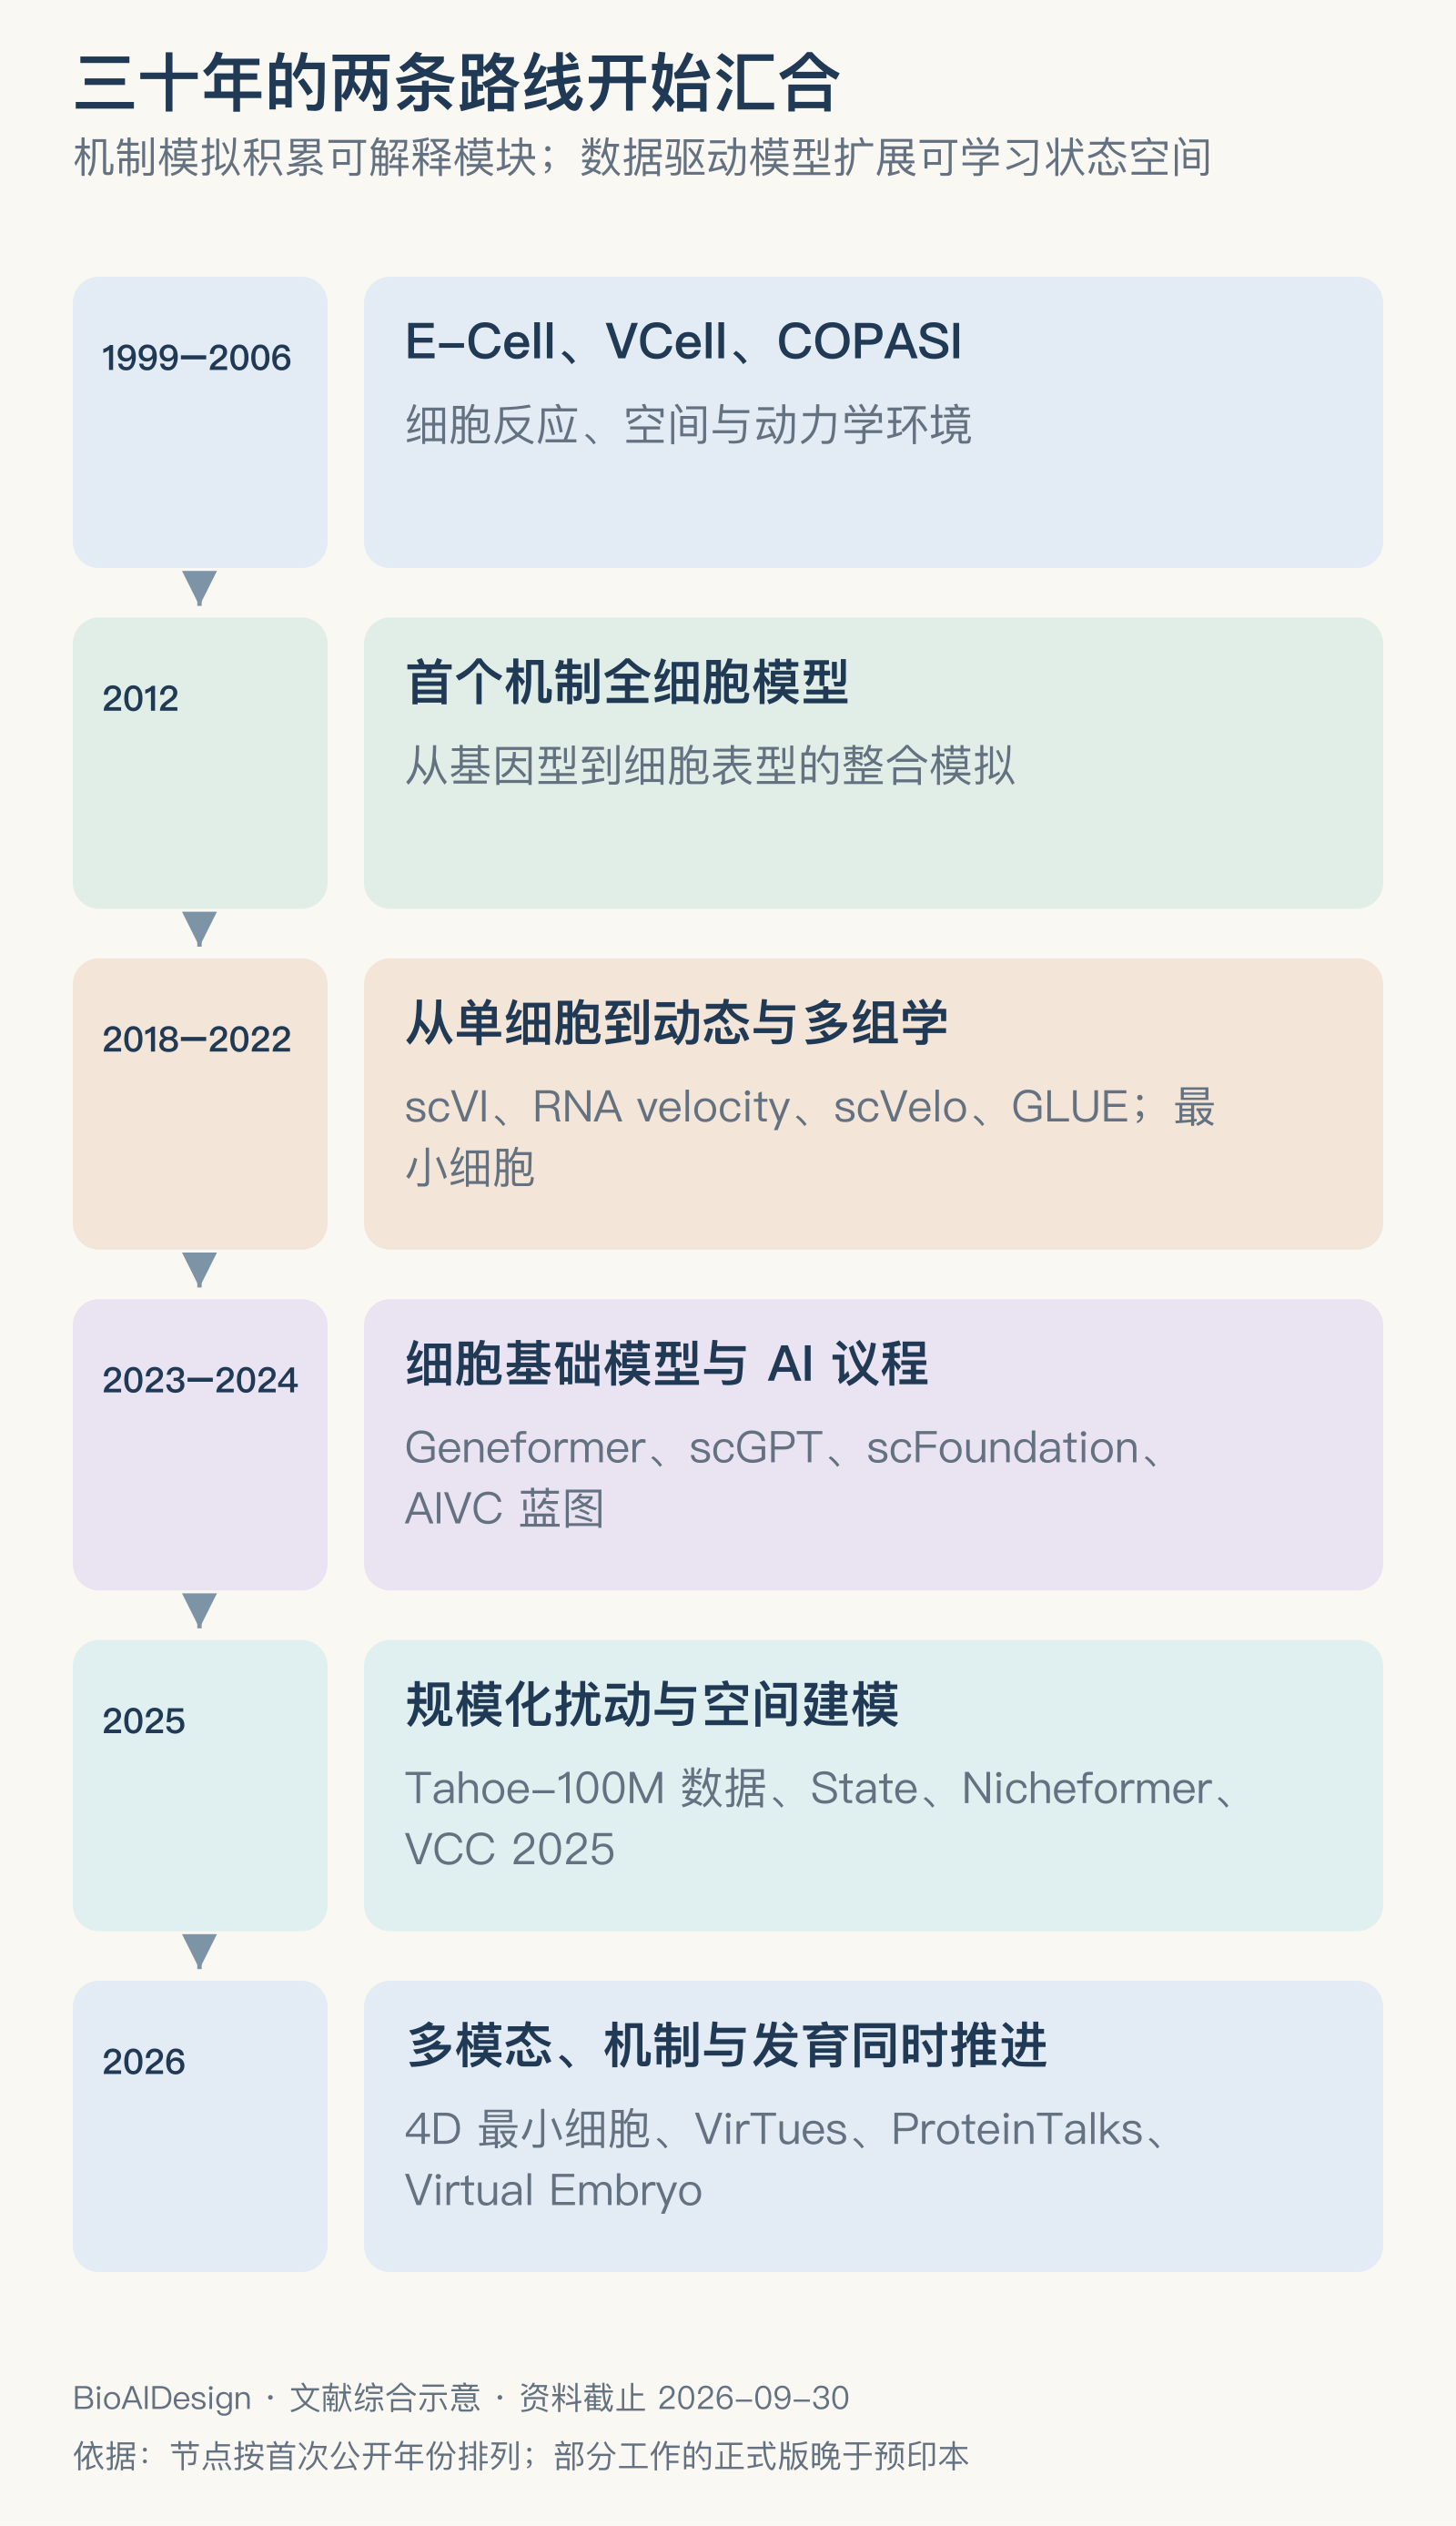
两条路线的能力是互补的。机制模型维护明确的状态和守恒关系,学习模型从复杂数据中估计状态与响应;两者怎样交换变量、对齐时间、传递误差,已经是跨尺度建模中绕不开的实际问题。
全细胞模型中的生长、复制与分裂
全细胞模型难在过程之间的依赖。DNA复制需要原料,转录和翻译消耗能量,蛋白参与代谢与膜的构建,体积和染色体状态又决定分裂条件。一个过程算错,错误会在多轮状态更新中传给其他过程。模型必须维护一套共同的分子数量、环境、空间和时间,才能检查这些反馈是否相容。
2012年的工作围绕生殖支原体(Mycoplasma genitalium)整合了28类细胞过程[5]。后续的大肠杆菌模型[8]把更多生理过程和多来源数据放进同一系统,还利用模型内部的不一致反过来定位数据之间的矛盾。这类模型的价值在解释、预测和知识审计,不能只用一次表达相关系数来衡量。
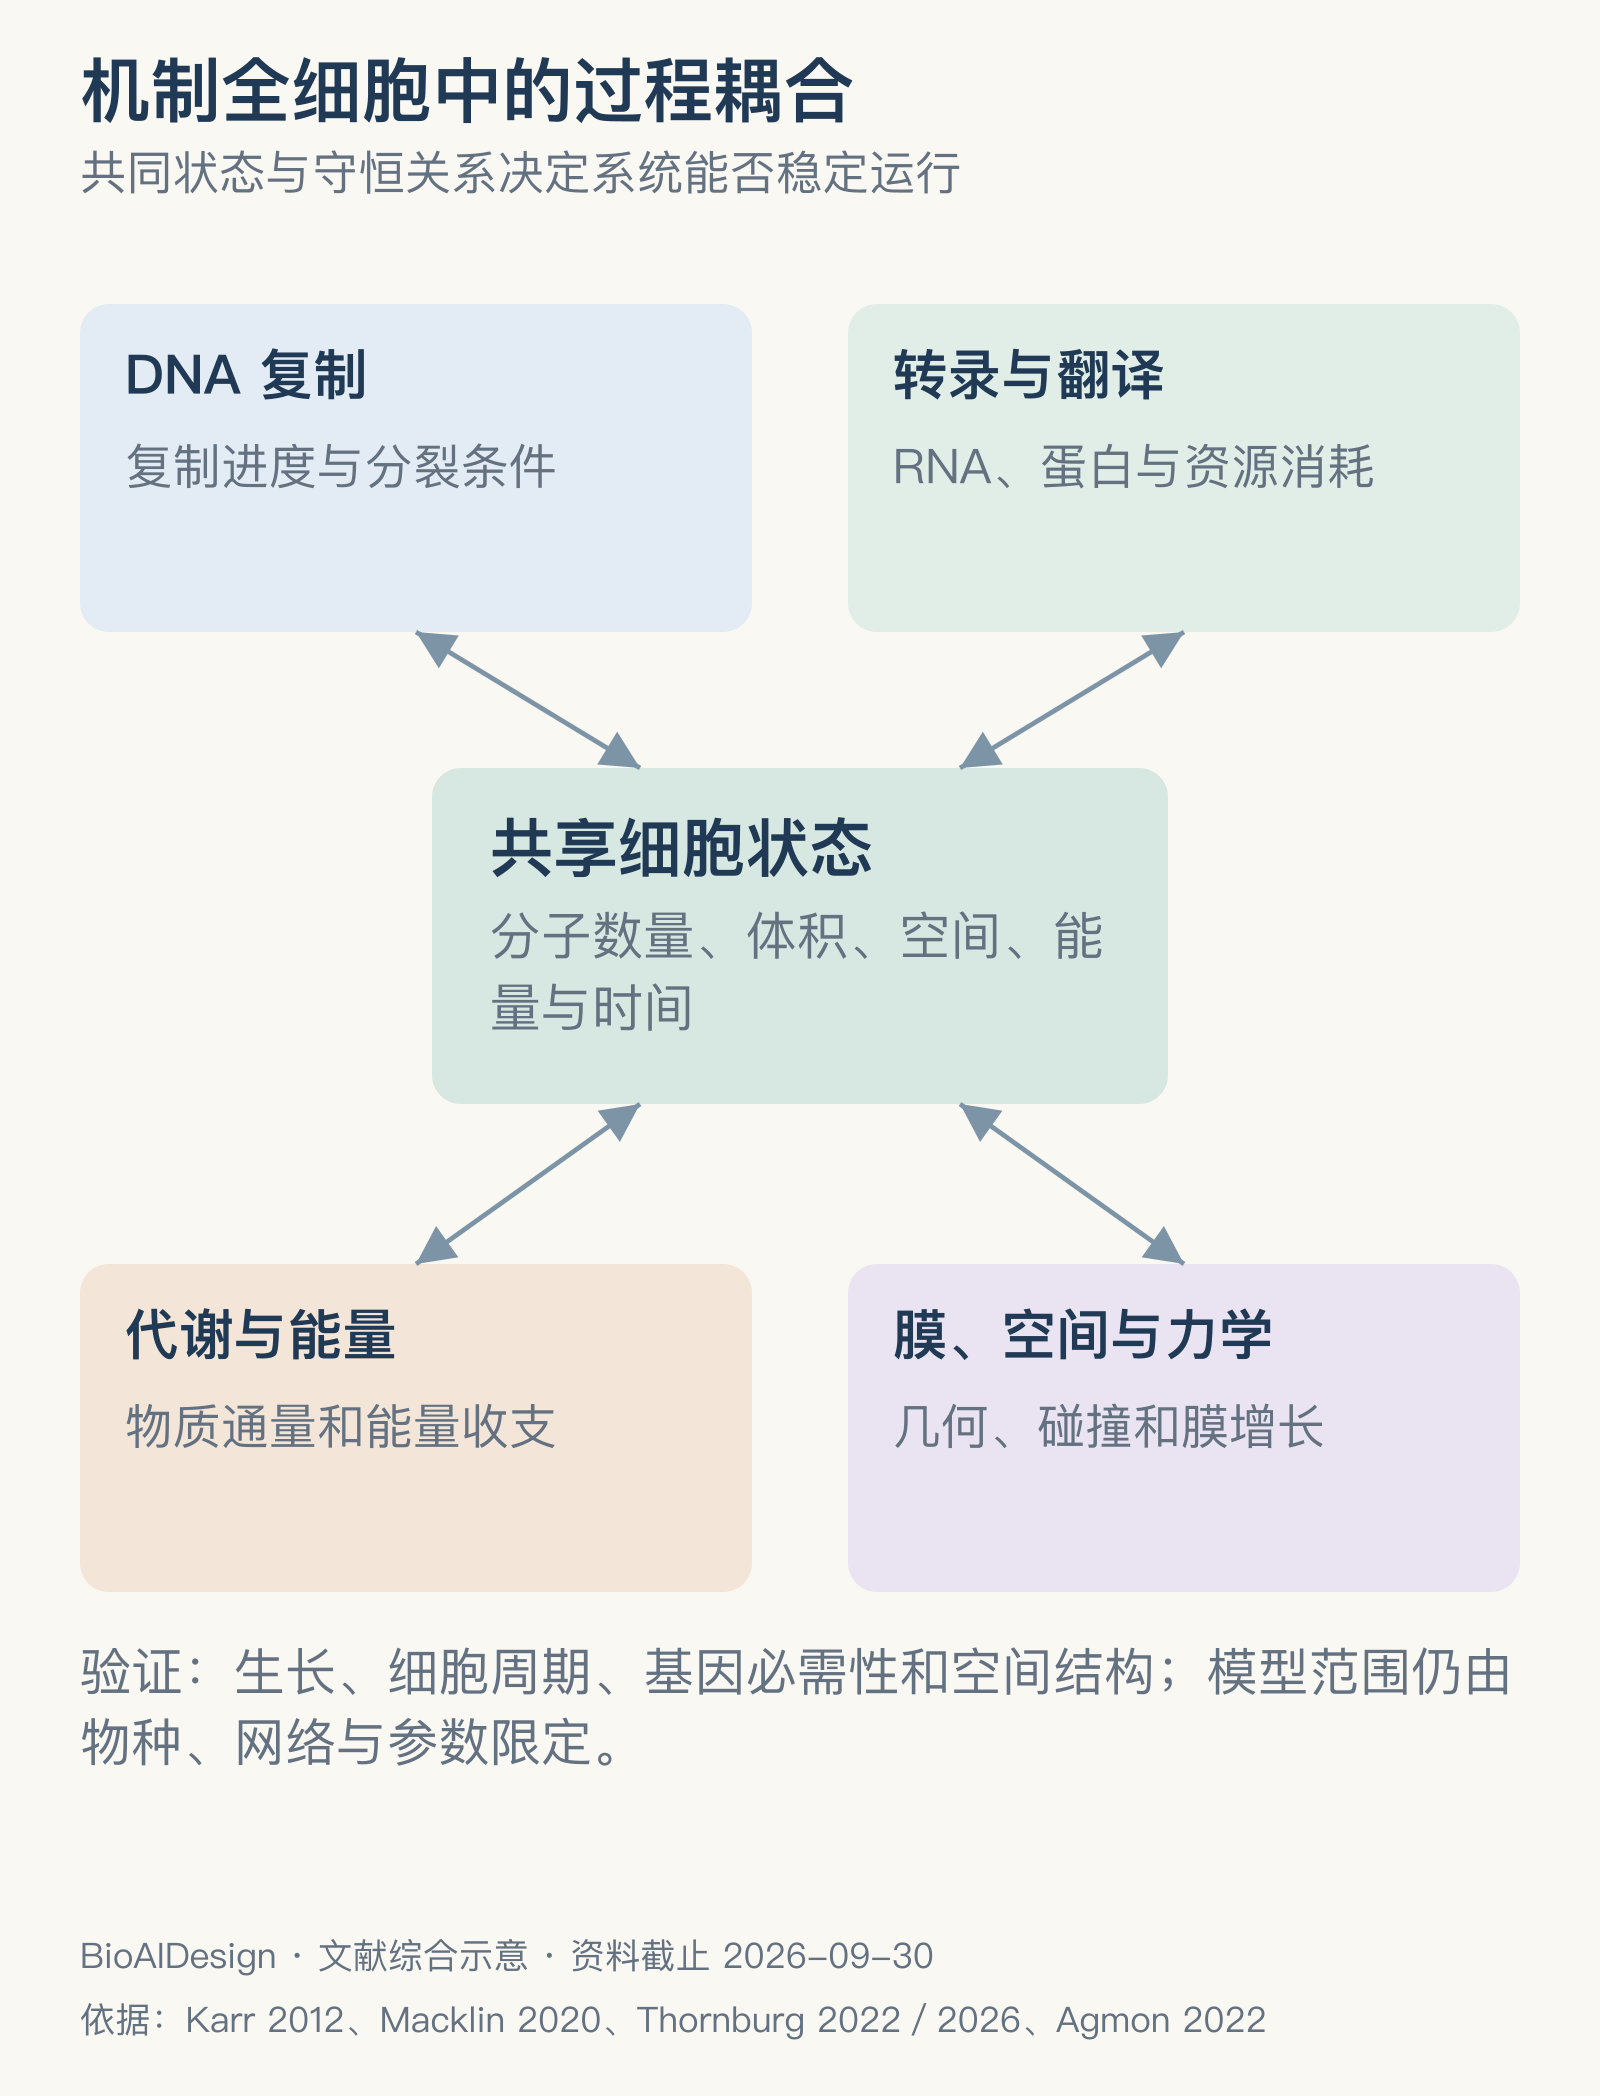
2022年的最小细胞研究[9]把生化过程和空间结构结合起来;2026年针对JCVI-syn3A的工作[10]进一步报告了约100分钟完整细胞周期的四维模拟,把膜增长、染色体、物理过程与代谢连在一起。“四维”指三维空间随时间变化。这一结果来自一个约束充分的最小细胞体系,依赖具体的网络、几何、初始条件和参数。
换到人类细胞,网络规模、细胞器分隔、染色质调控和环境依赖都会抬高建模成本。未知参数也不总能靠扩大训练集解决:多组参数可能产生相似的观测,只有追加实验才能区分。参数可辨识性、守恒检验和独立表型验证因此一直是这条路线的核心环节。
工具上各有分工:VCell适合空间生化反应,COPASI支持动力学拟合和随机反应,COBRApy[11]服务代谢约束计算,ReaDDy[12]提供反应性粒子模拟,Lattice Microbes支持空间随机模拟。Vivarium[13]则是一个可组合的过程运行框架,让不同模块通过共享状态和拓扑连接起来。运行框架解决的是组织与执行,每个模块的实验依据仍要单独记录。
基础模型与跨物种细胞表示
基础表征是目前资源最丰富的路线之一。Geneformer[14]利用按表达排序的基因信息,scGPT[15]学习基因身份与表达值的生成式表示,scFoundation[16]面向全转录组表达建模。预训练得到的向量可以用于注释、整合、分类、重建或任务微调,三篇原论文各自给出了具体任务上的证据;但这些下游输出离细胞完整的内部状态还有距离。
跨物种研究要回答的是:基因词表不同,怎样比较细胞功能?UCE[17]借助蛋白序列表示连接不同物种的表达信息;TranscriptFormer[18]把基因/蛋白知识与表达生成结合,训练数据最多覆盖12个物种、1.12亿细胞。GeneCompass[19]构建了1.26亿人鼠细胞语料(预处理后约1.02亿用于训练),并加入基因调控网络(GRN)、启动子序列、基因家族和共表达四类先验。同源关系和功能知识由此进入模型,先验的质量和跨物种映射的局限也一并带了进来。
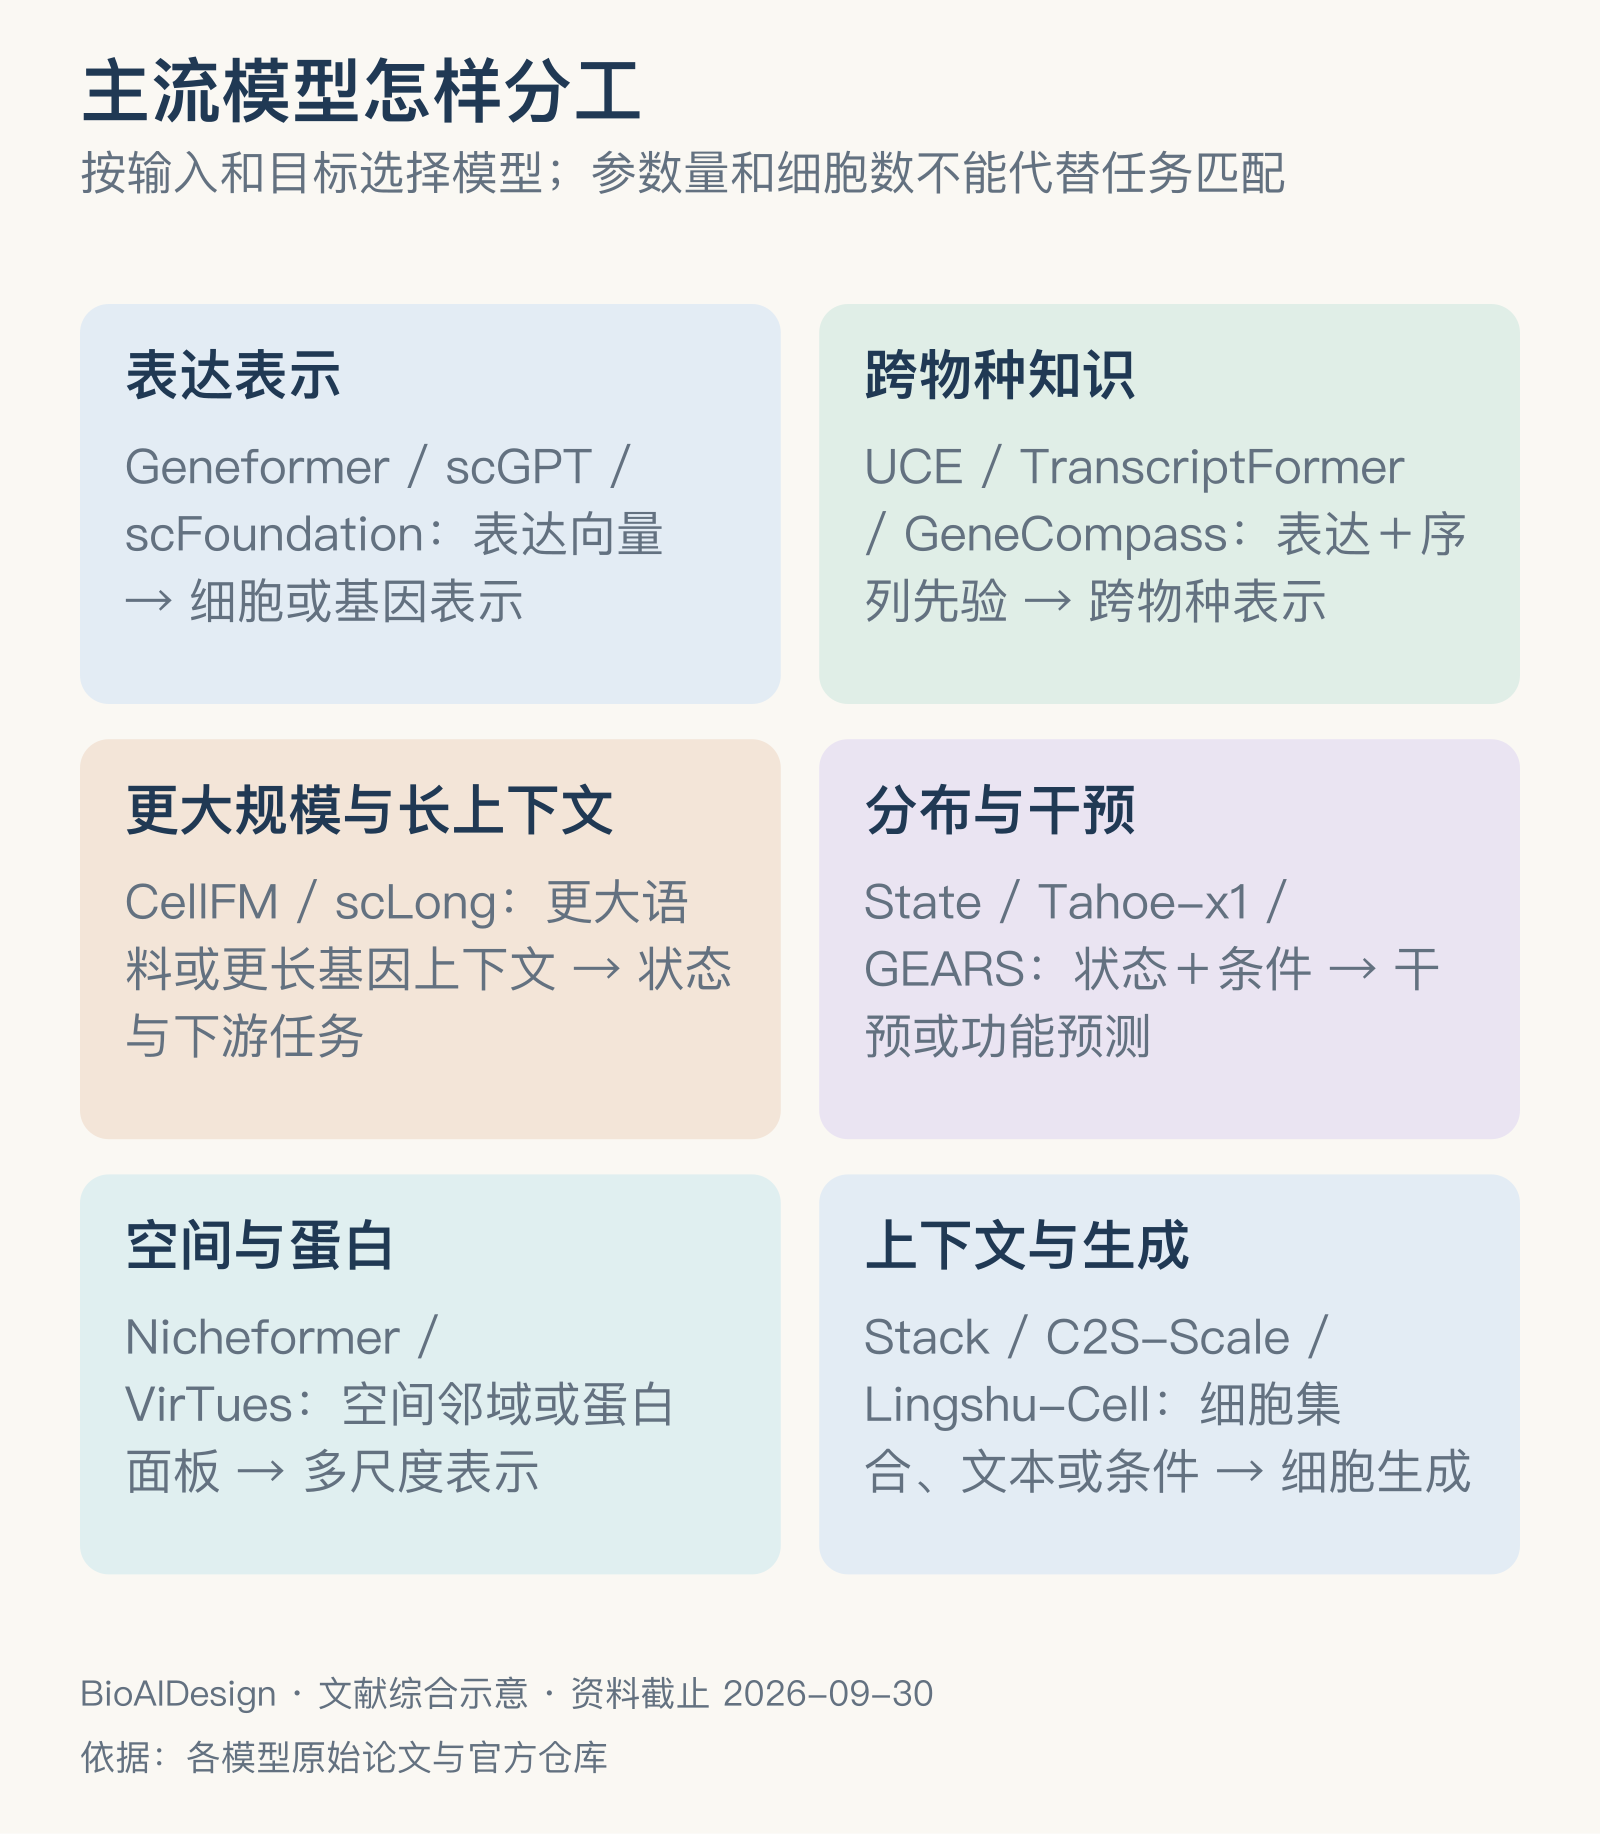
另一些模型针对表达数据的不同特点。CellFM[20]基于RetNet架构和MindSpore框架,论文中的1亿是训练细胞数、8亿是模型参数量,两个数字单位不同;scLong[21]关注更长的基因上下文。CellPLM[22]以细胞为token,把细胞间关系纳入预训练。Cell2Sentence[23]和C2S-Scale[24]把按表达排序的基因名写成“细胞句子”,让细胞数据可以与语言模型交互,后者最大的版本达到270亿参数。可读文本方便了接口和任务描述,模型生成的解释仍要与实验信息核对。
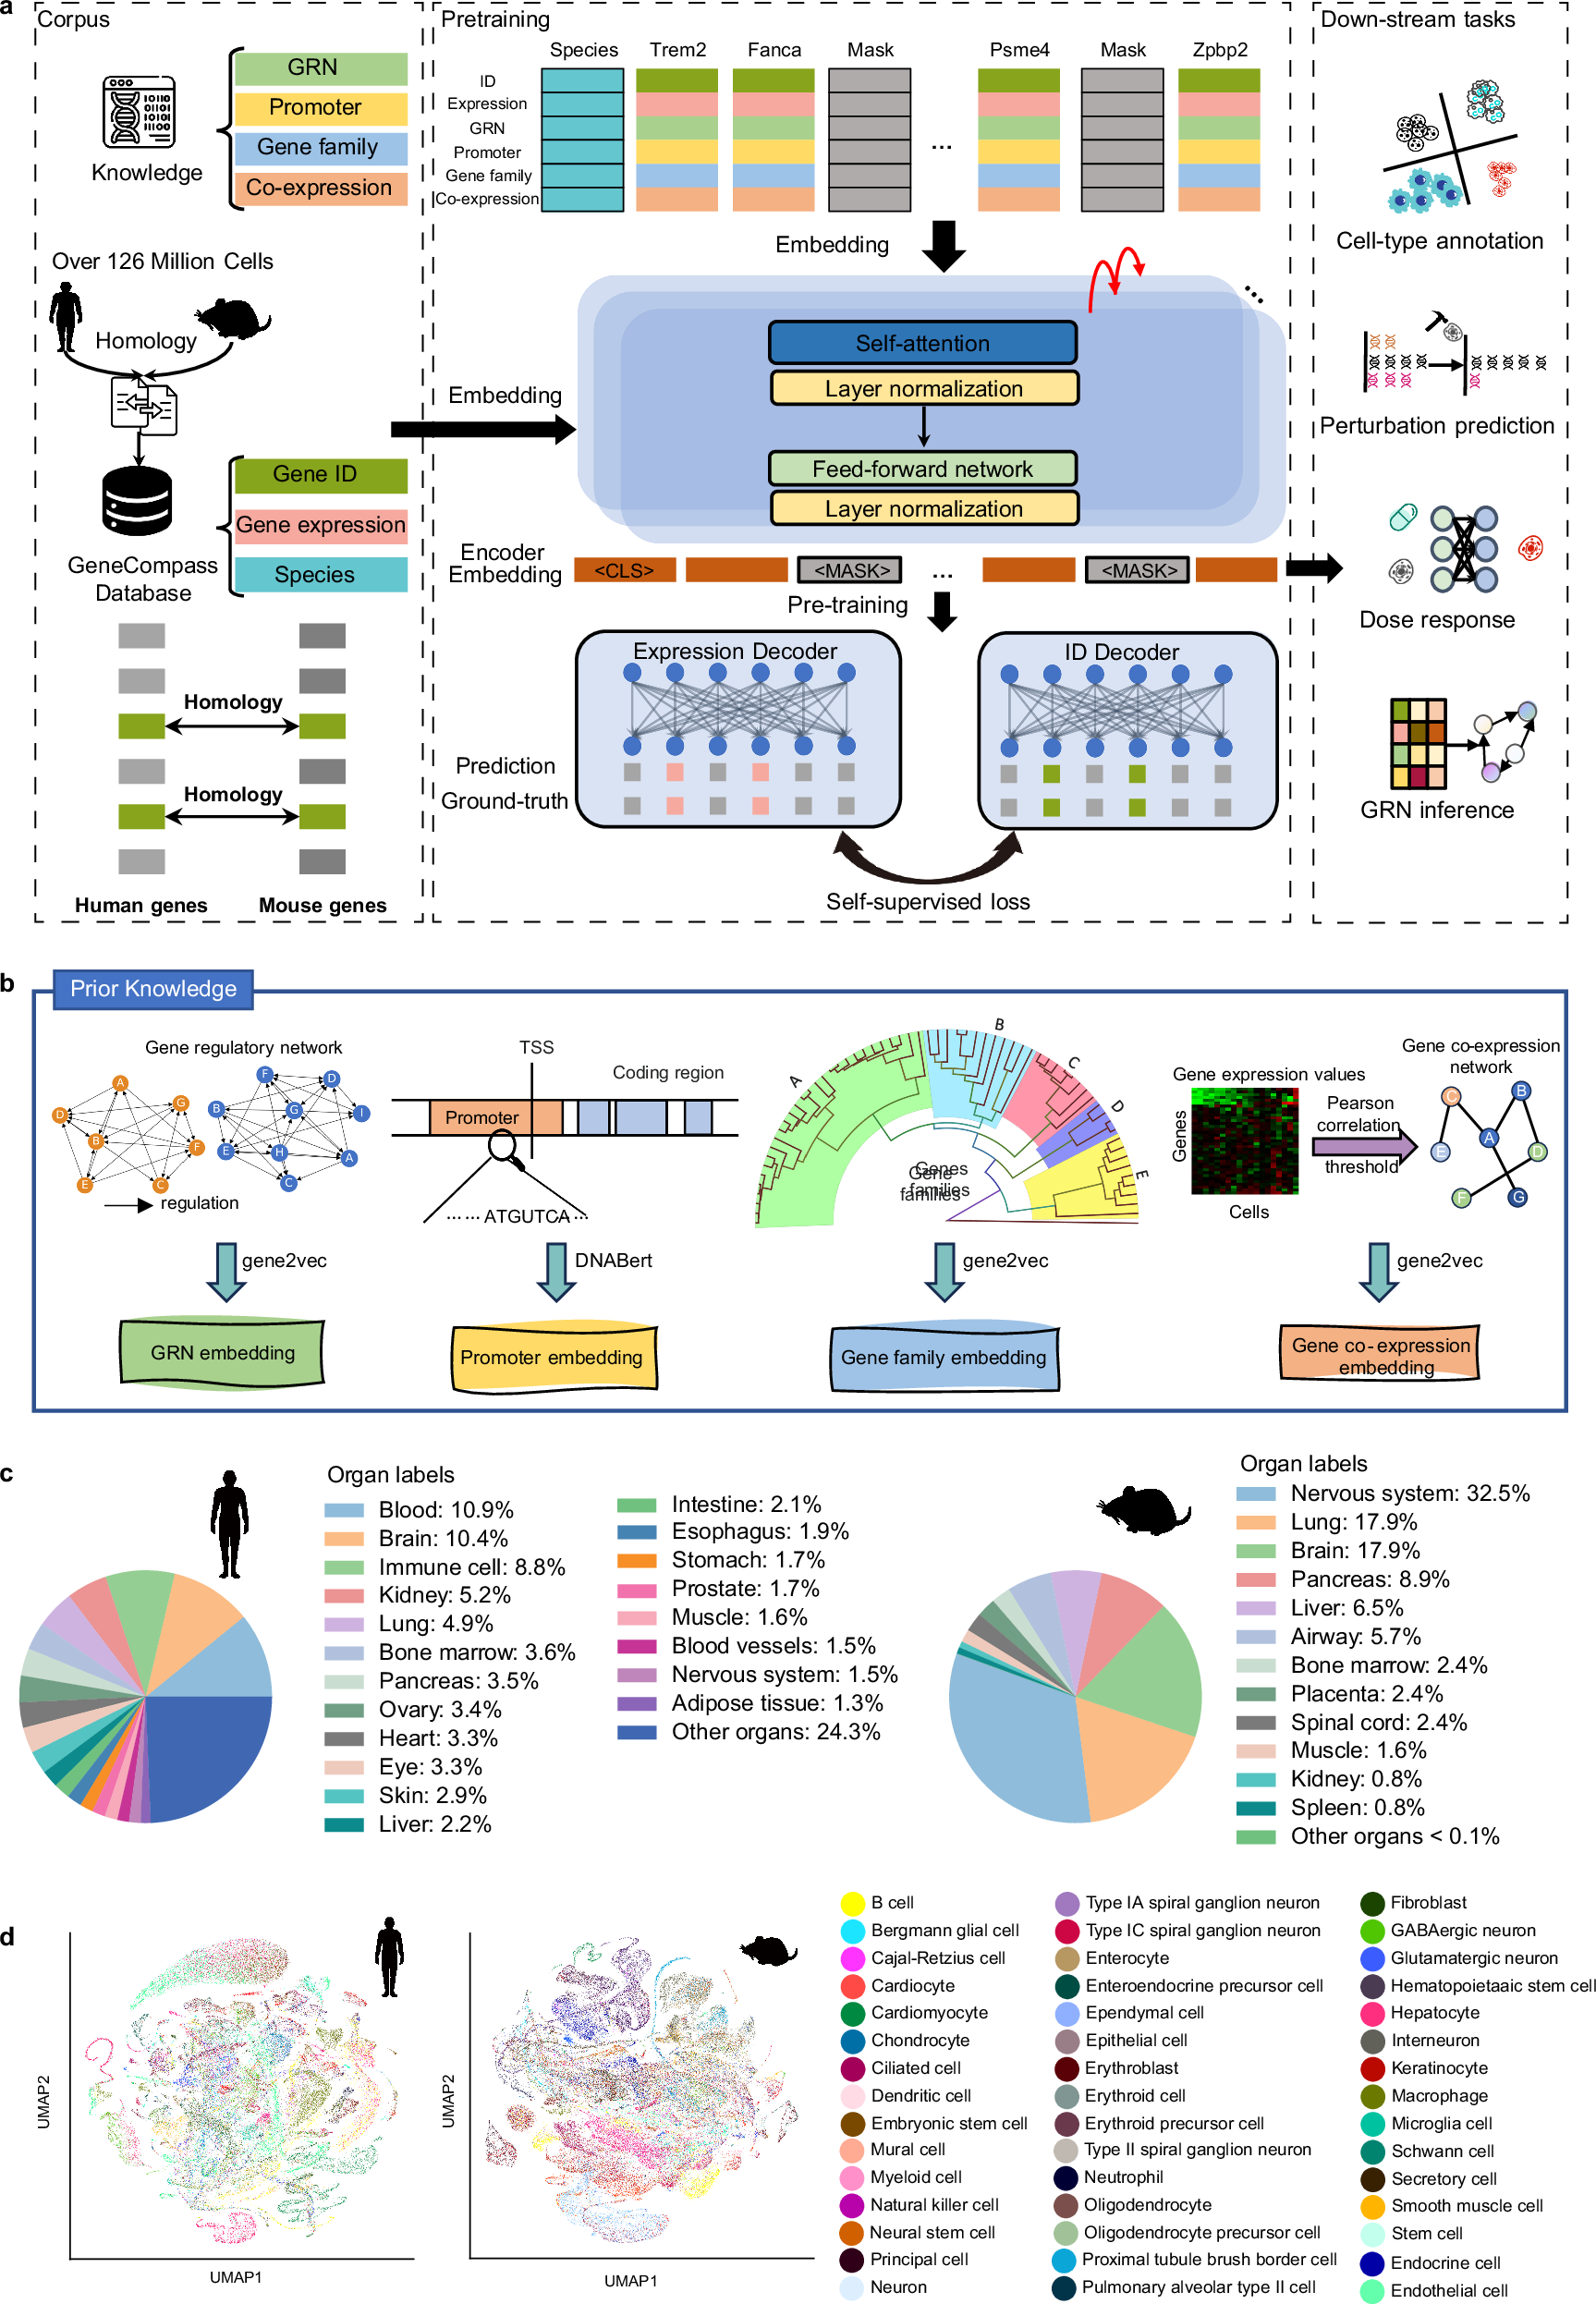
图源:Yang et al., Cell Research 2024, Fig. 1,doi:10.1038/s41422-024-01034-y;CC BY 4.0,完整原图,未修改。
Stack[25]把学习单位扩展到细胞集合:它交替在细胞内和细胞间做注意力计算,用上下文中的细胞作为提示来预测新条件,探索推断时无需重新微调的适配方式。官方材料列出1.49亿细胞预训练和5500万细胞后训练,这是两个阶段,不应相加成一个总细胞量。配套的Perturb Sapiens覆盖约2万种“细胞类型—组织—扰动”组合,但它们都是模型生成的预测,只有选定的部分经过新增实验检验(见Arc研究所的官方发布与代码仓库)。
2026年的新材料还有Speciesformer[26]的跨物种生成、AetherCell[27]的跨平台表达与类器官任务,以及Lingshu-Cell[28]对约18000个基因的离散扩散建模。它们扩大了候选技术的范围,但都是新近预印本,独立评测、资源发布和复现证据还在积累。挑选模型时,至少先匹配物种、基因命名、测序平台、细胞背景和任务输出,再看参数规模。
从调控序列到多组学状态
只有RNA不足以描述一个细胞。染色质可及性关系到哪些区域可能参与调控,蛋白的数量和修饰关系到实际功能,DNA变异还会改变调控序列。多模态模型首先要面对数据是否配对、测量缺失和技术批次这些问题。
scVI[6]、totalVI[29]、MultiVI[30]和GLUE[31]给出了不同的整合方式:RNA计数的概率建模、RNA与表面蛋白的联合建模、RNA/ATAC部分配对与缺失模态处理,以及图引导的非配对组学对齐。它们既能建立共同潜空间,也能预测缺失的模态。补全出来的结果是预测值,在稀有群体、未知背景或低覆盖模态里尤其不能当作实际测量。
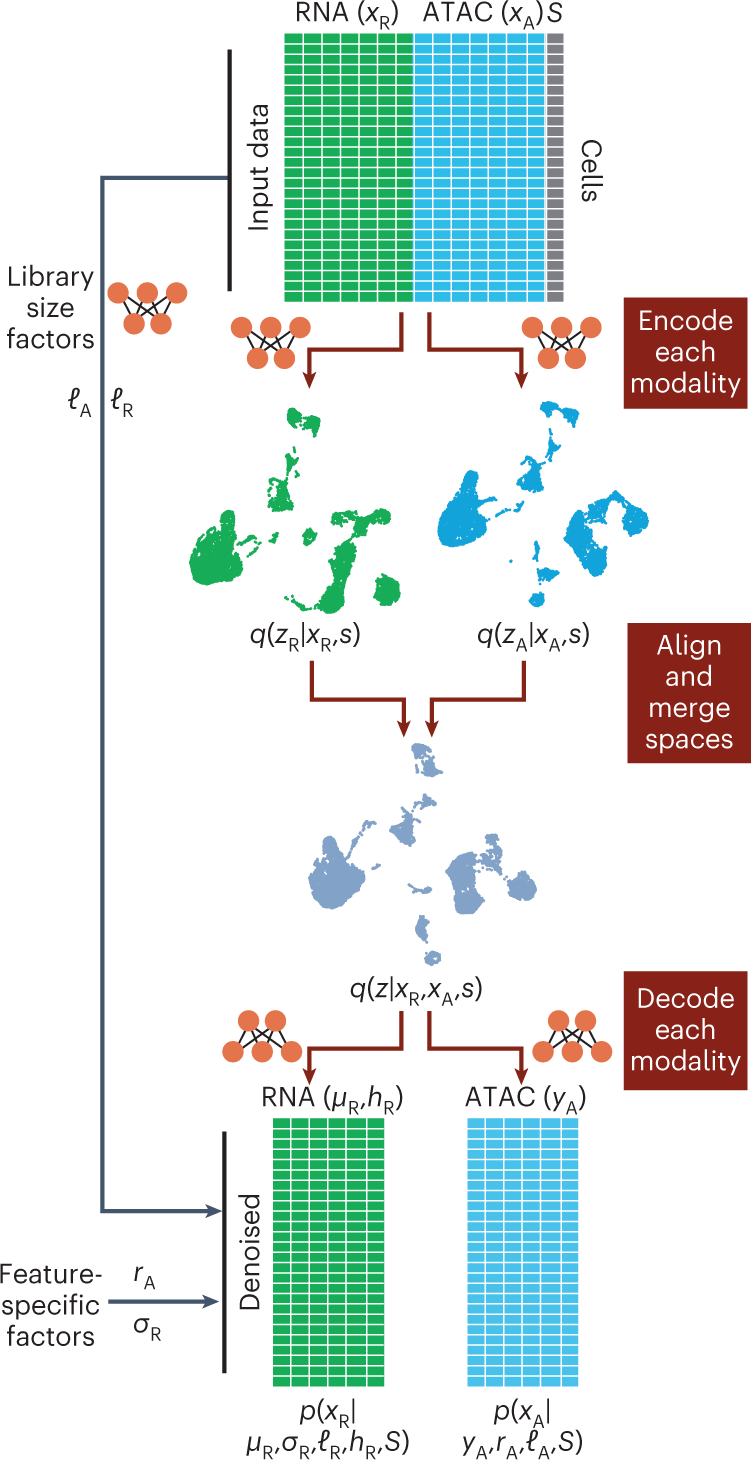
图源:Ashuach et al., Nature Methods 2023, Fig. 1,doi:10.1038/s41592-023-01909-9;CC BY 4.0,完整原图,未修改。
调控网络路线追求更具体的连接。SCENIC+[32]结合表达、可及性、motif和结合先验,把转录因子、增强子与靶基因组织成增强子驱动的调控网络(eGRN)。与只找相关基因相比,这种结构更容易转化成后续实验:敲除某个转录因子、删除某个增强子,再检验靶基因表达和细胞命运。网络中的边有证据强弱之分,motif存在、可及性相关和功能上必需是三件不同的事。
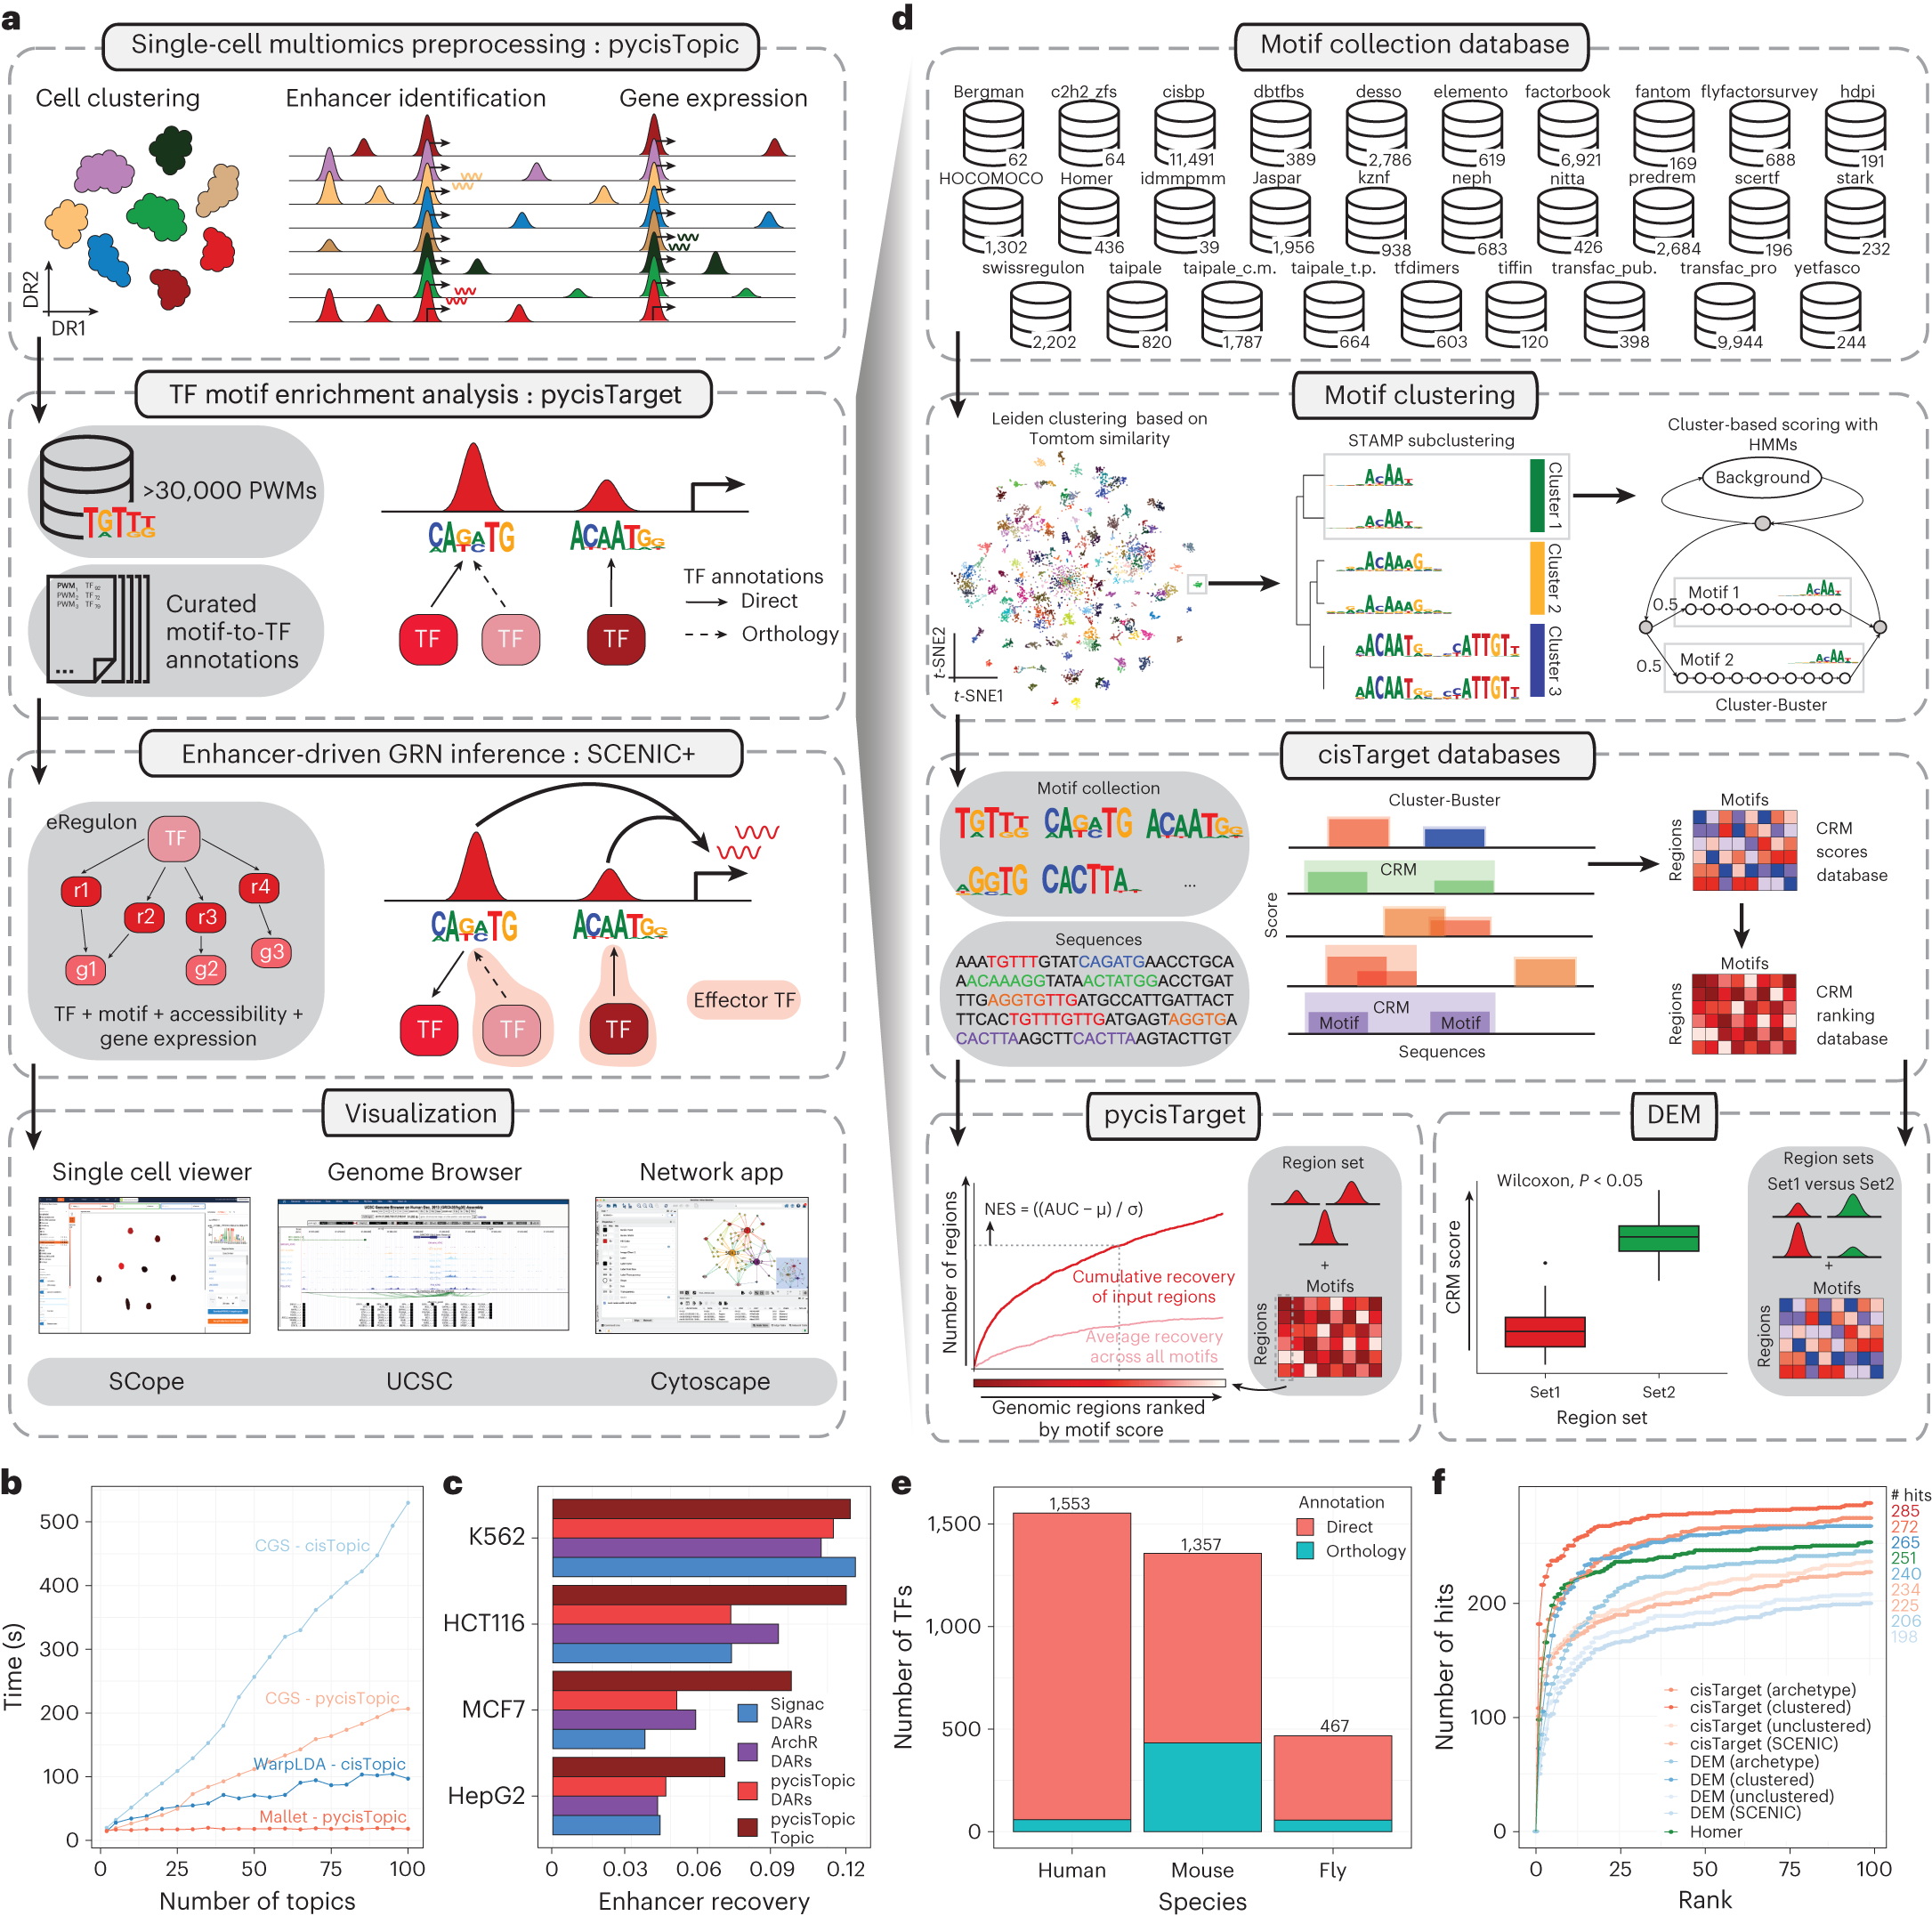
图源:Bravo González-Blas et al., Nature Methods 2023, Fig. 1,doi:10.1038/s41592-023-01938-4;CC BY 4.0,完整原图,未修改。
scPRINT[33]把蛋白序列嵌入和多个表达相关任务引入单细胞模型,并推断细胞特异的网络;RegFormer[34]引入GRN层级顺序和Mamba状态空间网络。序列方向还有Enformer[35]和ChromBPNet(代码)等组件,负责从DNA序列预测调控相关信号。它们可以为细胞模型补上序列层的输入,适用范围由各自的原始任务决定。
沿着“序列变异→调控区域→表达→蛋白/表型”这条链追下去,就能看出多组学整合还有哪些环节缺少实验支持。共同潜空间解决的是对齐;删掉一个增强子之后,变化能否一路传到蛋白和表型,还要靠干预实验来回答。
细胞动态、命运与真实时间
多数单细胞实验得到的是不同细胞的快照。把它们排成拟时序,可以描述状态之间的关系;要判断真实的变化速率、持续时间和未来分布,还需要额外信息。实验时间点、RNA剪接、代谢标记、活细胞成像和谱系记录提供的约束各不相同,彼此不能互相替代。
RNA velocity[7]和scVelo[36]从剪接与转录动力学估计局部变化方向;dynamo[37]利用代谢标记等信息重建向量场;Waddington-OT[38]从真实时间点之间的细胞分布估计概率输运;TIGON[39]进一步考虑增殖和质量变化。CellRank 2[40]把速度、时间或其他视图组织成转移核,推断终末状态与命运概率。这些方法回答的分别是方向、分布连接、变化场和概率命运。
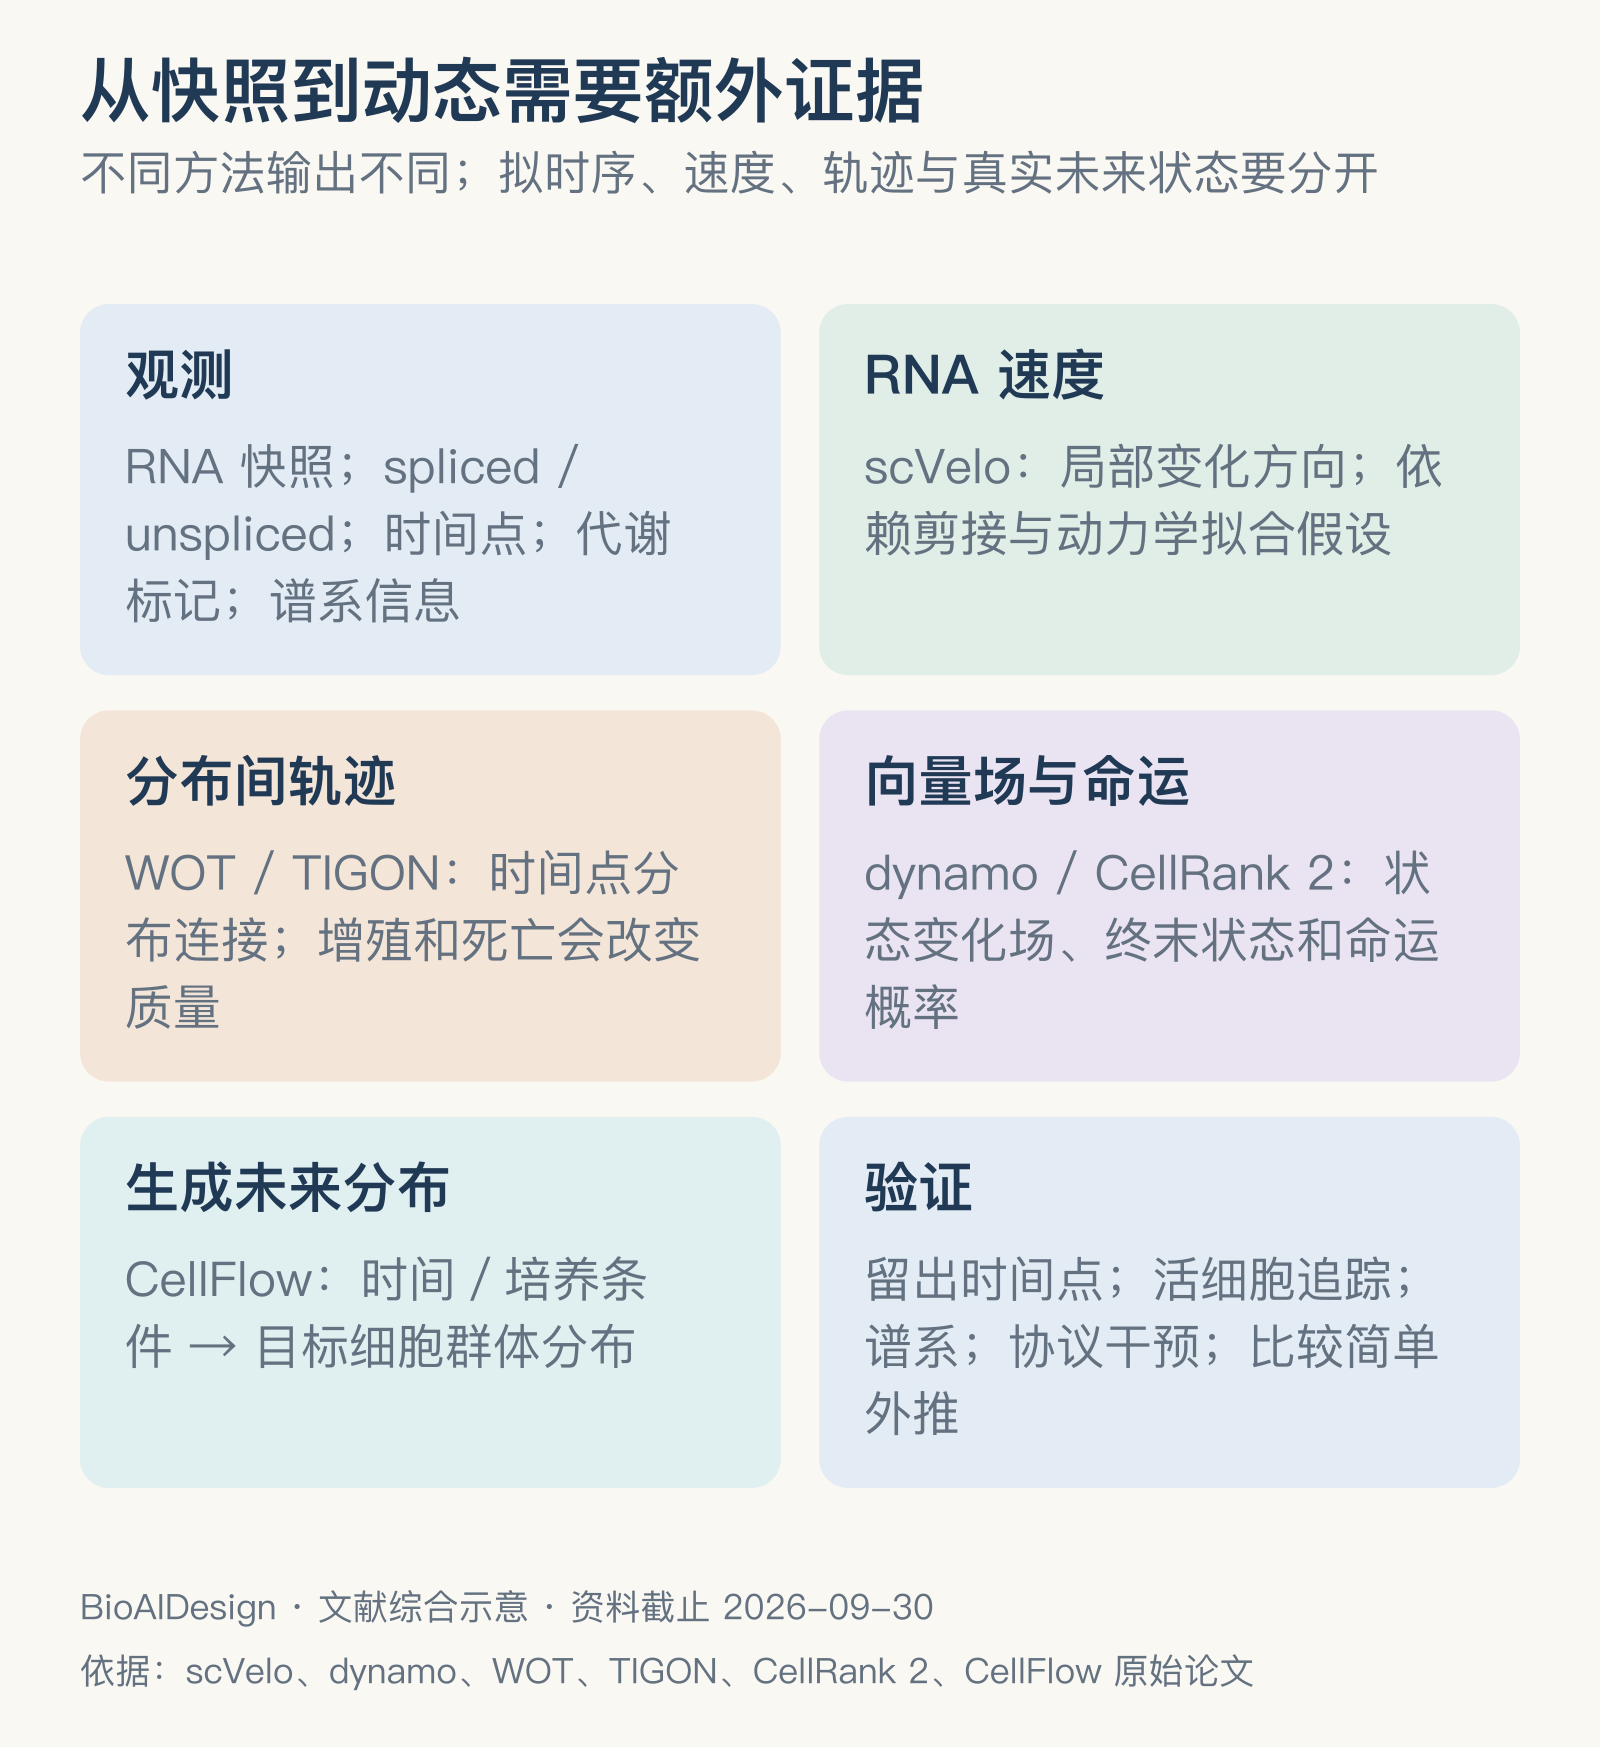
对实验研究者,CellRank 2的价值在于把多种来源的状态转移信息整合进同一套命运分析。对建模者,要记住命运概率是模型在已观测的状态空间和转移假设下给出的条件结果:它覆盖不了从未出现过的终末细胞群,也不等同于每个细胞实际留下的谱系。
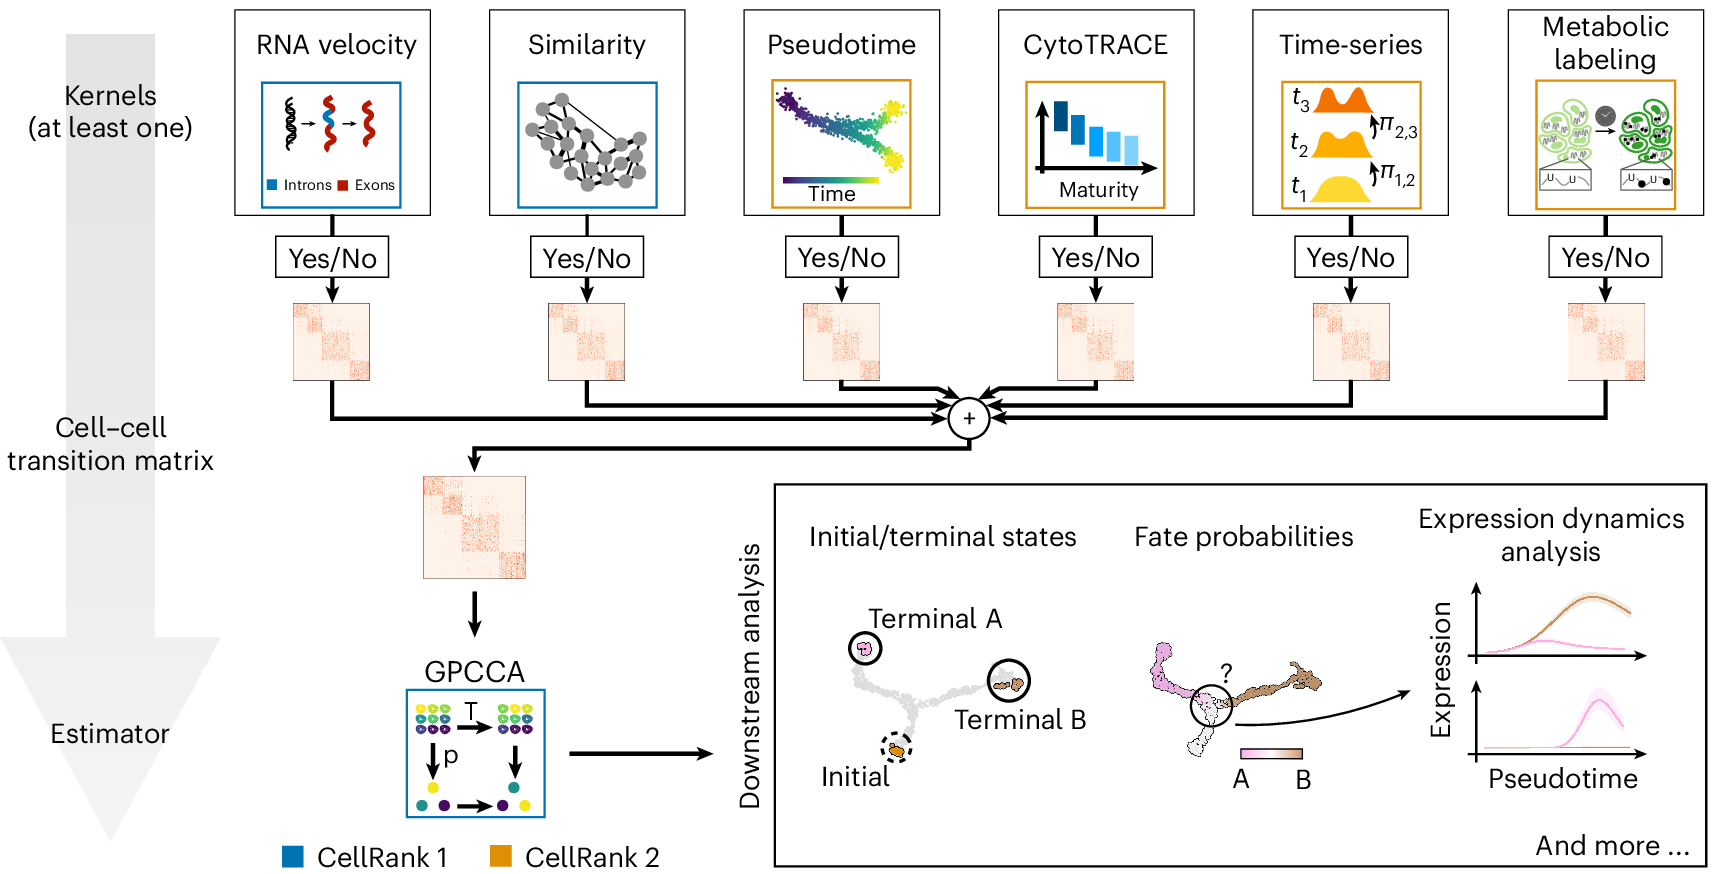
图源:Weiler et al., Nature Methods 2024, Fig. 1,doi:10.1038/s41592-024-02303-9;CC BY 4.0,完整原图,未修改。
TIGON提醒我们,时间演化里还有细胞的出现和消失。如果某个群体大量增殖,用守恒的点对点匹配去解释全部变化,可能把组成的改变误读成分化。非平衡最优传输显式处理质量变化,提供了另一种轨迹重建方式;效果如何,要放回时间点设置、增长假设和数据覆盖里评价。
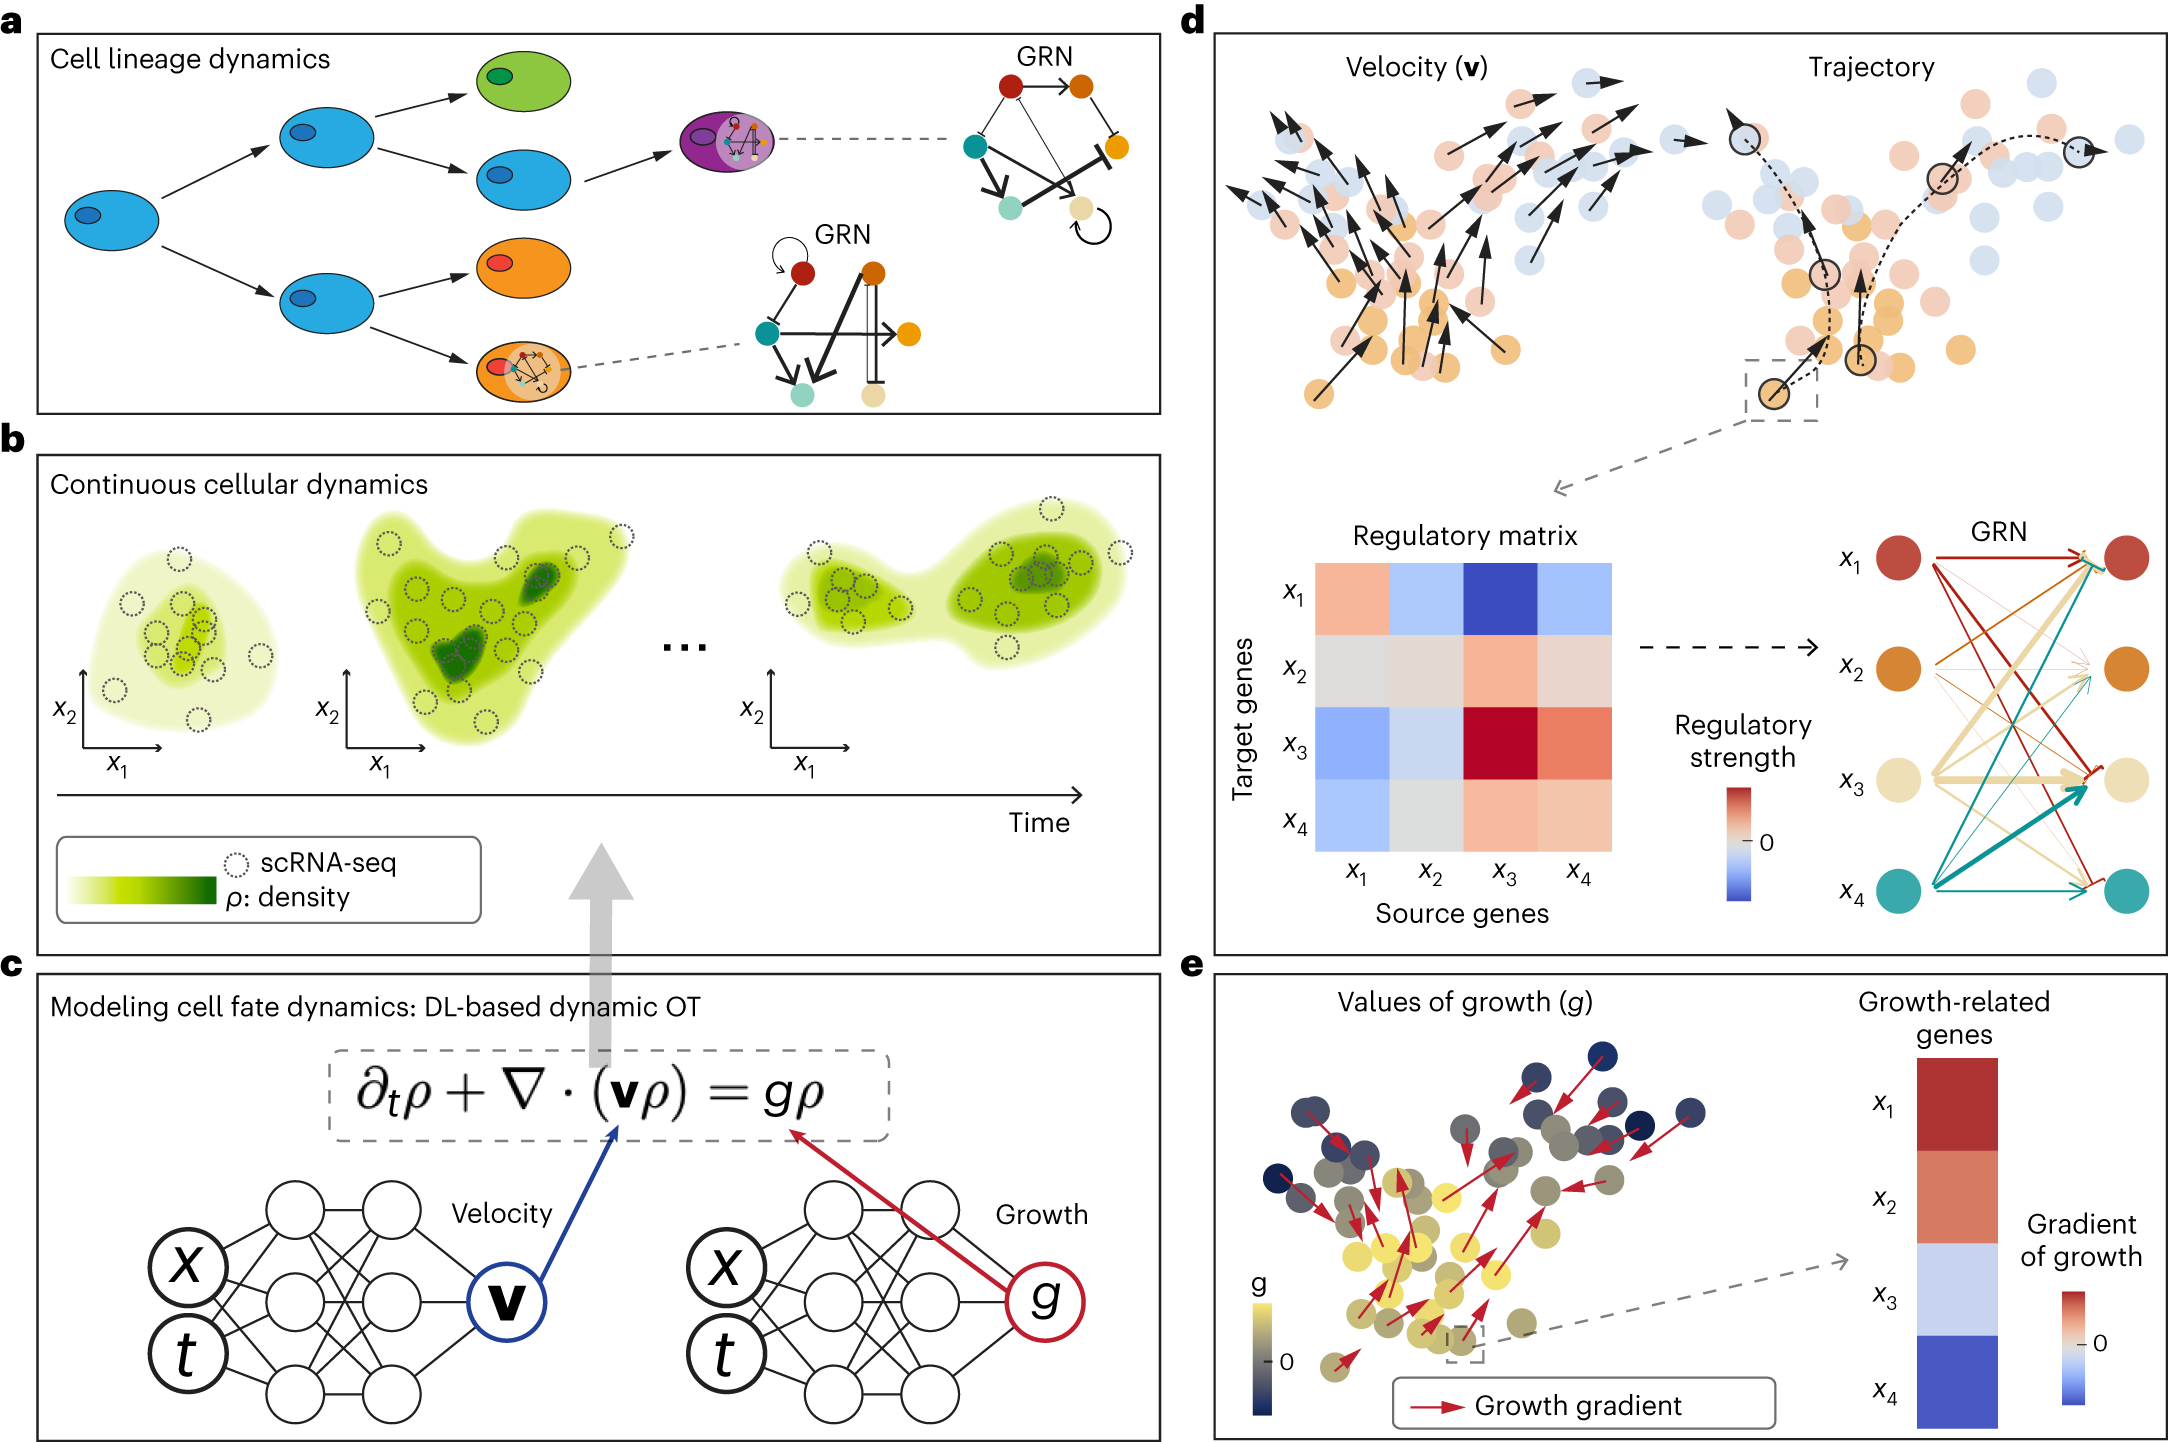
图源:Sha et al., Nature Machine Intelligence 2023, Fig. 1,doi:10.1038/s42256-023-00763-w;CC BY 4.0,完整原图,未修改。
CellFlow[41]把条件flow matching用于细胞群体生成,探索时间或培养协议与目标状态分布之间的关系,其中包括类器官相关任务(代码)。由此可以提出更直接的实验问题:改变一个培养因子或一个时间窗,能否预测最终的细胞类型比例?验证时应留出真实的时间点或协议,检验组成、稀有状态和分布结构,而不只比较整体均值。
代谢通量与信号动力学
RNA的变化最终要通过蛋白、酶和反应网络影响细胞功能。代谢路线把这个问题转成物质平衡:哪些反应可以发生,摄取和分泌的边界在哪里,能量与生物量怎样形成。全基因组代谢网络提供反应和基因的关联,环境条件决定可行解的空间。
Human-GEM[42]和COBRApy[11]是容易上手的起点。稳态下常用的 S·v = 0 表示化学计量矩阵与反应通量满足质量平衡,求解时还需要培养基、摄取边界和目标函数。这组约束能大幅收窄细胞可行的代谢状态,却不足以单独确定每种真实条件下的唯一通量。
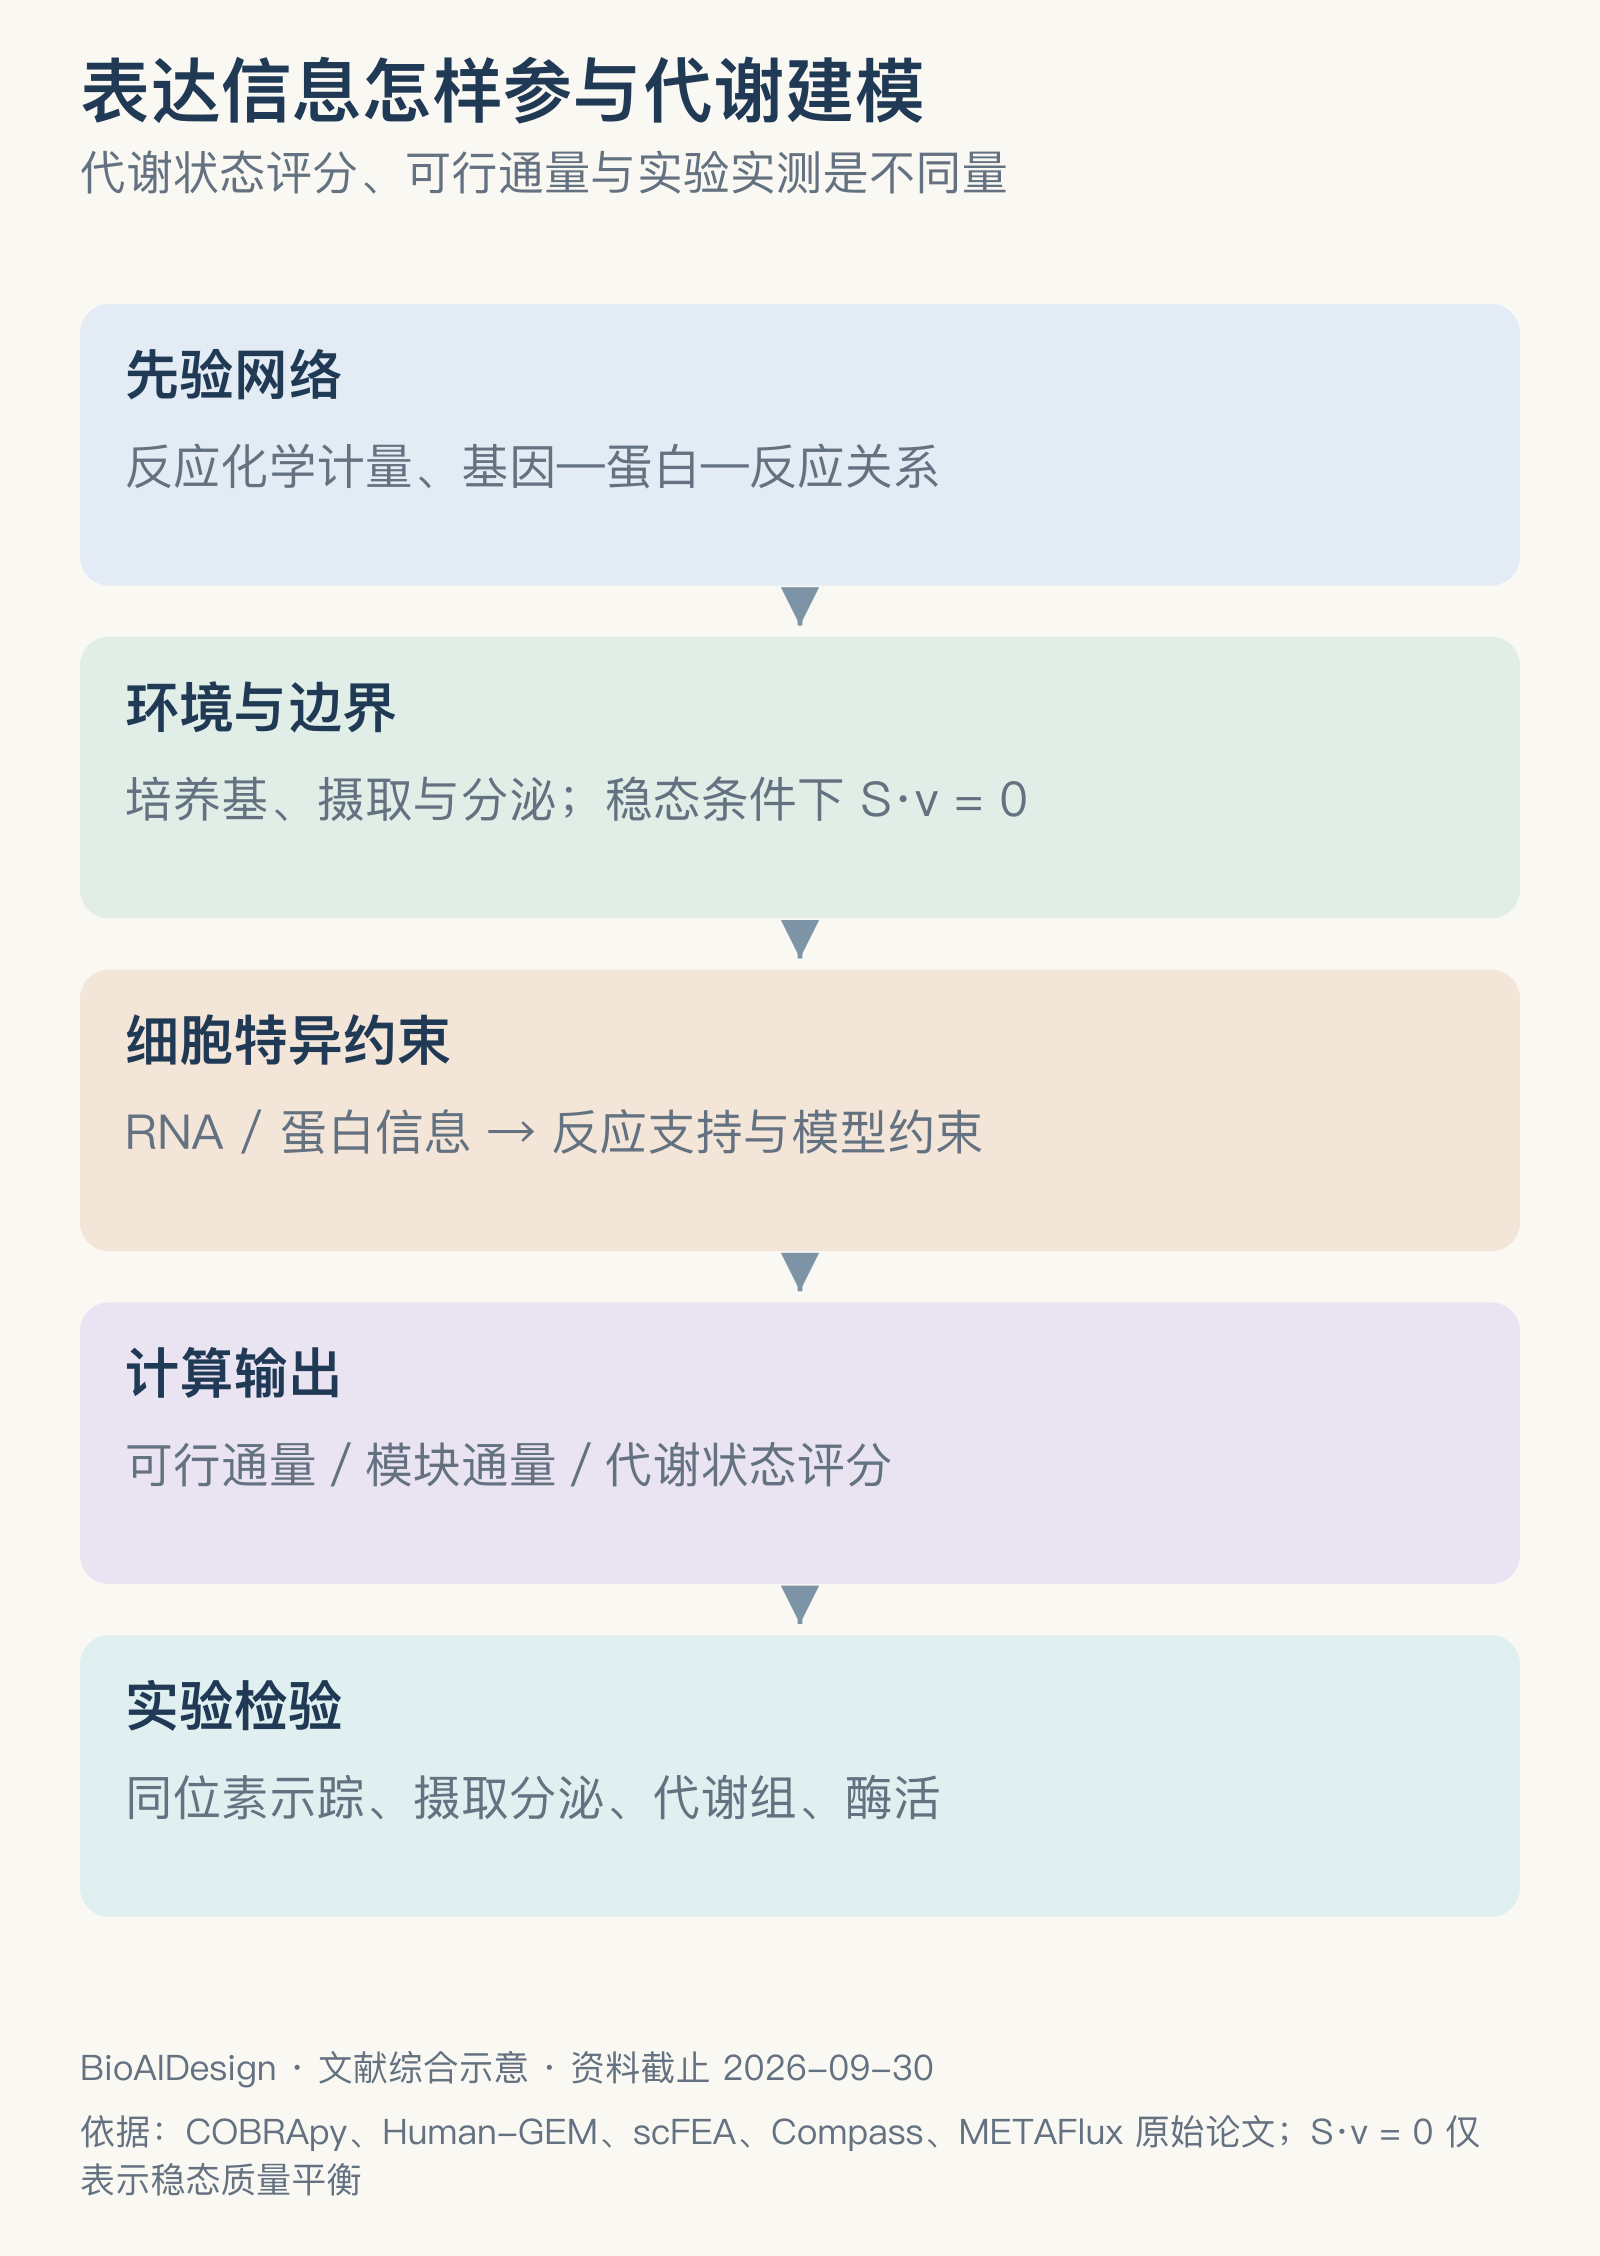
单细胞代谢方法尝试让表达信息参与这些约束。scFEA[43]结合代谢模块、图网络和通量平衡,Compass[44]推断与反应相关的代谢状态,METAFlux[45]还考虑营养环境和细胞群体之间的代谢互作。它们输出的分数或通量估计含义不同,比较前应先核对单位和定义。酶的表达高并不总对应通量高:底物、修饰、抑制和反应可逆性都可能改变两者的关系。
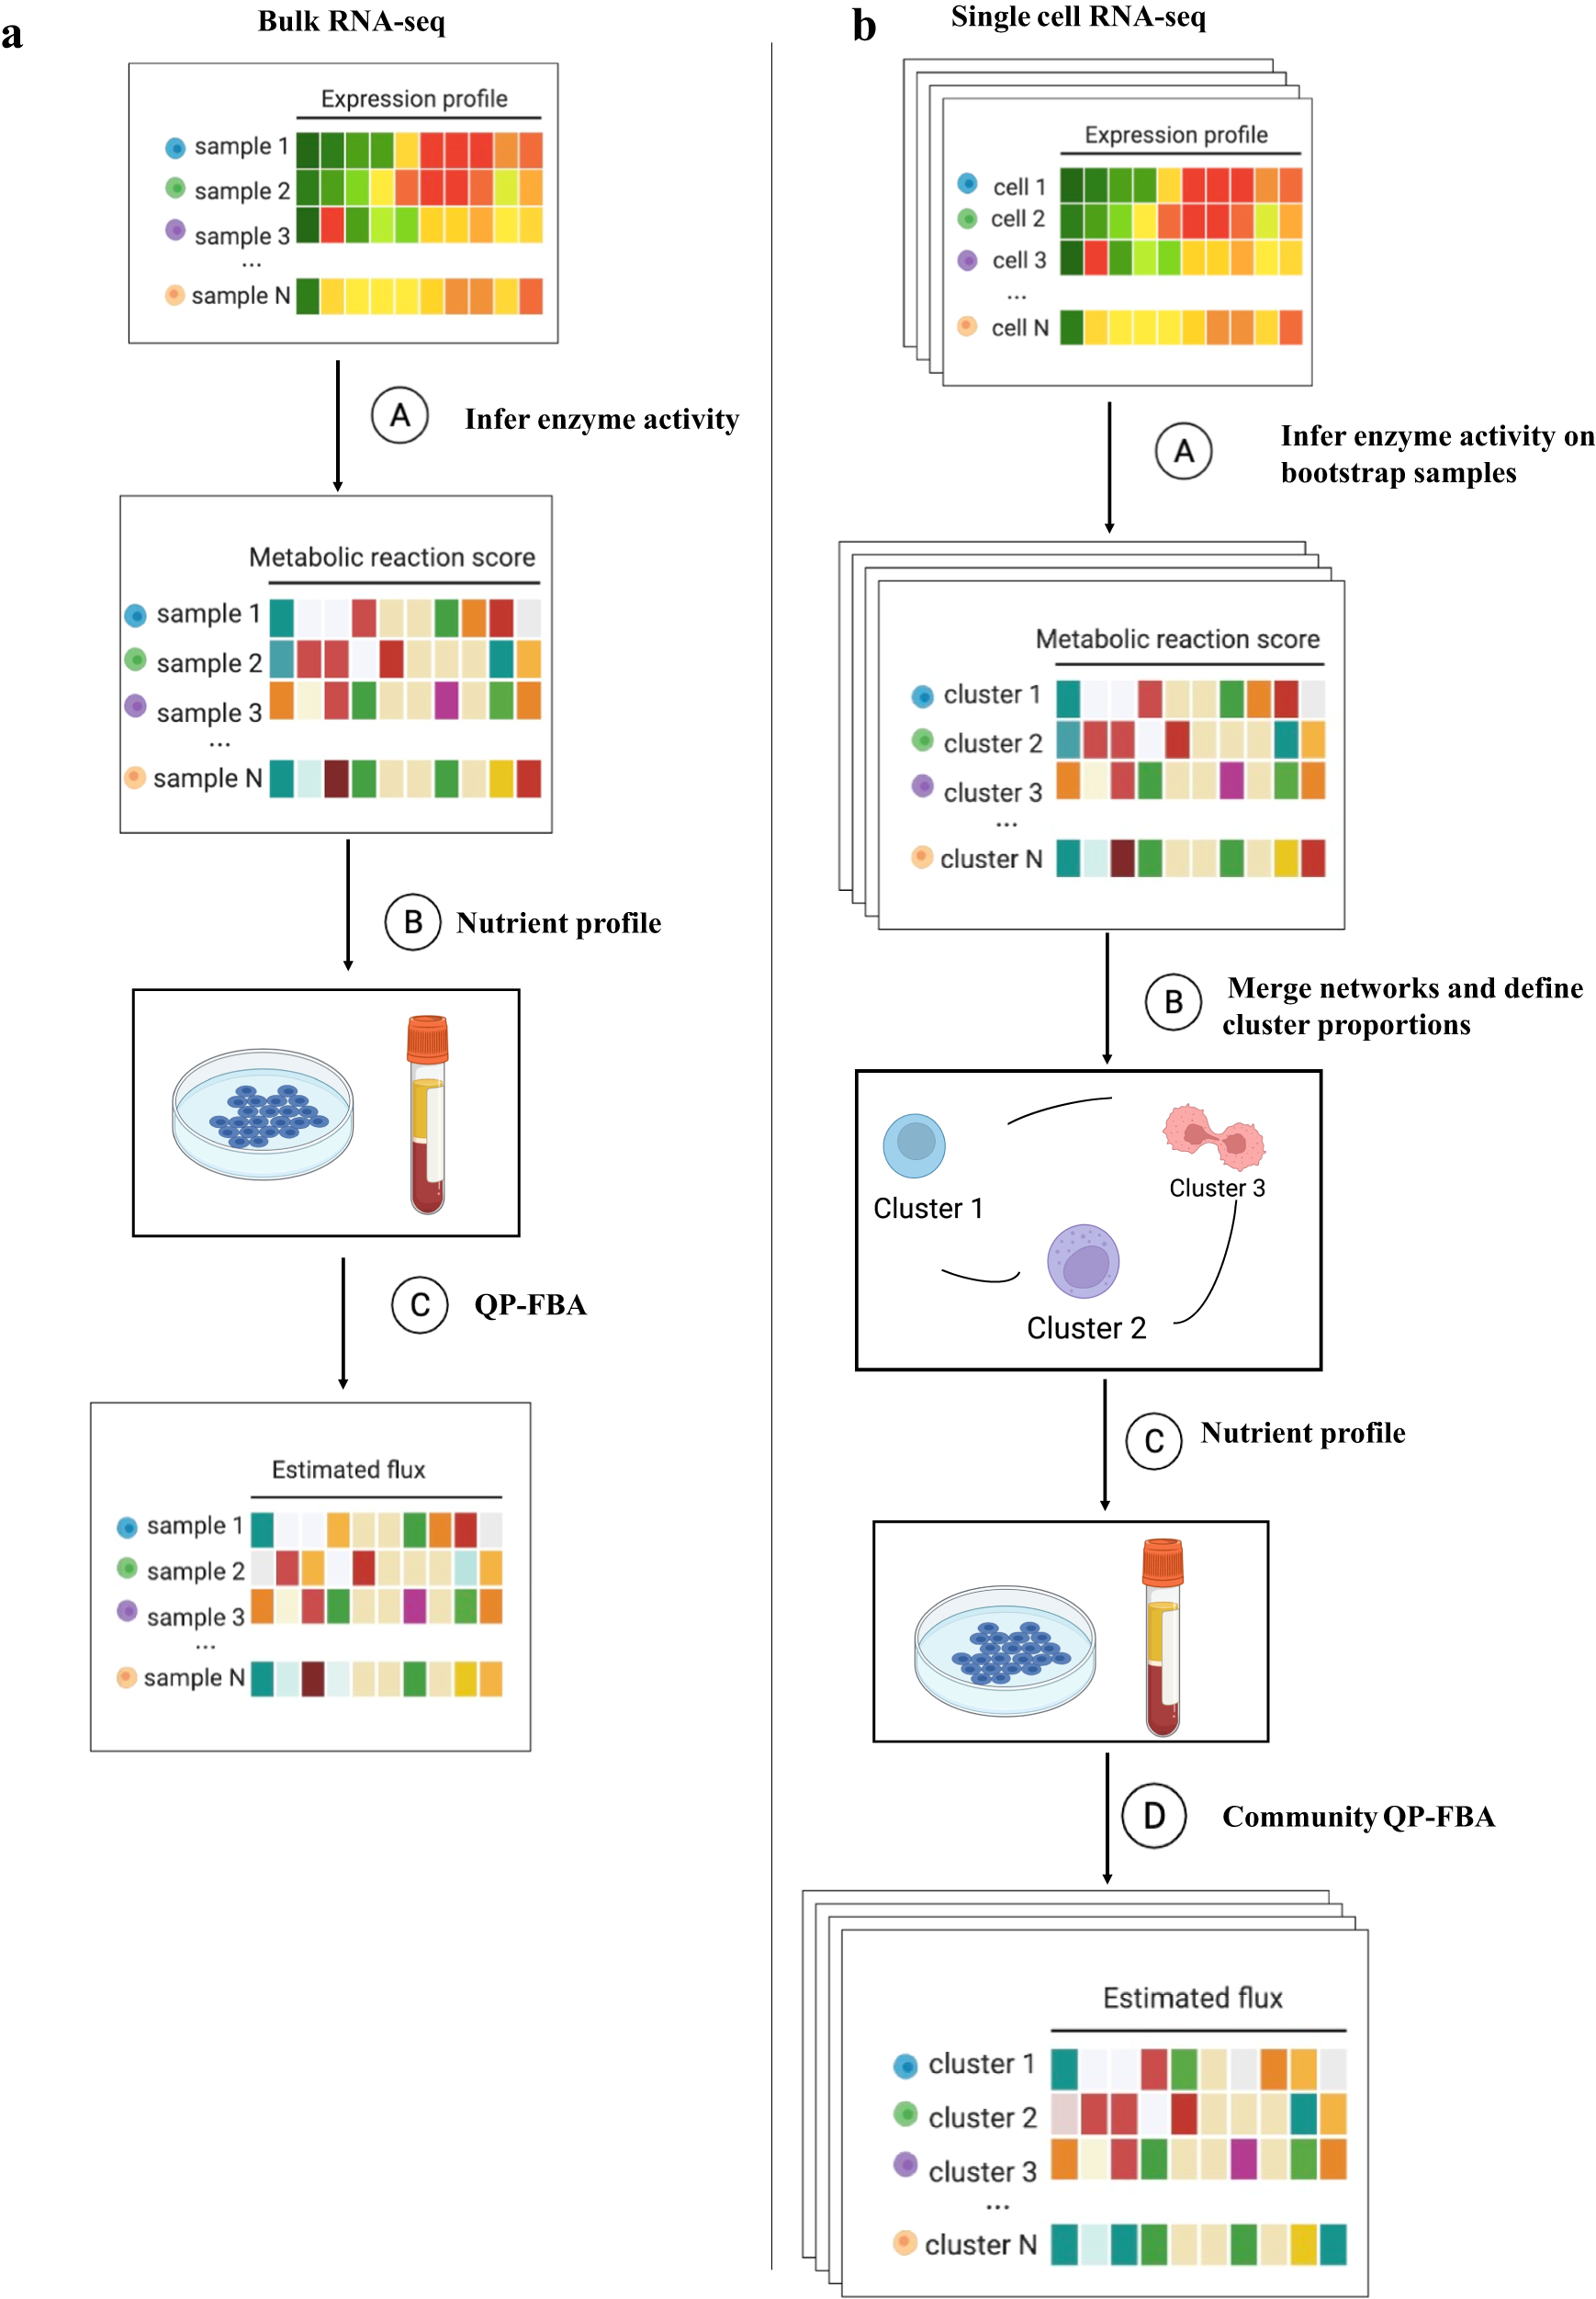
图源:Huang et al., Nature Communications 2023, Fig. 1,doi:10.1038/s41467-023-40457-w;CC BY 4.0,完整原图,未修改。
信号动力学可以继续用VCell或COPASI这样的环境来指定受体、反馈和时间参数,表达模型则提供与状态相关的信息。把两者接起来时,应当说明哪些量来自实验测量、哪些来自网络约束、哪些由学习模型预测。可检验的读出包括同位素示踪、摄取分泌、酶活、磷酸化和时间分辨蛋白组,RNA相关性替代不了这些功能验证。
2026年的ProteinTalks[46]把时间分辨的扰动蛋白组带入模型,报告了超过3800万次蛋白丰度测量,并研究乳腺癌相关的药效、协同以及选定的类器官和样本任务。3800万是测量次数,不是细胞数。蛋白面板、采样时间和实验背景决定了这些预测能回答哪些功能问题。
显微形态、细胞器与图像生成
显微镜能看到RNA难以直接反映的现象:细胞大小、核形态、细胞器结构、蛋白定位、接触和运动。Cell Painting[47]用多通道染色描述形态,CellProfiler提取特征,JUMP[48]和Cell Painting Gallery提供了大量干预相关的图像与处理资源。实验板、孔位、成像设备和分割误差同样会影响形态读数,模型需要把生物变化和技术变化分开。
OpenPhenom是另一个成像入口:公开的S/16版本用通道无关的掩码自编码器(MAE)学习Cell Painting图像表征[49],并支持缺失染色的重建。训练资料包括RxRx3和JUMP-CP的遗传成像数据;RxRx3-core进一步提供图像、嵌入和药物—靶点关联基准。它适合把形态当作可量化的读出来用。模型卡同时注明,明场和H&E不在主要适用范围内,权重采用非商业条款(代码)。
CellFlux[50]用flow matching学习从对照到扰动的形态分布变化,CellFluxV2[51]继续发展成像生成。MorphDiff[52]用L1000表达作为条件引导形态扩散,既能从表达生成图像,也能结合对照图像生成。三者的输入并不相同,不能因为都“生成细胞图像”就看成同一个任务。
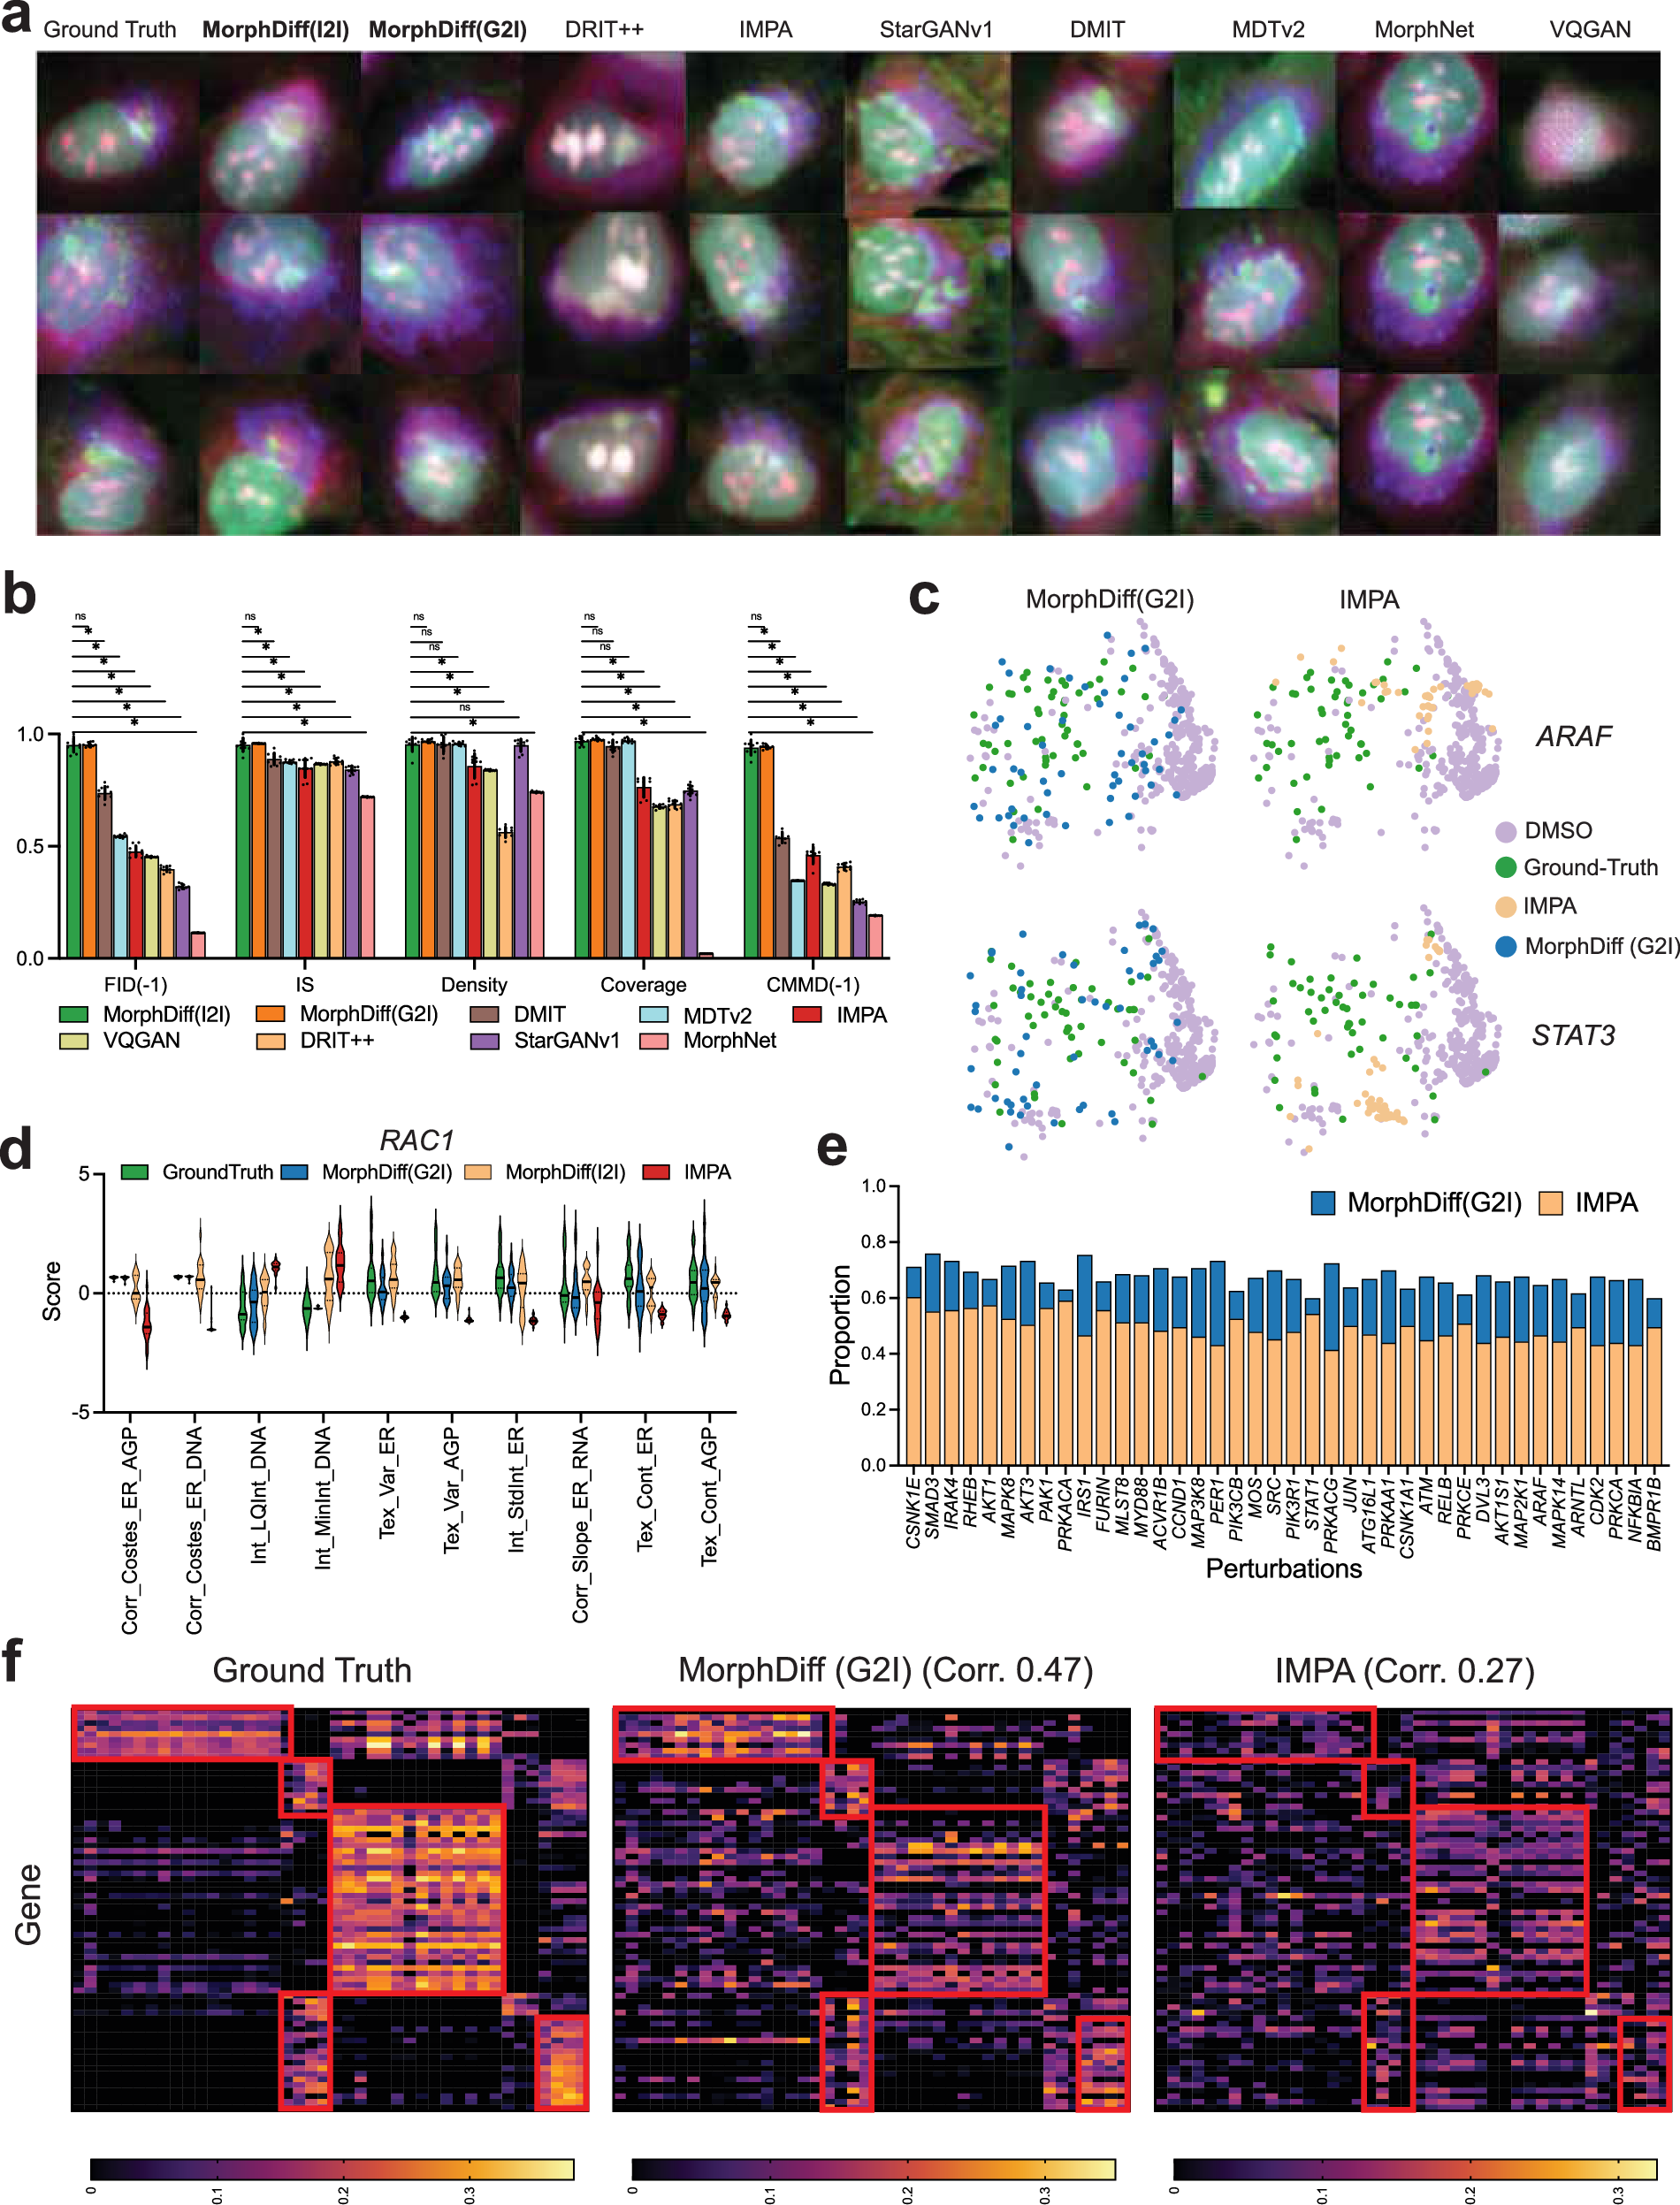
图源:Wang et al., Nature Communications 2025, Fig. 2,doi:10.1038/s41467-025-63478-z;CC BY 4.0,完整原图,未修改。
MorphDiff有一个关键前提:目标扰动后的L1000表达通常作为条件输入。它研究的是跨模态映射,与“只输入药物、预测全部未知响应”有明确差别。评测图像时也应同时看CellProfiler特征、群体分布、机制相关的检索和留出扰动的结果;图像看起来逼真只是证据的一部分。
亚细胞结构方向有三类实用资源。Allen研究所的无标记三维预测[53]从透射光图像推断特定的荧光结构;OpenCell[54]通过内源标记建立蛋白定位与互作图谱;Human Protein Atlas[55]提供组织、细胞和亚细胞定位参考。第一个是专项预测模型,后两个主要是实验图谱,可以为训练和验证打底。
这条路线上值得推进的是联合验证:预测RNA变化的同时,能否预测核形态、细胞器定位或运动的变化?如果不同读出互相矛盾,可能说明输入里缺了蛋白状态、时间信息或微环境约束。多模态模型的价值,正要靠这种可检查的一致性来体现。
空间邻域与细胞通信
解离式单细胞技术会丢掉细胞原本的邻居。空间转录组和多重蛋白成像把位置、组织结构和局部细胞组成重新带回模型。同一种细胞在不同邻域里可能功能不同,虚拟细胞的输入因此需要包含“它在哪里、与谁相邻、周围有什么信号”。
Nicheformer[56]在SpatialCorpus-110M上预训练,其中5700万为解离细胞、5300万为空间细胞,覆盖人和小鼠的73种组织(代码)。它研究如何从表达中学习空间上下文,并适配相关任务。对解离样本,模型给出的空间属性是推断;只有带位置信息的实验,空间关系才有直接测量支持。
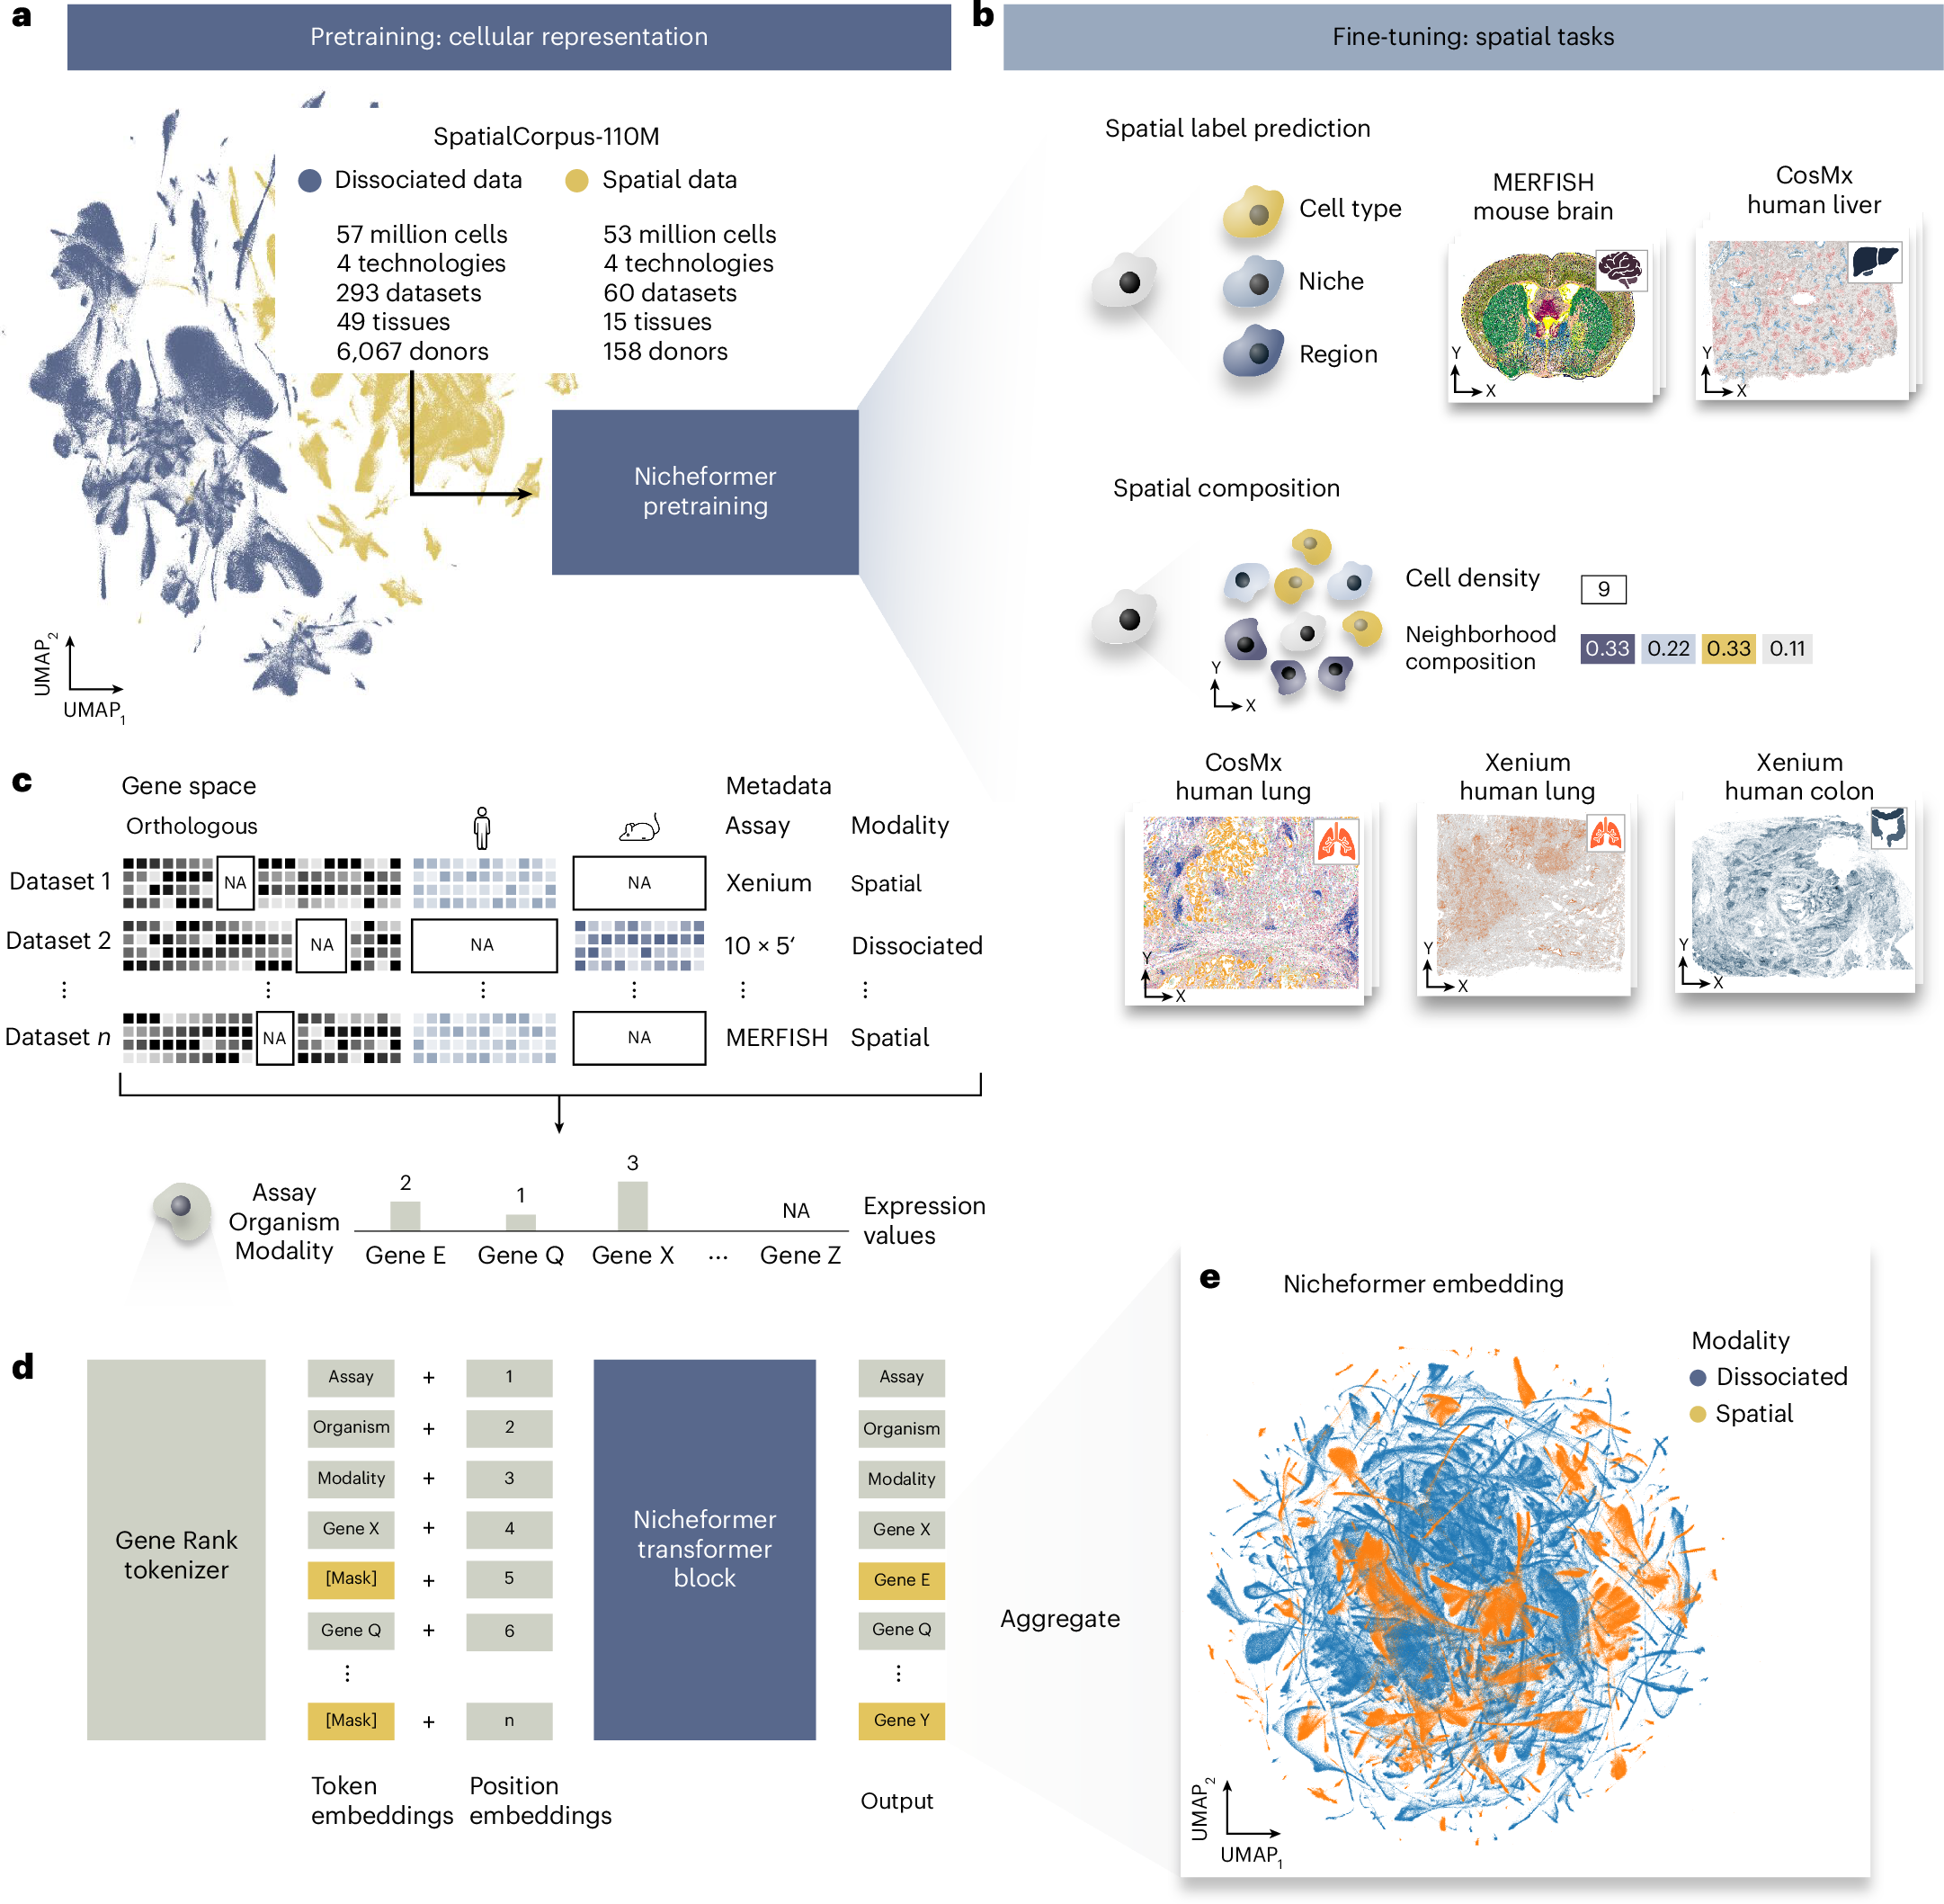
图源:Tejada-Lapuerta et al., Nature Methods 2025, Fig. 1,doi:10.1038/s41592-025-02814-z;CC BY 4.0,完整原图,未修改。
VirTues[57]走空间蛋白路线,学习marker、细胞、生态位和组织四个层次的表示,并处理不同实验marker面板不一致的问题。论文包含细胞类型、生态位、空间标志物和患者分层任务,也报告了选定癌症队列中的独立验证(代码与权重说明)。这类临床相关结果对应具体的队列和读出,不能直接理解为对组织发育或治疗过程的完整模拟。
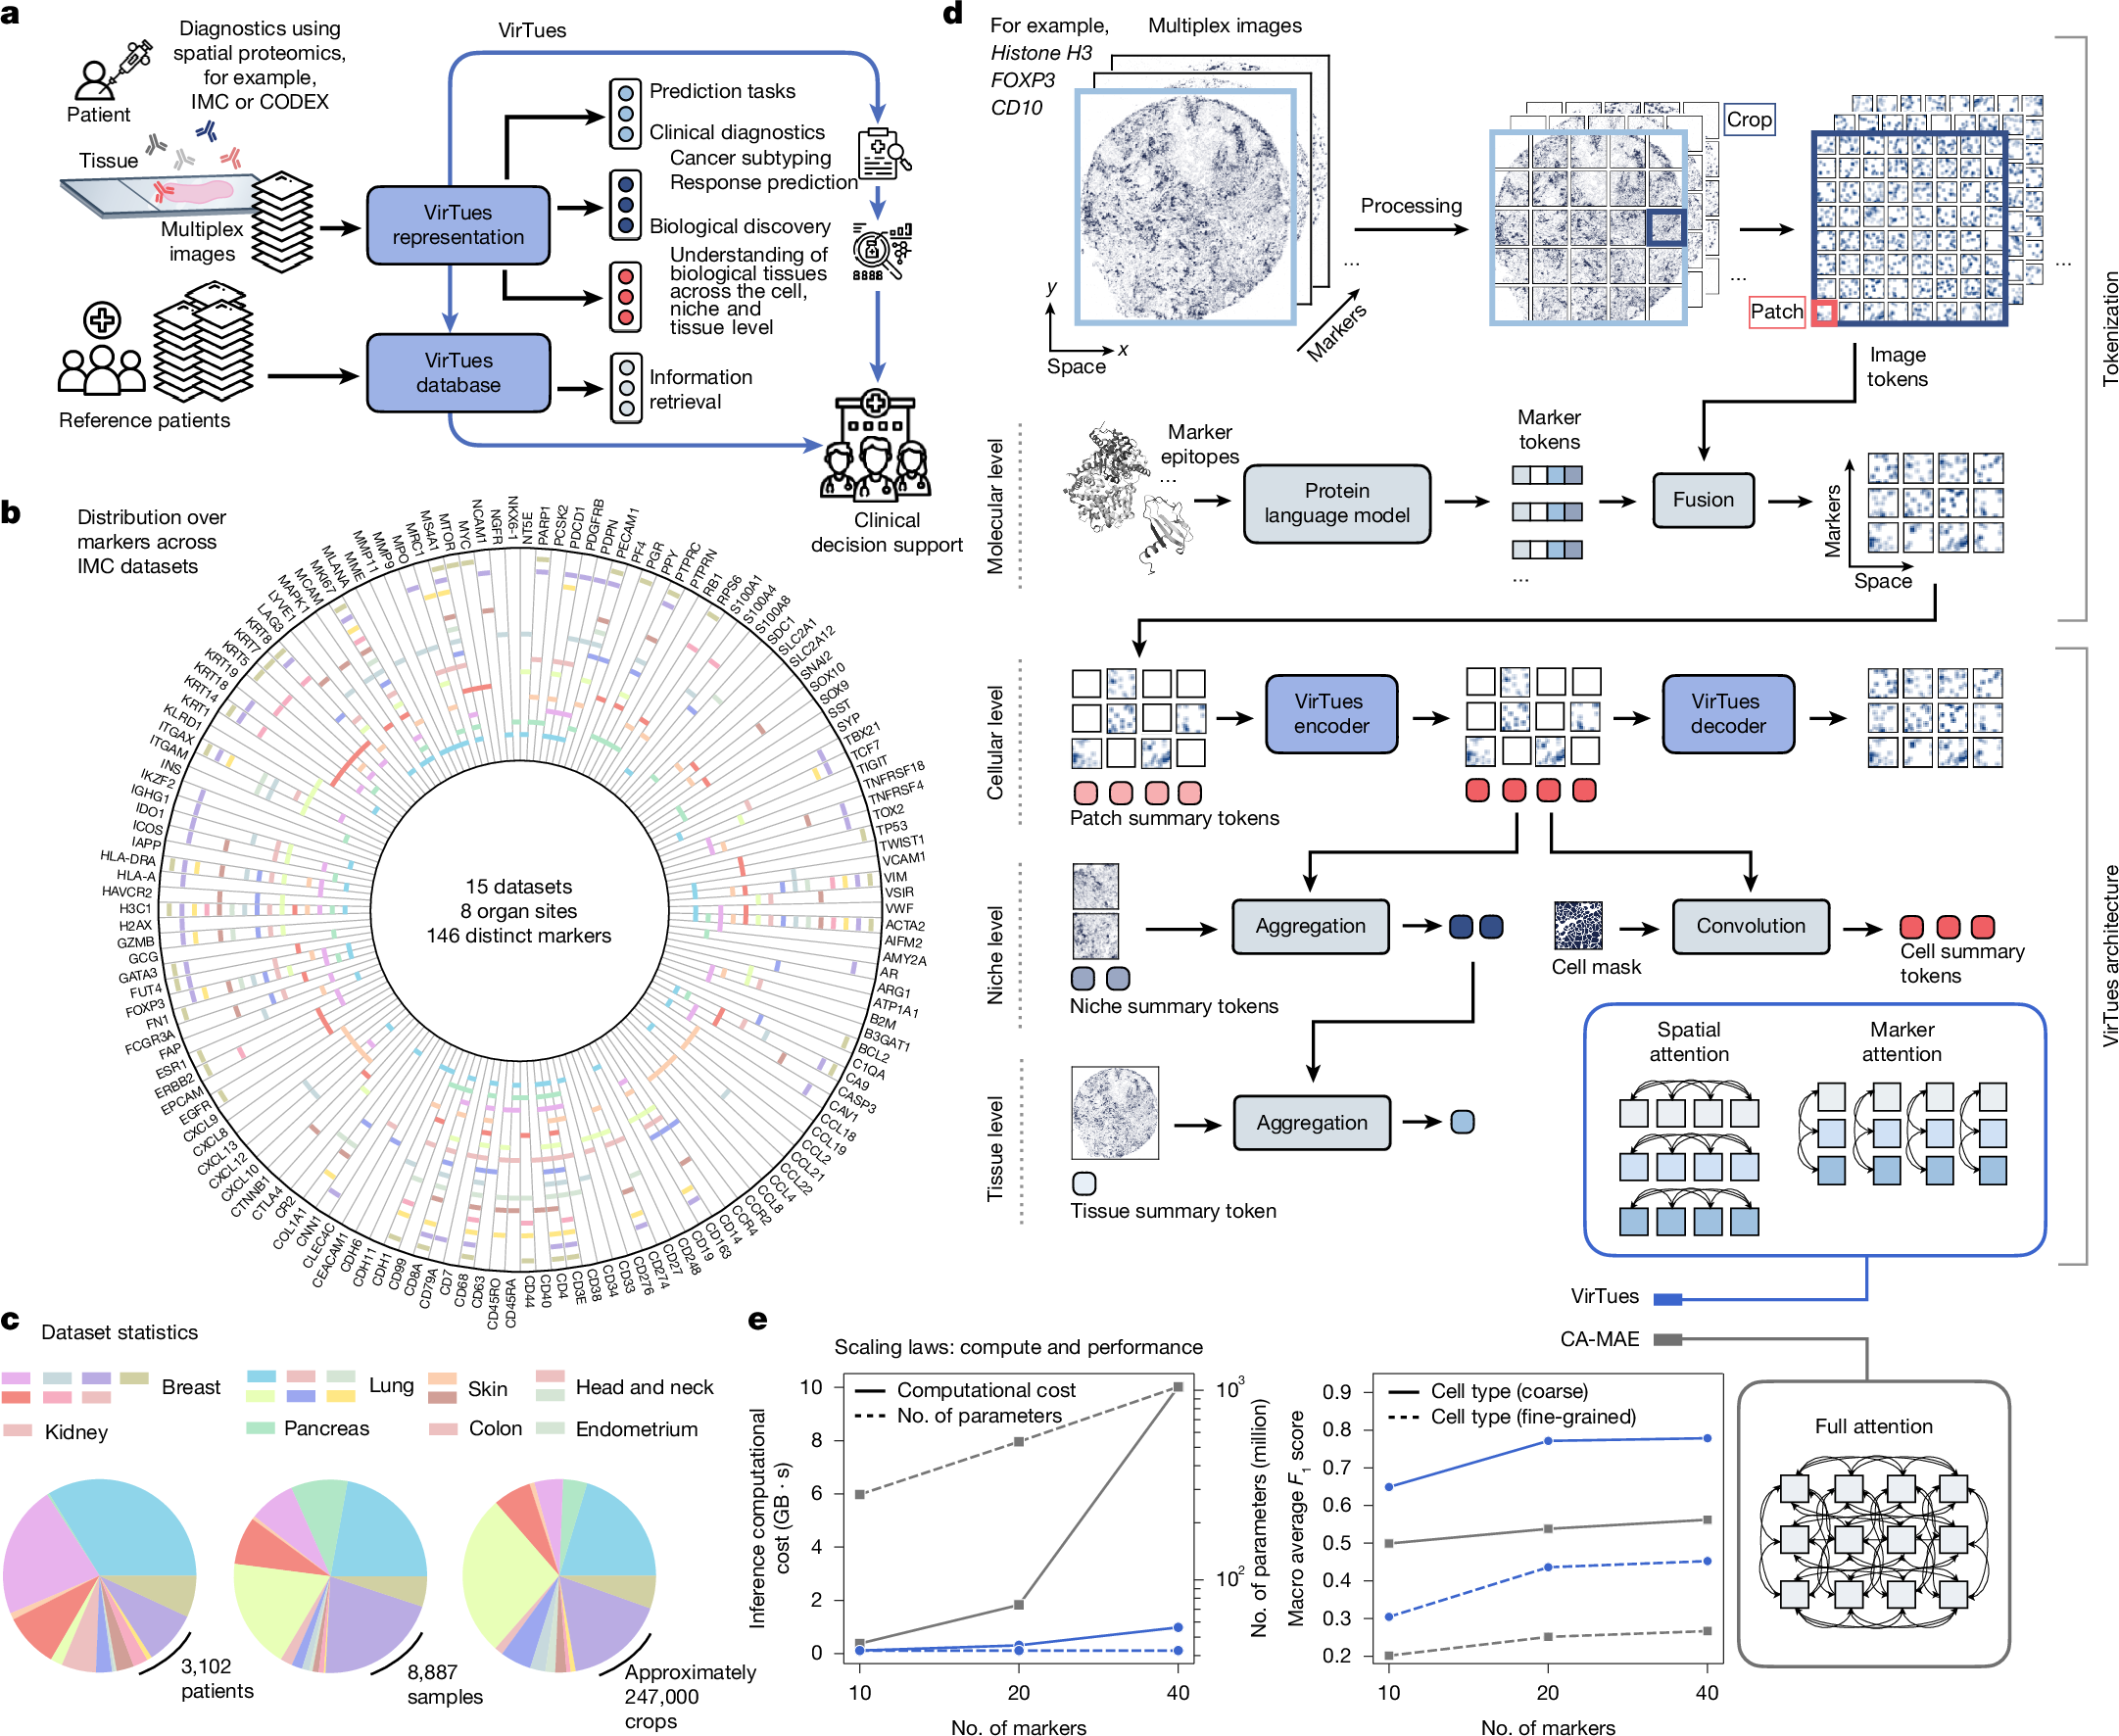
图源:Wenckstern et al., Nature 2026, Fig. 1,doi:10.1038/s41586-026-10884-y;CC BY 4.0,完整原图,未修改。
CellChat[58]、NicheNet[59]和COMMOT[60]为细胞通信提供了可分析的连接,分别关注配体受体与通路、配体到下游靶基因,以及受空间距离和竞争影响的通信。它们能帮助设计阻断、共培养或下游读出实验;表达共现和通信分数本身还需要这些实验来支持。NicheFlow[61]更进一步,用局部细胞点云连接连续的空间切片,联合建模表达与坐标的演化。
在实验设计上,空间信息最有价值的地方可能是解释背景依赖:同一个干预在不同组织邻域里为什么结果不同?回答这个问题,除了预测表达,还要检验细胞组成、距离、接触、扩散及其随时间的变化。
组织、胚胎与数字生物体
组织的形成涉及细胞增殖、死亡、迁移、力学和扩散环境。PhysiCell[62]、CompuCell3D[63]和Morpheus[64]显式处理多细胞行为,分别提供基于细胞代理或Cellular Potts的建模路径。研究者可以指定周期、运动、黏附和微环境规则,再检验组织层面的结果。这些平台的规则和参数可解释,代价是通常需要人工建模和实验校准。
以肿瘤球为例,内部的营养梯度、细胞周期和死亡会形成空间异质性。多细胞模型可以检查某种坏死规则、扩散边界或力学机制是否足以产生相应结构。它与单细胞表达模型的互补之处,在于把细胞状态放进一个会相互作用、会运动、有边界的环境。
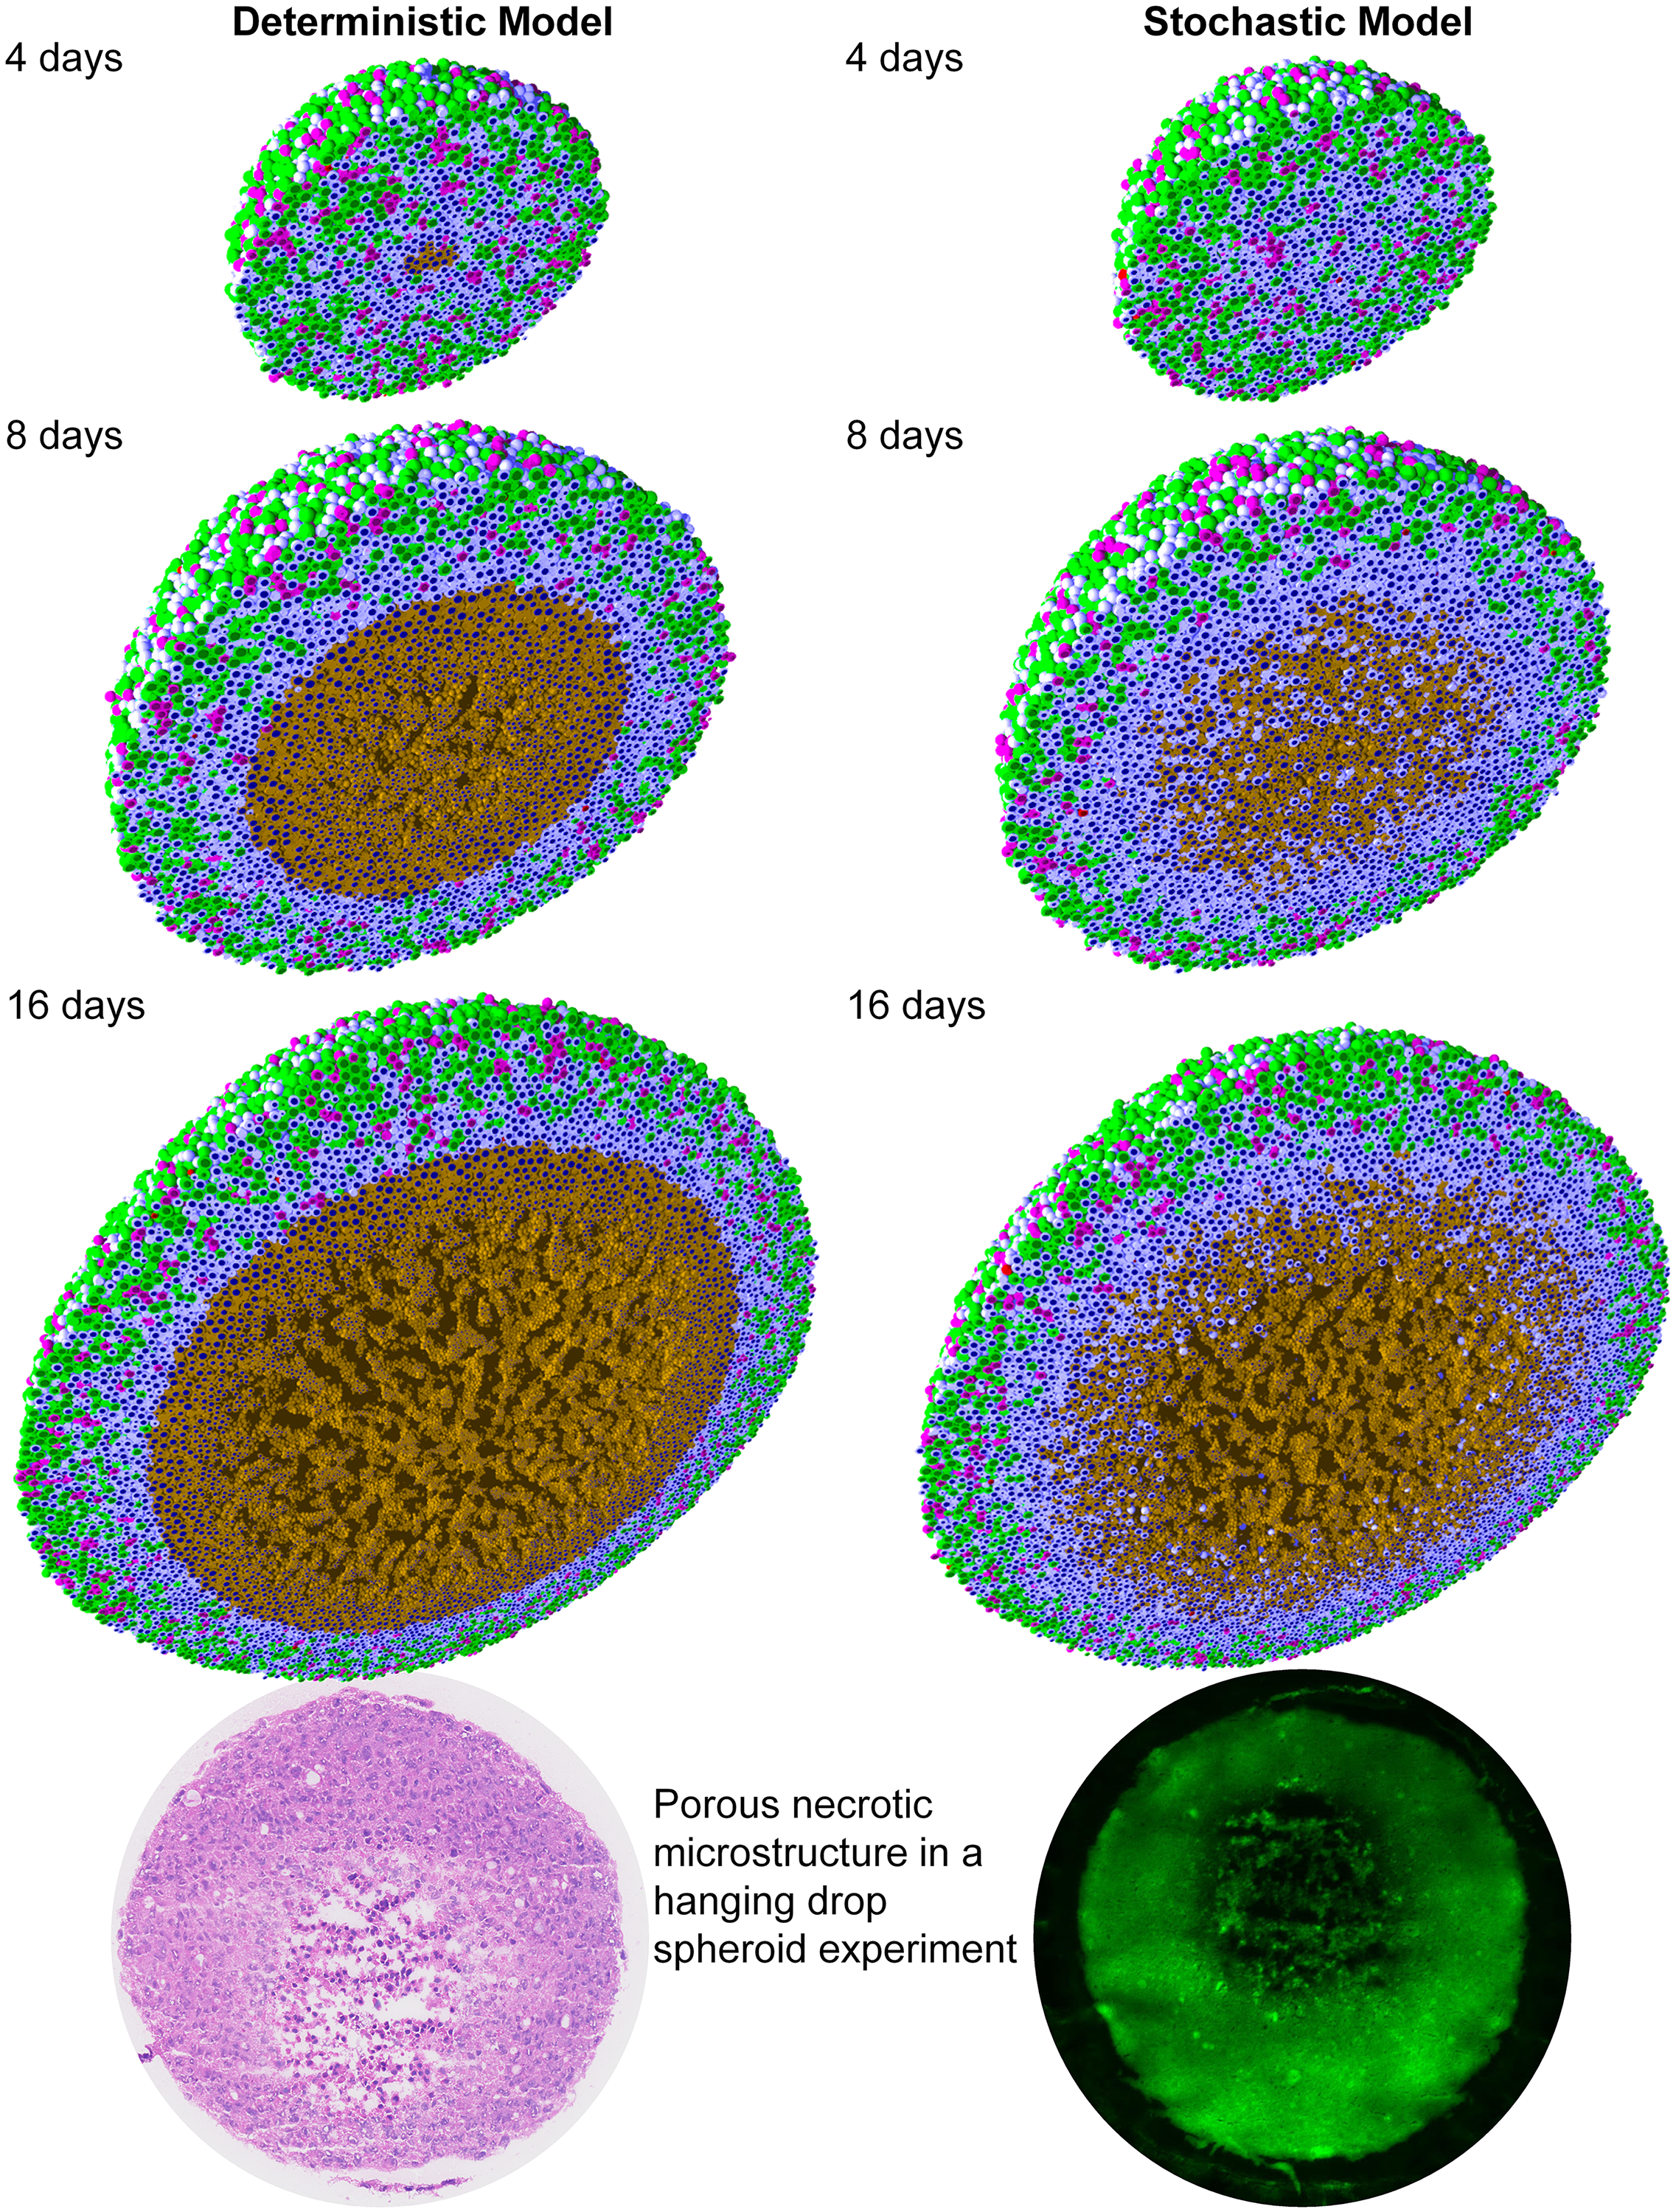
图源:Ghaffarizadeh et al., PLOS Computational Biology 2018, Fig 2,doi:10.1371/journal.pcbi.1005991;CC BY 4.0,完整原图,未修改。实验照片署名:Mumenthaler lab, USC。
胚胎把这些问题推到真实的发育时间上:细胞何时出现、在哪里分化、如何组成器官,突变又怎样改变结构。Virtual Embryo Challenge把未来表达预测、表达与三维坐标的联合预测、留出突变体列为三个任务。整套资源约100万细胞、11个阶段;截至检索日,公开的训练部分是9个数据集、273481个细胞,整体规模不能当作已经释放的训练集。
更高尺度的数字生物体还有OpenWorm[65],它尝试通过神经、肌肉和身体等组件把细胞层的机制与行为连接起来。2026年的虚拟酵母文章[66]提出围绕细胞功能组织模块、与实验迭代的路径;AIDO数字生物体观点[67]和细胞世界模型文章[68]讨论多尺度表示和运行系统。它们有的是长期项目,有的是路线图和观点,完成状态应分开看待。
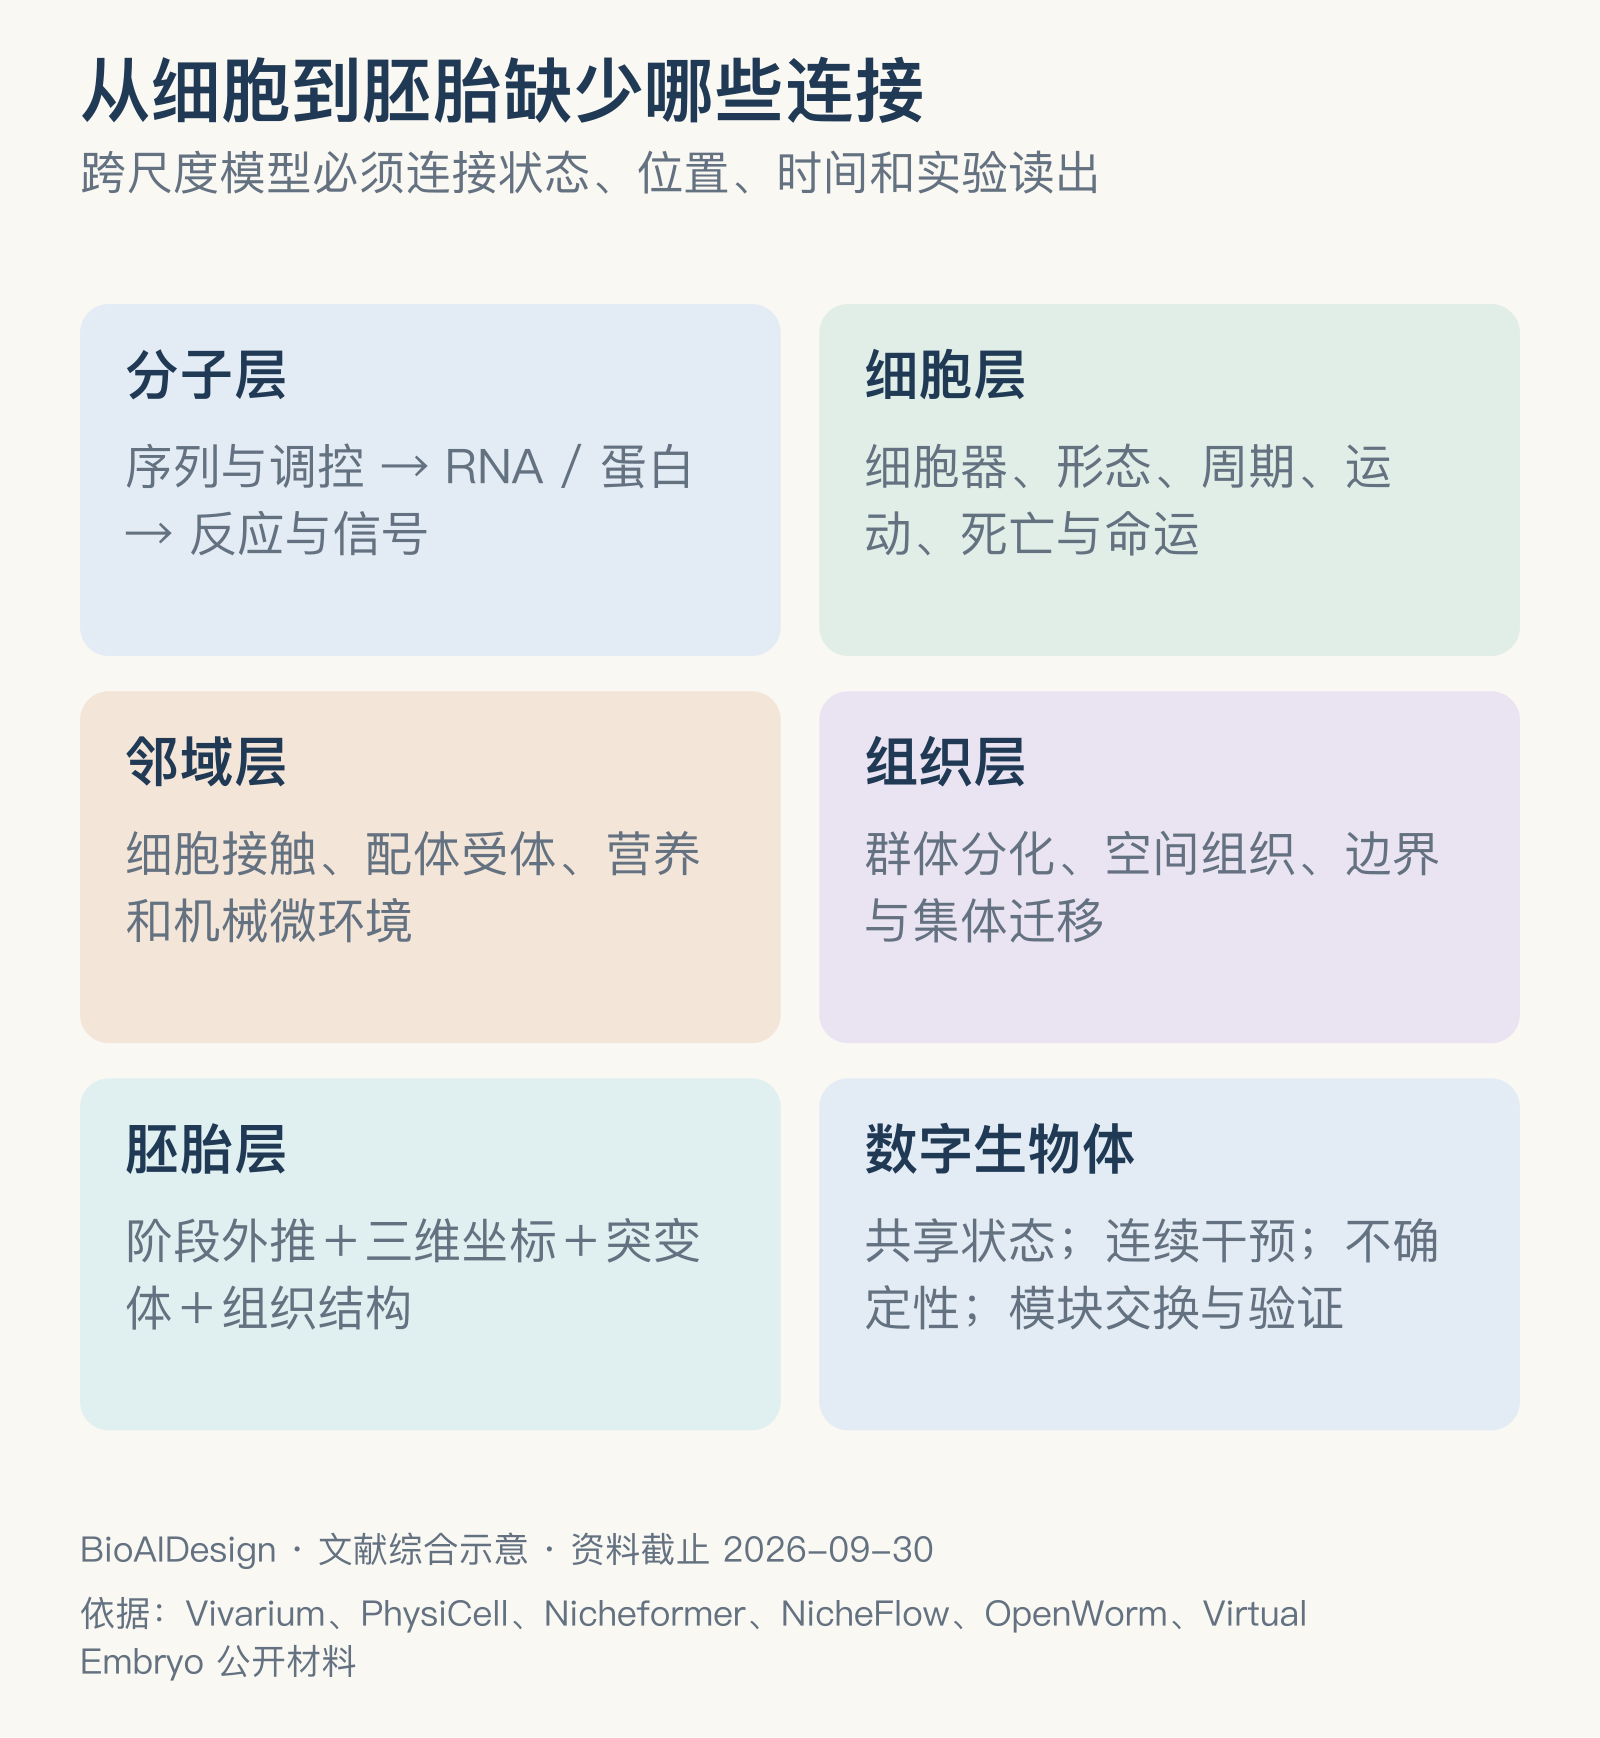
跨尺度的关键在接口。表达模型输出什么量,机制模型才能直接使用?细胞行为又怎样改变空间环境和下一步的输入?模型之间需要一致的时间、单位、边界和不确定性表达。否则,即使每个模块单独表现不错,组合之后也可能出现不稳定或生物学上自相矛盾的状态。
State、Tahoe与干预后的细胞群体
扰动预测仍是最容易形成明确训练目标和实验对照的路线。早期的scGen[69]通过潜空间差向量迁移响应,CPA[70]研究扰动、剂量与协变量的可组合表示,GEARS[71]借助基因关系图预测单基因和组合干预,CellOT[72]用神经最优传输学习未配对群体之间的变化。它们对应的归纳假设和泛化目标各不相同。
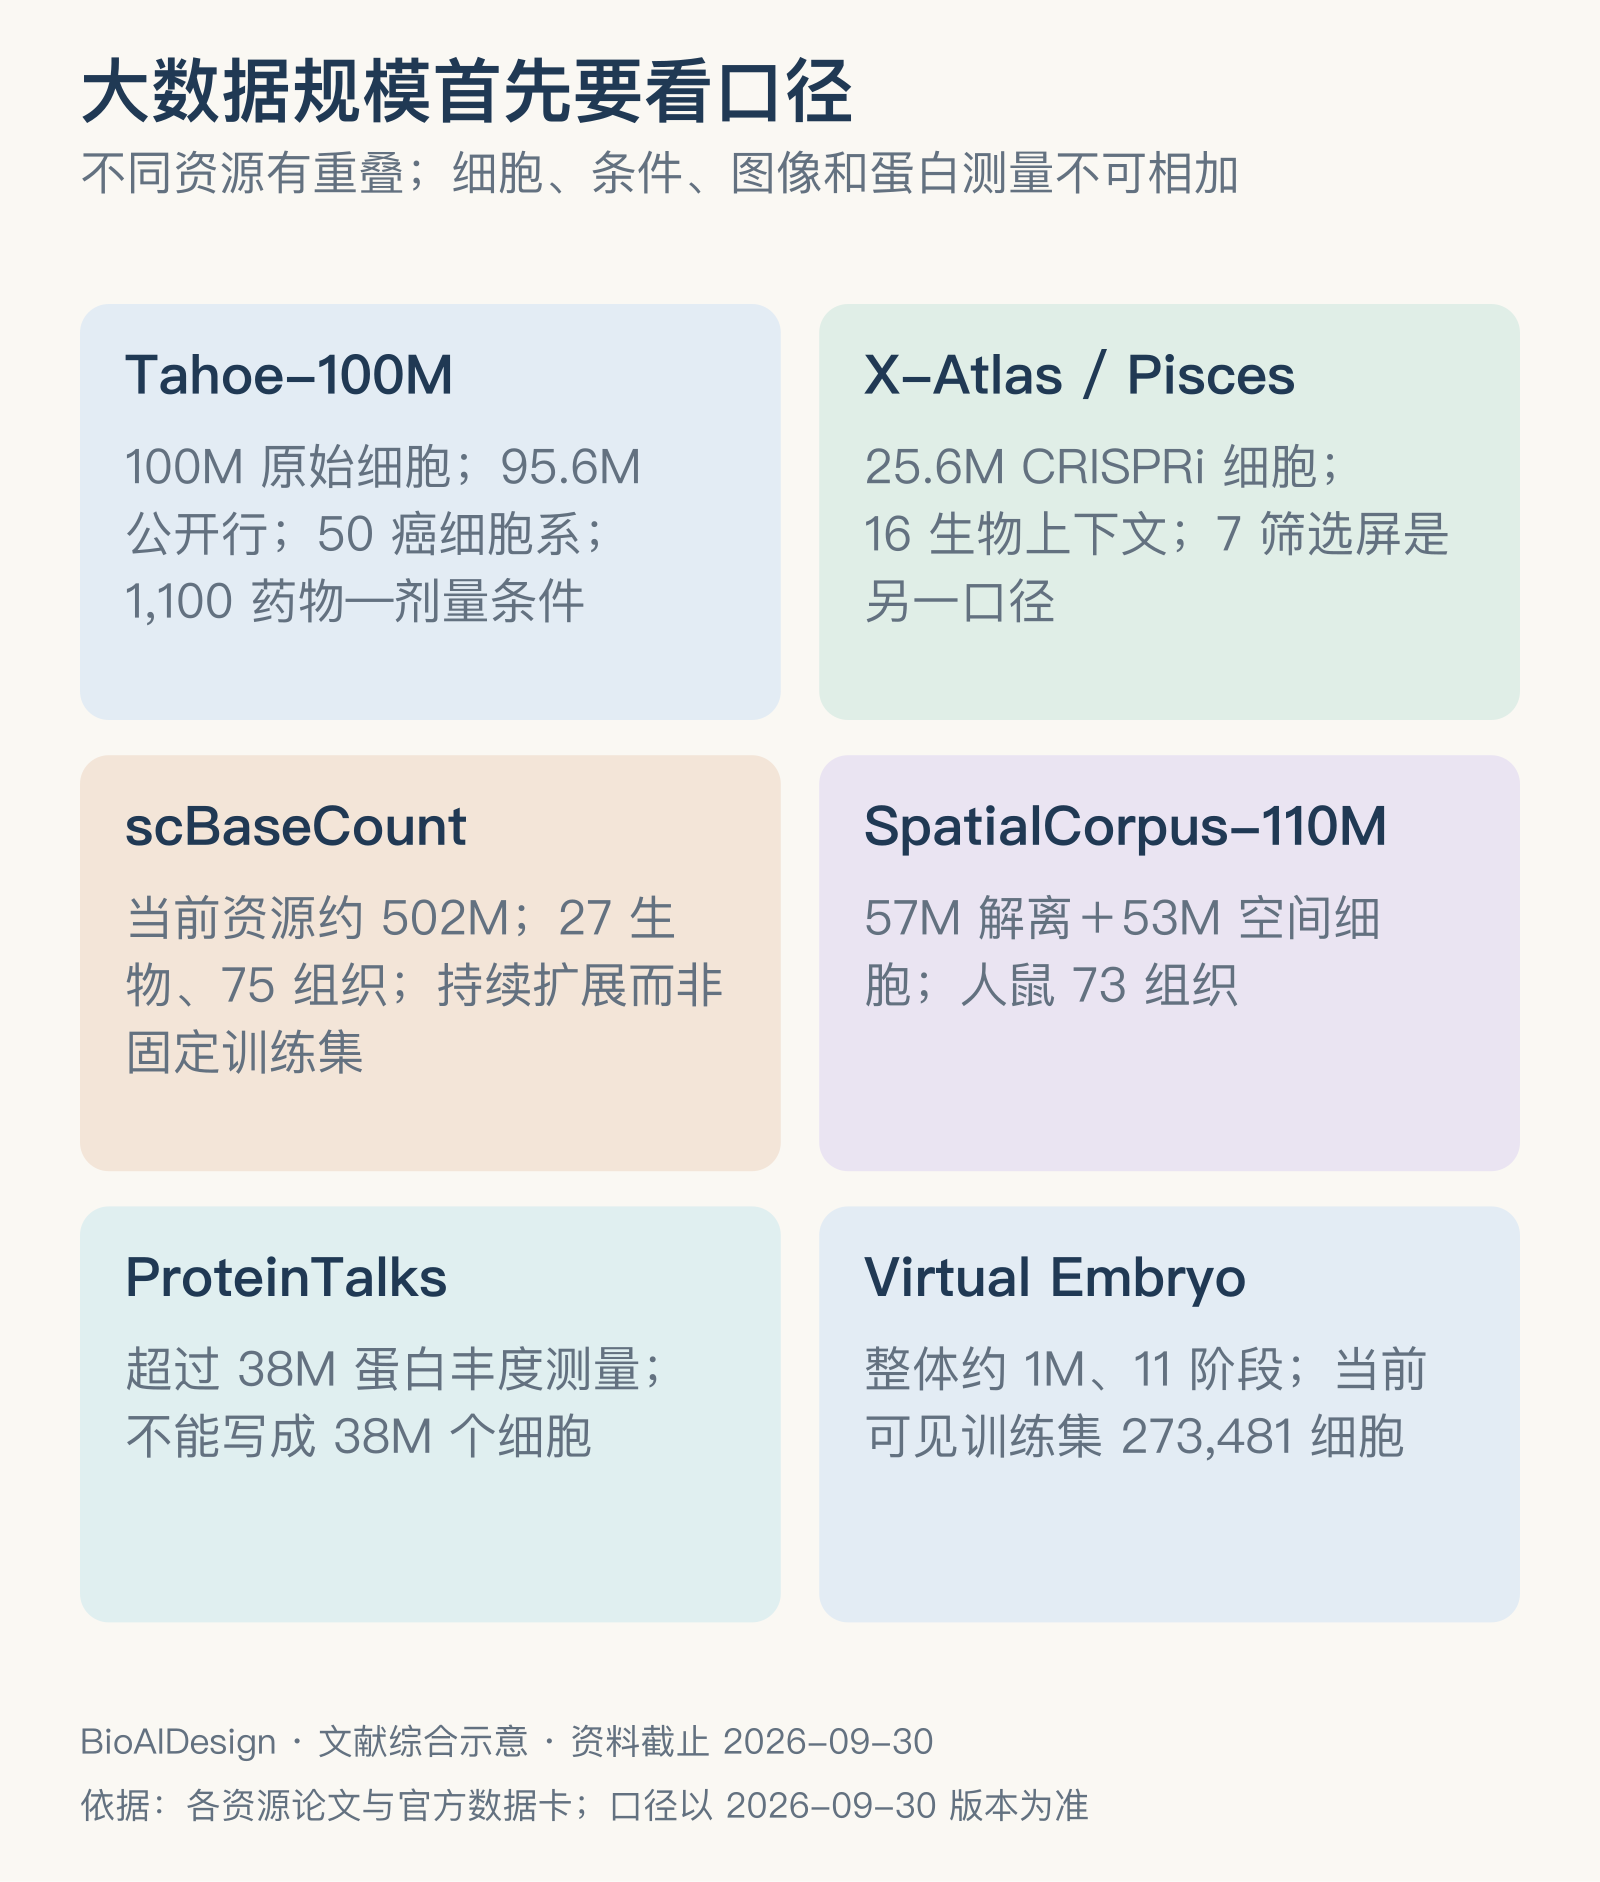
近两年的变化首先来自数据。Tahoe-100M[73]是大规模药物扰动转录组资源,正式论文包含50个癌细胞系和1100个药物—剂量条件;1亿是原始规模,公开数据卡约为9560万行。X-Atlas/Pisces[74]提供2560万CRISPRi细胞,论文里的16个生物上下文和README里的7个筛选屏是两种计数口径。scBaseCount[75]是持续扩展、统一处理的观察性资源,当前官方口径约为5.02亿细胞、27种生物、75种组织。
State[76]由状态嵌入(SE)和状态转移(ST)两部分组成,职责不同。ST以细胞集合为单位建模,群体的分布和异质性因此能进入预测。Arc研究所的官方发布分别列出SE使用近1.7亿观察细胞、ST使用超过1亿扰动细胞,覆盖70个人类细胞上下文(官方仓库)。这些语料之间有重叠,不能加成一个不重复的总量。
Tahoe-x1[77]是一个模型系列,包含7000万、13亿和30亿参数三个版本,使用扰动和其他转录组语料,面向癌症相关的下游任务。官方README列出的预训练口径约为2.66亿细胞,并区分了数据过滤和训练阶段。它与Tahoe-100M的角色不同:前者是可适配的模型,后者是实验数据。能否胜任某类干预任务,要看具体的checkpoint、微调方式和数据划分。
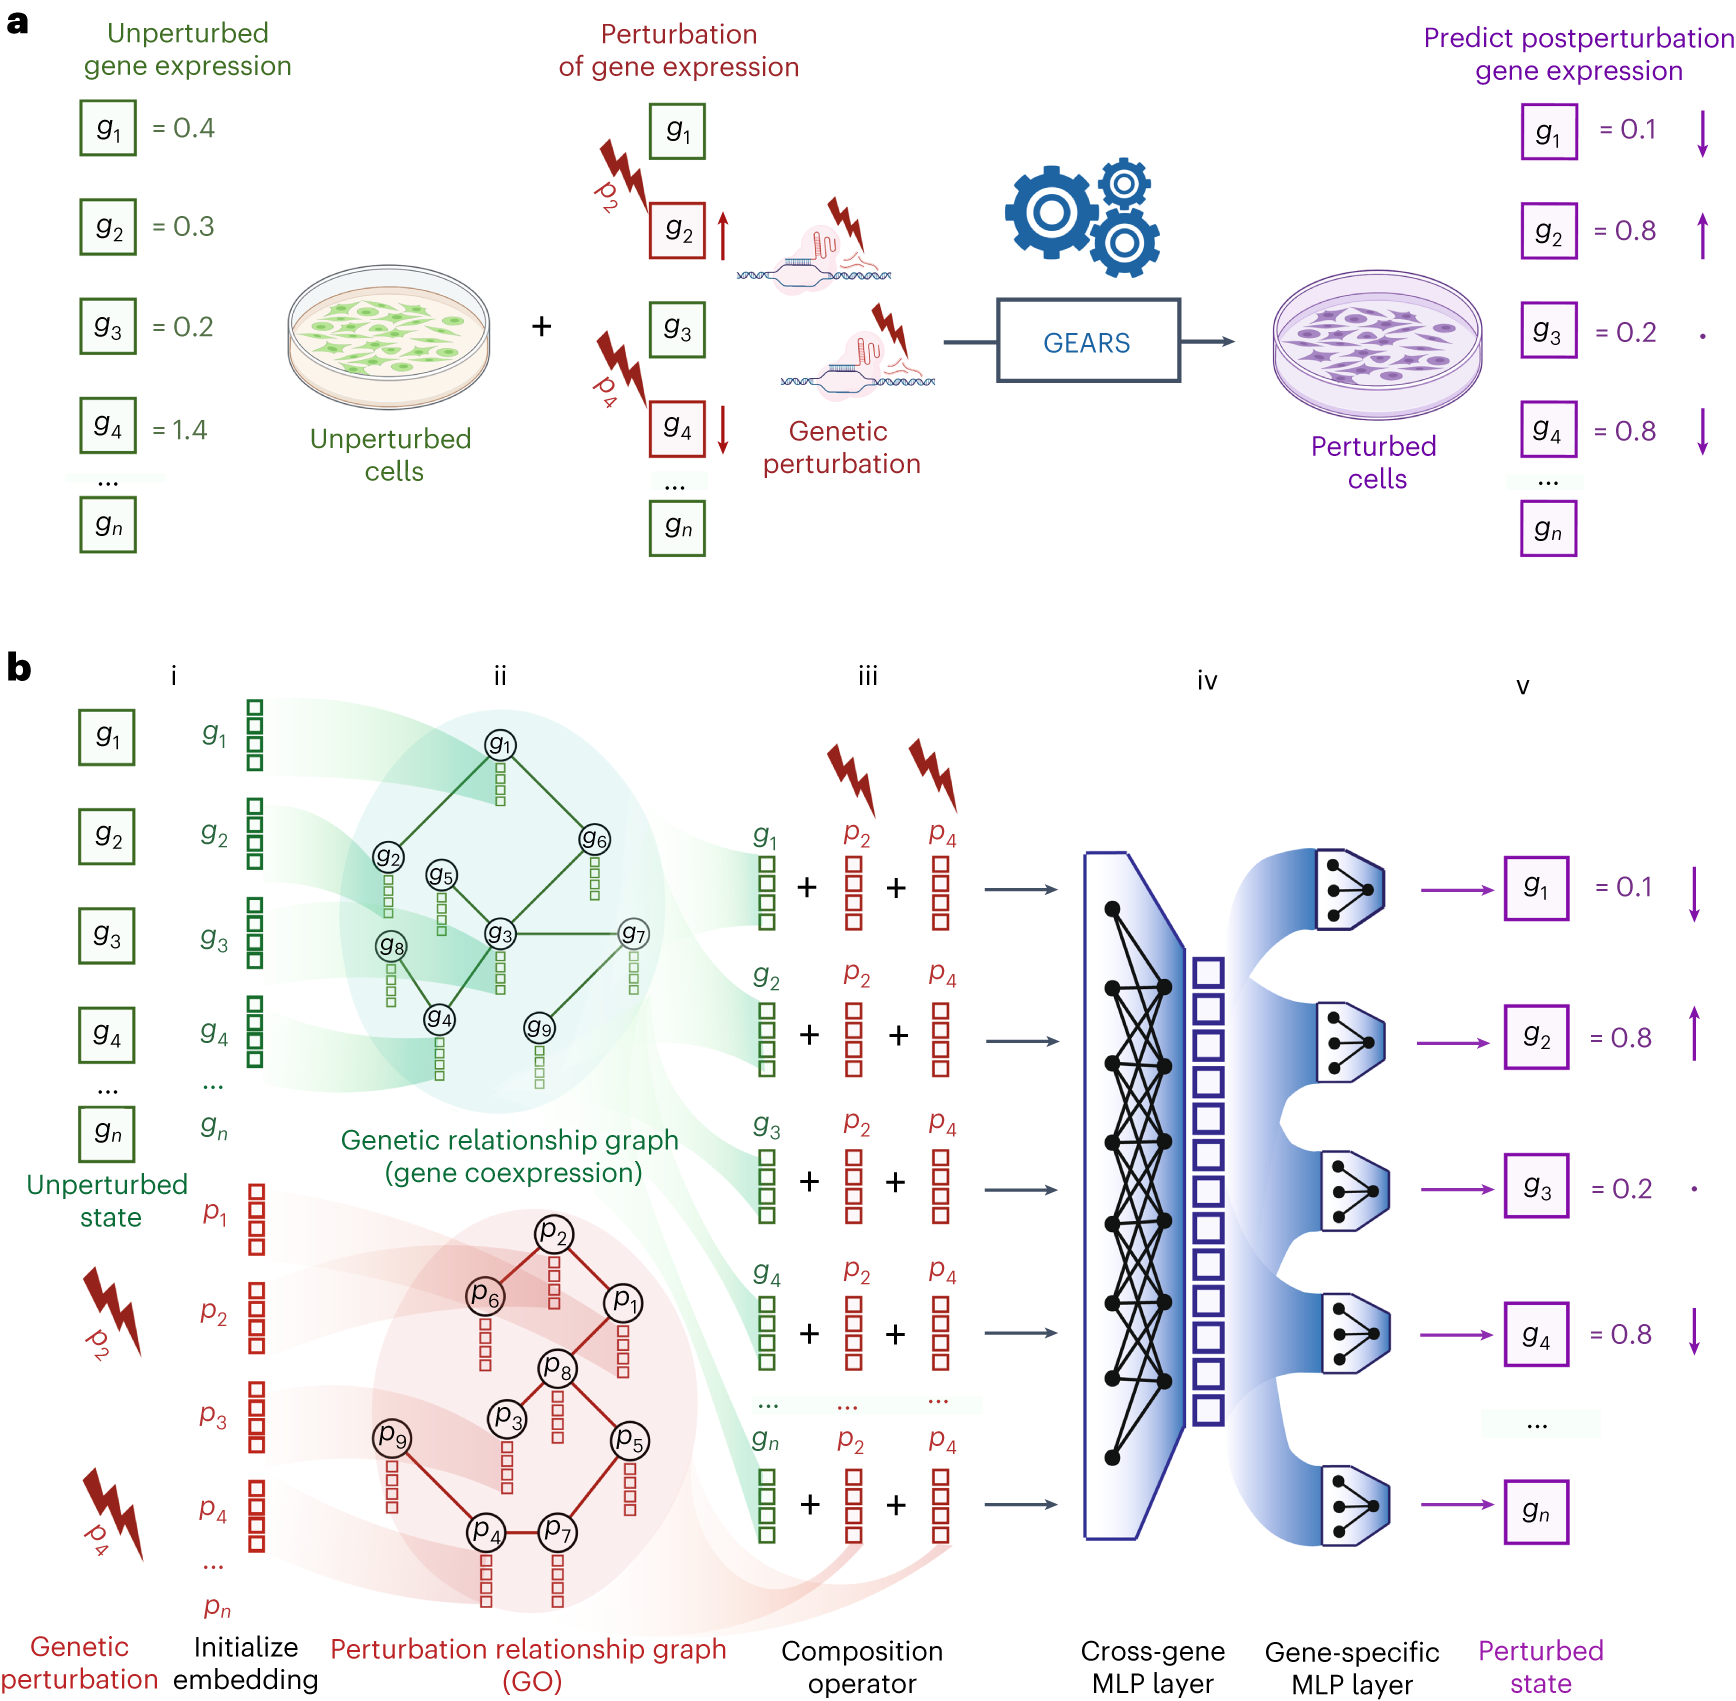
图源:Roohani et al., Nature Biotechnology 2023, Fig. 1,doi:10.1038/s41587-023-01905-6;CC BY 4.0,完整原图,未修改。
X-Cell[74]探索扩散语言模型和多类生物先验;Lingshu-Cell[28]探索离散的全转录组生成;OCOO-T[78]把连续表达、干预和剂量条件放进flow matching。这些2026年的工作展示了不同的生成路径,资源状态则需要逐项核查。例如X-Cell仓库的README在检索日仍注明权重和推理代码“coming soon”,虽然同时展示了模型卡和示例API,还不能据此认为可以完整复现。
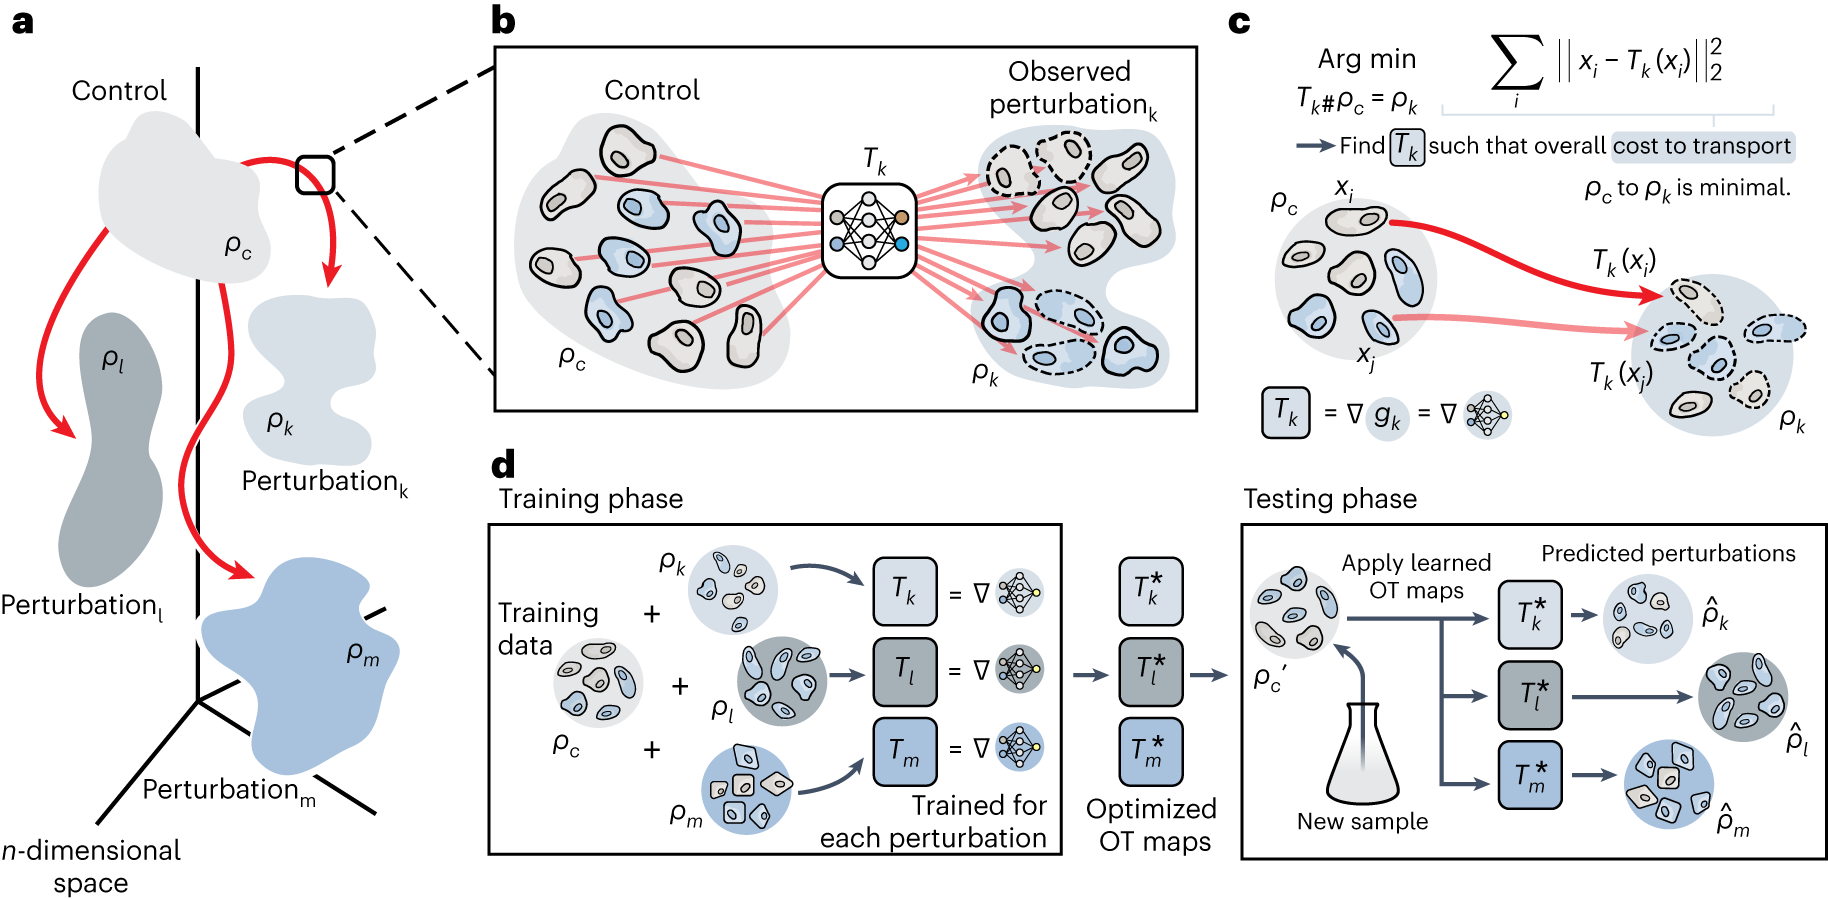
图源:Bunne et al., Nature Methods 2023, Fig. 1,doi:10.1038/s41592-023-01969-x;CC BY 4.0,完整原图,未修改。
另外两项工作把扰动预测接到了化合物筛选和患者层面。UniPert-G2CP[79]分两步走:先用多模态分子表示,把遗传扰动的靶点和化学扰动的化合物放进同一个空间,再把遗传筛选中学到的表型效应迁移到化学扰动上,用来弥补两类筛选在数据规模和实验形式上的差距;作者还据此分析了药物响应背后的细胞异质性。scDEFT[80]面向治疗前后的纵向单细胞图谱,把药物看作作用在细胞表示上的条件算子,同时预测药物引起的状态变化和患者是否应答。在一个包含116万细胞、三个队列和两类药物的炎症性肠病图谱上,它在治疗前区分应答者的AUROC为0.70。这是一篇2026年9月的单作者预印本,结论还有待独立数据检验。
干预会同时改变细胞群体的均值、离散度和组成。分布模型有机会捕捉这些差异,但“生成了一组细胞”之后仍有一串问题要检验:同一靶点能否跨背景迁移,组合能否外推,剂量和时长是否匹配,哪些细胞死亡或消失。统计量的改善要通过具体的生物读出,才能变成可用的假说。
强基线、公开评测与比赛
2025年的一项遗传扰动评测[81]显示,在其采用的数据、划分和预测目标下,简单线性基线可以超过若干深度学习模型。对基础模型的零样本评测[82]也指出,不同任务上的优势需要分别确认。预训练带来的收益,要在具体任务里和设置公平的基线比较之后才能下结论。
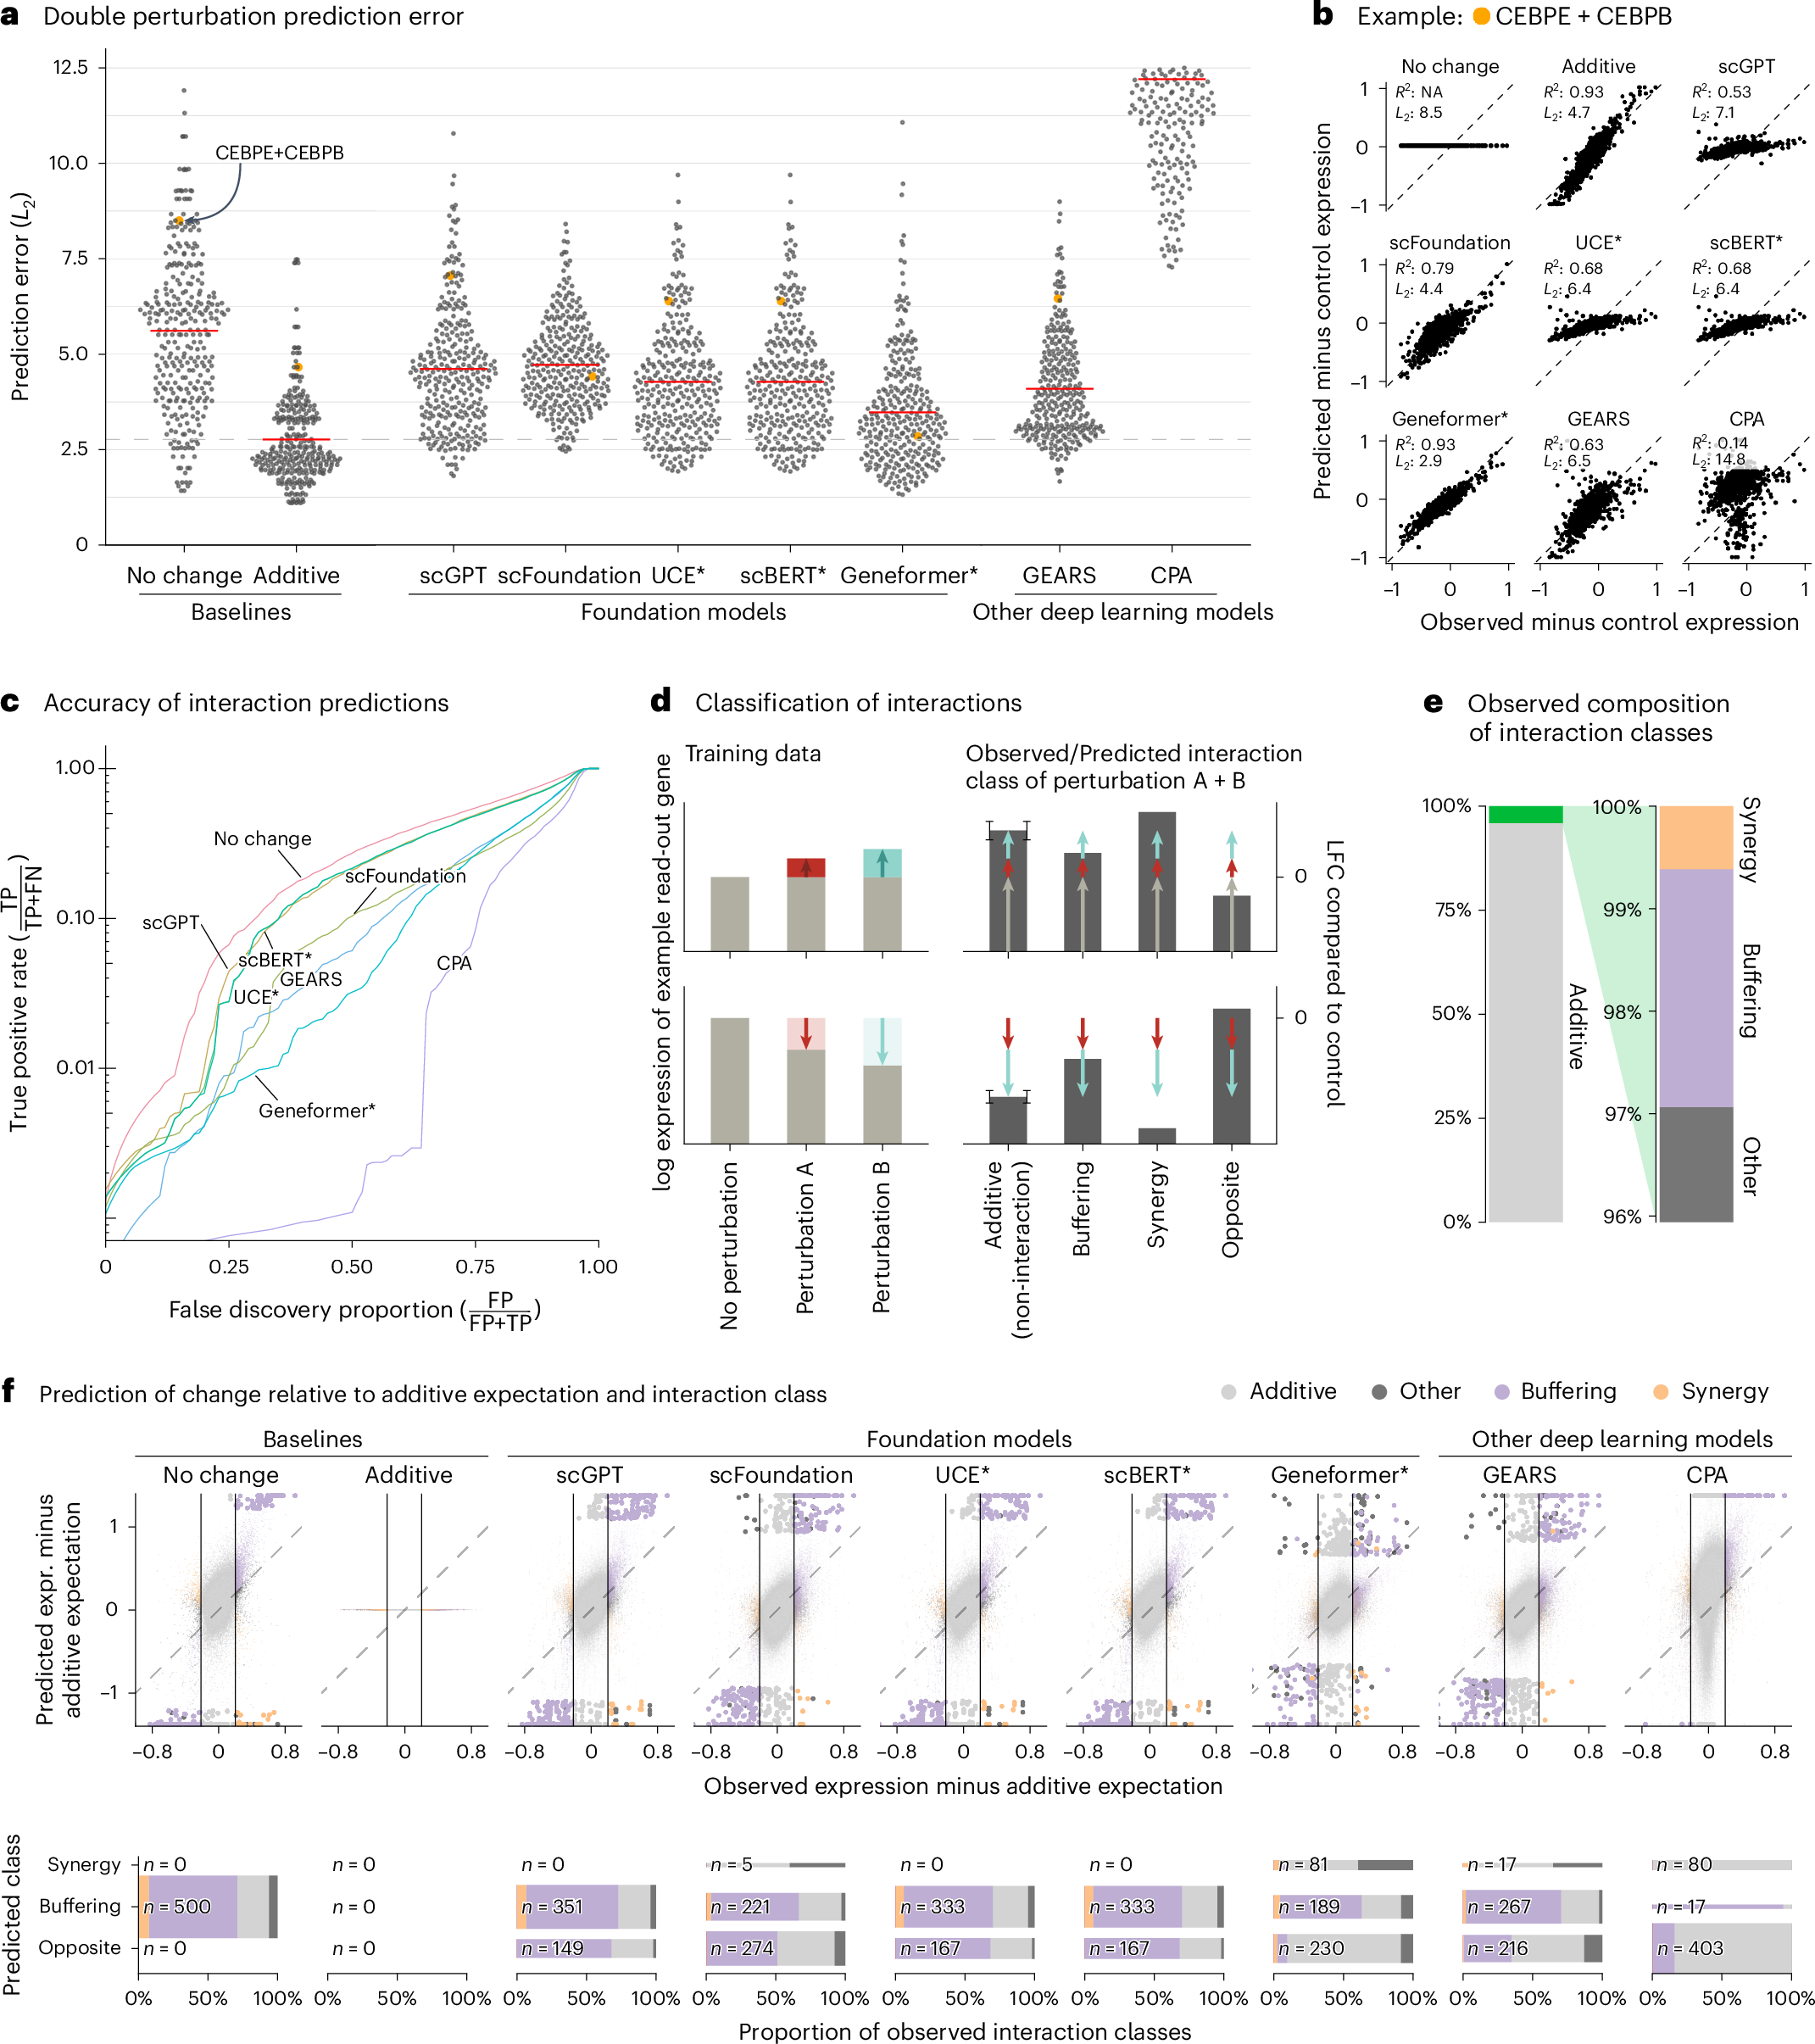
图源:Ahlmann-Eltze et al., Nature Methods 2025, Fig. 1,doi:10.1038/s41592-025-02772-6;CC BY 4.0,完整原图,未修改。
表达预测有一个现实的陷阱:大多数基因变化很小,预测值只要贴近对照均值,整体误差就可能很好看。评测还应检查真正发生变化的基因、变化方向、干预是否可辨识,以及群体组成。对照均值、线性模型、最近邻和已知条件迁移这些基线,应当与复杂模型使用相同的信息、预处理和测试划分。
Rhaister[83]把这场争论落到一个可检查的统计模型上:用聚合的log2FC、表达变化和Mann–Whitney统计量建模,以加性/岭回归加小型校准网络预测药物响应,另有由对照表达驱动的零样本版本(代码与模型卡)。作者在自己的划分和指标上报告了与State等方法的比较。统计响应预测和单细胞分布生成的目标不同,这一结果不能推广成所有任务上的统一排名。
配套的Emerald Bay数据集把表达和药物表型连了起来:1831648个细胞、52个癌细胞系,以及由五天终点细胞比例计算的药物表型读出。它可以用来检验“表达预测能否帮助解释生长效应”;终点测量仍然替代不了连续时间的轨迹。
Virtual Cell Challenge 2025[84]把扰动辨识、差异表达和表达误差放在同一场赛事里。官方复盘显示,许多方案在平均绝对误差(MAE)上仍未超过基线,获奖方案也用到了深度学习与统计方法的组合。
2026年的VCC[85]进一步强调跨细胞上下文的迁移:验证阶段使用A/B/C三个细胞背景,最终阶段换成另一组匿名细胞系D/E/F。当前的CLI文档要求提交原始整数计数,并列出六个分项;各分数以背景均值和实验重复作为锚点,Overall不能读成“正确率”,也不能与2025年的三项指标直接混比。
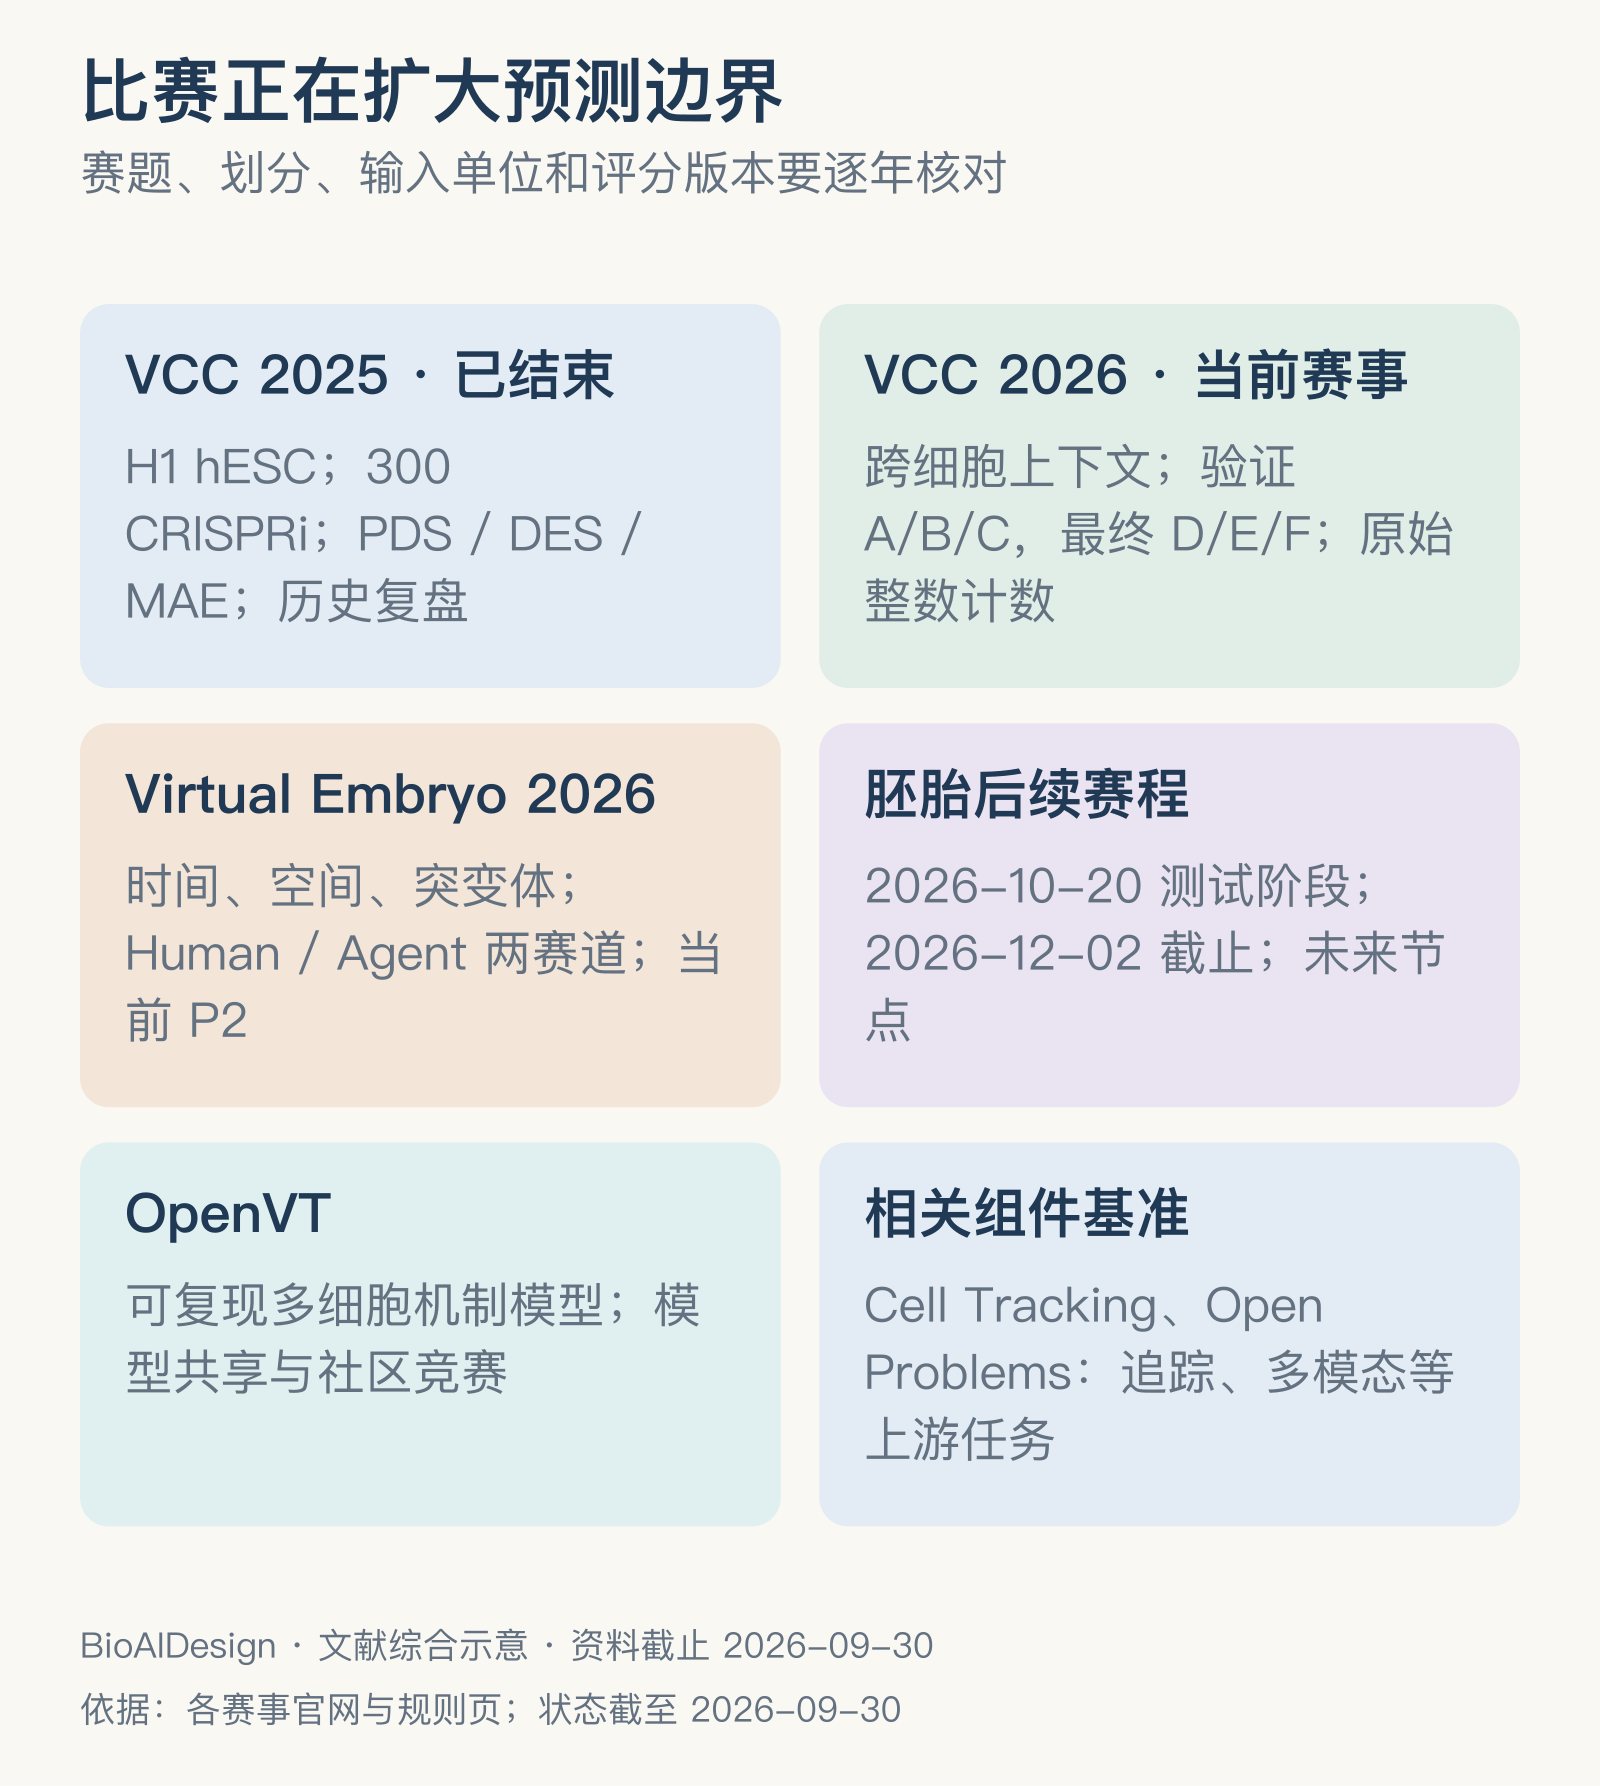
Virtual Embryo Challenge在2026-09-30处于P2验证阶段;官网列出的2026-10-20测试阶段和2026-12-02截止都还是未来节点。它的任务覆盖时间、空间和突变体,提交量的定义与VCC不同,当前规则采用非负的log-normalized表达。Human和Agent两个赛道共用同一套生物任务,后者还要求提交可验证的运行轨迹、prompt和harness,并限制人工中途反馈。
相关赛事还有OpenVT的可复现多细胞机制模型活动,Cell Tracking Challenge的分割、追踪和谱系任务,以及Open Problems的单细胞基准生态。它们验证的分别是运行复现、上游观测和专项预测,不能归成同一张虚拟细胞排行榜。
平台、代码与虚拟实验系统
一个可复现的项目通常至少有四层:数据与元数据处理、任务模型或机制模块、运行接口,以及评测和实验记录。数据层可以从CELLxGENE Census、scBaseCount、人类细胞图谱(HCA)和各专项资源进入,大规模批次加载可参考Cell-Load。任务层按问题选择表达、调控、动态、代谢、成像或空间模型。运行层再用明确的输入输出和配置把它们组织起来。
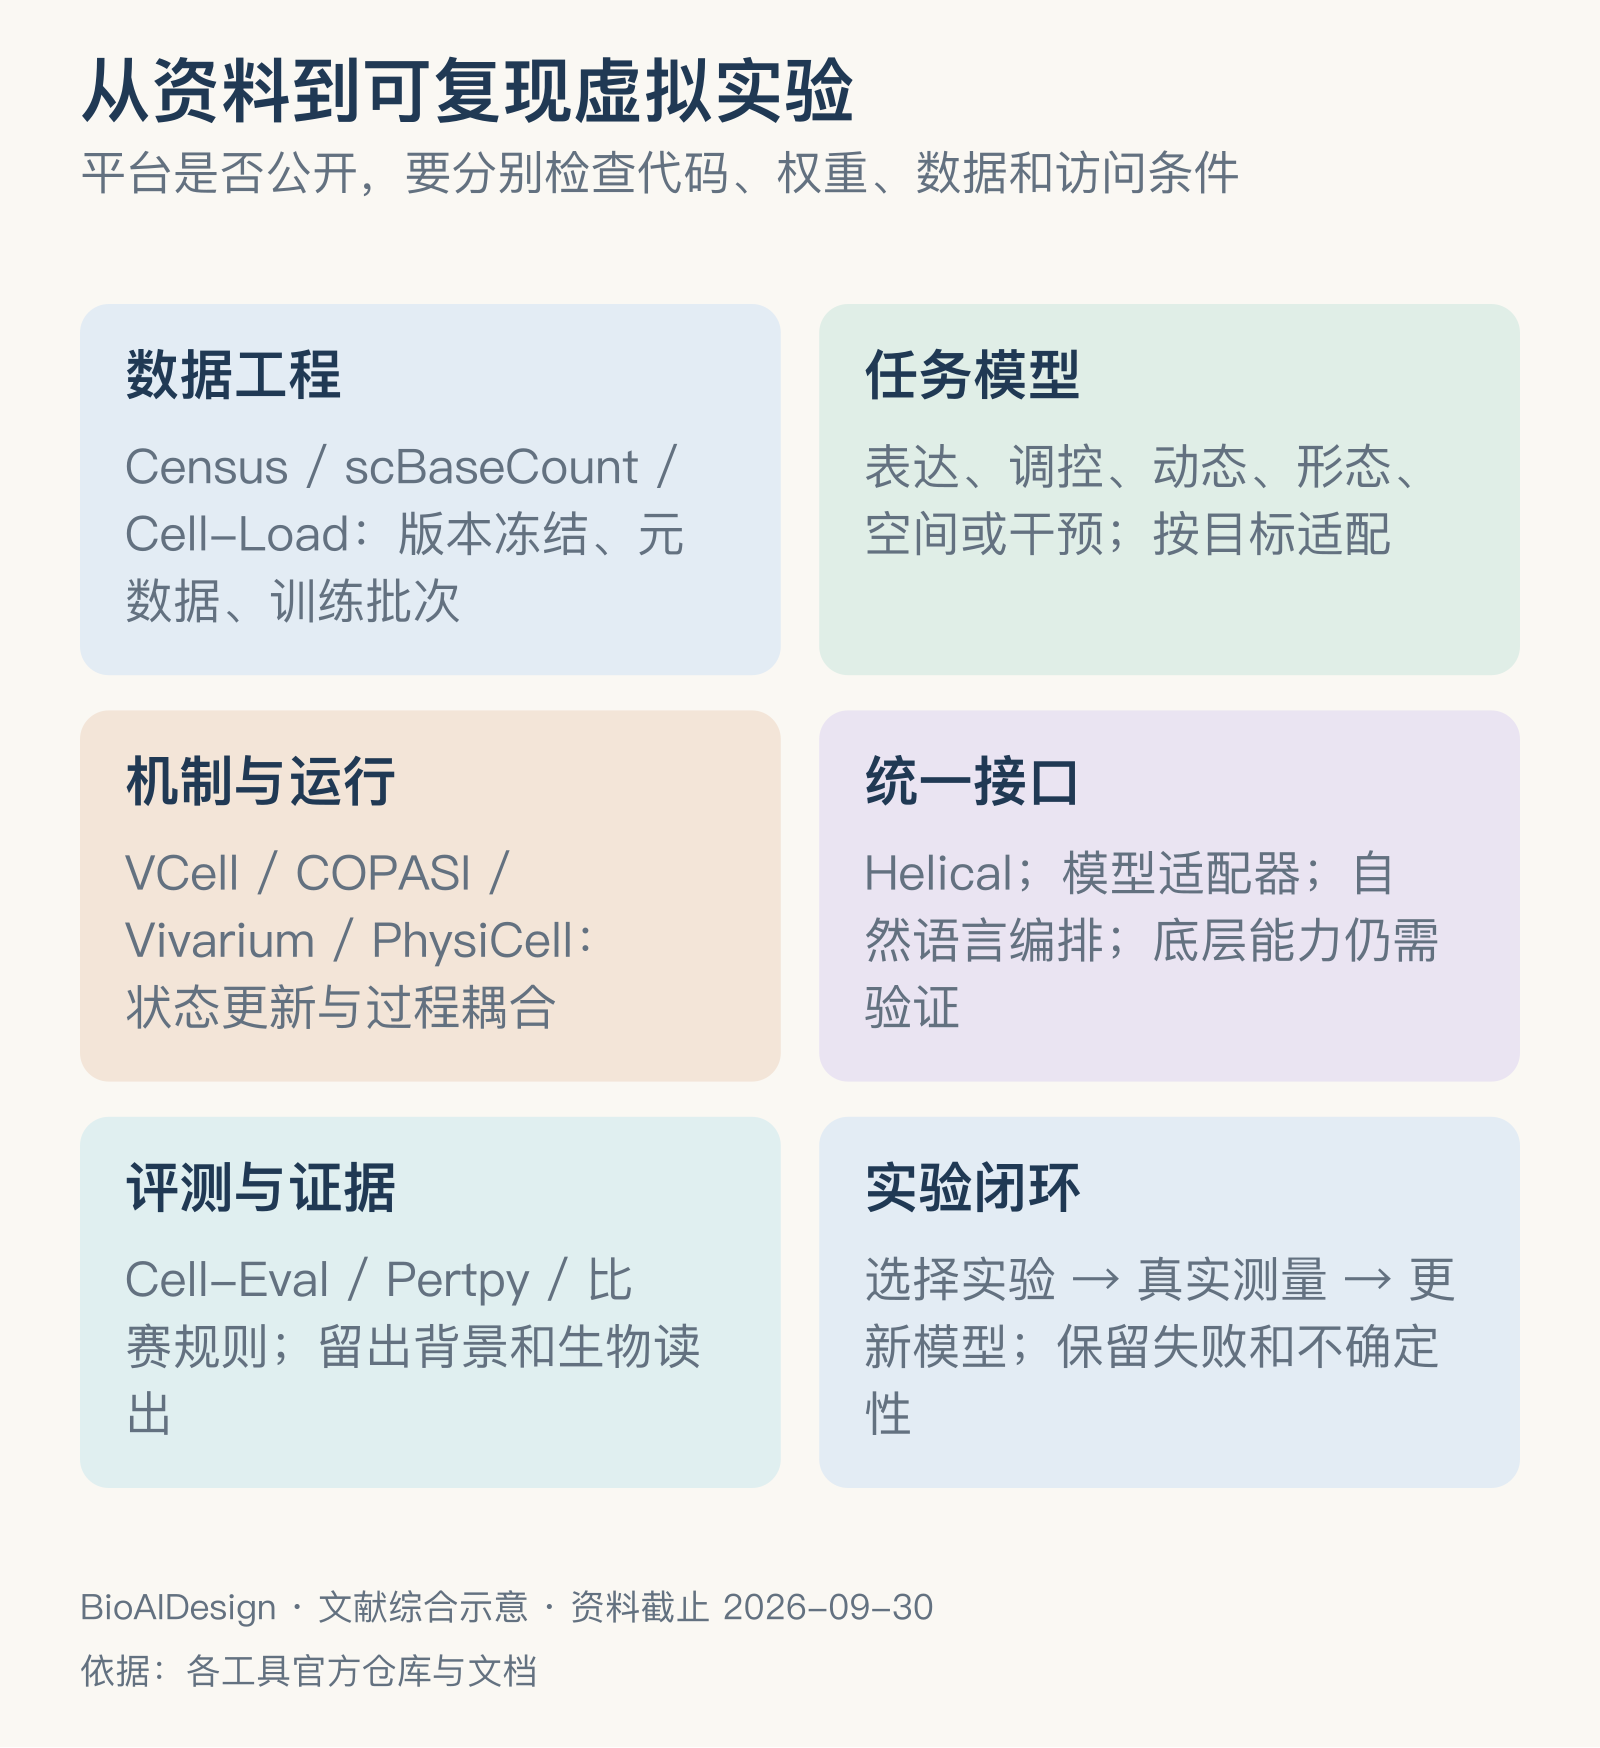
scvi-tools提供概率组学模型生态;Pertpy[86]组织扰动数据的分析、距离、差异和组成;Cell-Eval服务细胞预测评测。Helical和BioLLM[87]提供模型调用与适配入口。与VirTues配套的spora则把空间蛋白数据、读取工具和基准分别组织起来。这些工具降低了工程成本,底层模型的物种、输出和许可仍要逐项确认。
虚拟实验系统目前有两类尝试。VCWorld[88]结合结构化知识与大语言模型的迭代推理,输出信号链和机制假设;PRAXIS-VirtualCell[89]组织模型、适配器、执行和验证证据,强调实验可追溯,以及超出适用范围时如何处理。解释清楚、执行可审计对研究有帮助,但知识是否完整、预测是否准确、能否经受前瞻验证,是另外三个独立的问题。
AIDO Cell的官方页面在检索日展示了K-562和Hep-G2两个原型、连续干预和多模态读出,并把Foundry适配和Lab接口放进同一系统。目前访问面向Alpha合作方,白皮书需要申请,它还不是一个提供完整公开代码的通用人体细胞模拟器。Biohub的Virtual Biology Initiative等机构项目在推动大规模、多模态的数据和实验闭环,项目计划和已发布的模型应分开统计。
工程上还要区分“代码可见”和“可以立即复现”。仓库许可、模型权重许可和数据条款可能各不相同;示例可能依赖大型下载、特定GPU、外部语言模型或受控数据。动手之前逐项确认官方入口、许可、硬件要求和版本,能省去不少返工。
接下来需要哪些数据和实验
把这些研究放在一起,可以看到几类已经稳定积累的能力:大规模状态表示、一定范围内的干预与分布生成、多组学和空间整合、动态推断,以及受约束体系中的机制联动。接下来的难题是让它们在同一个实验背景里互相检验,并支持连续的状态更新。
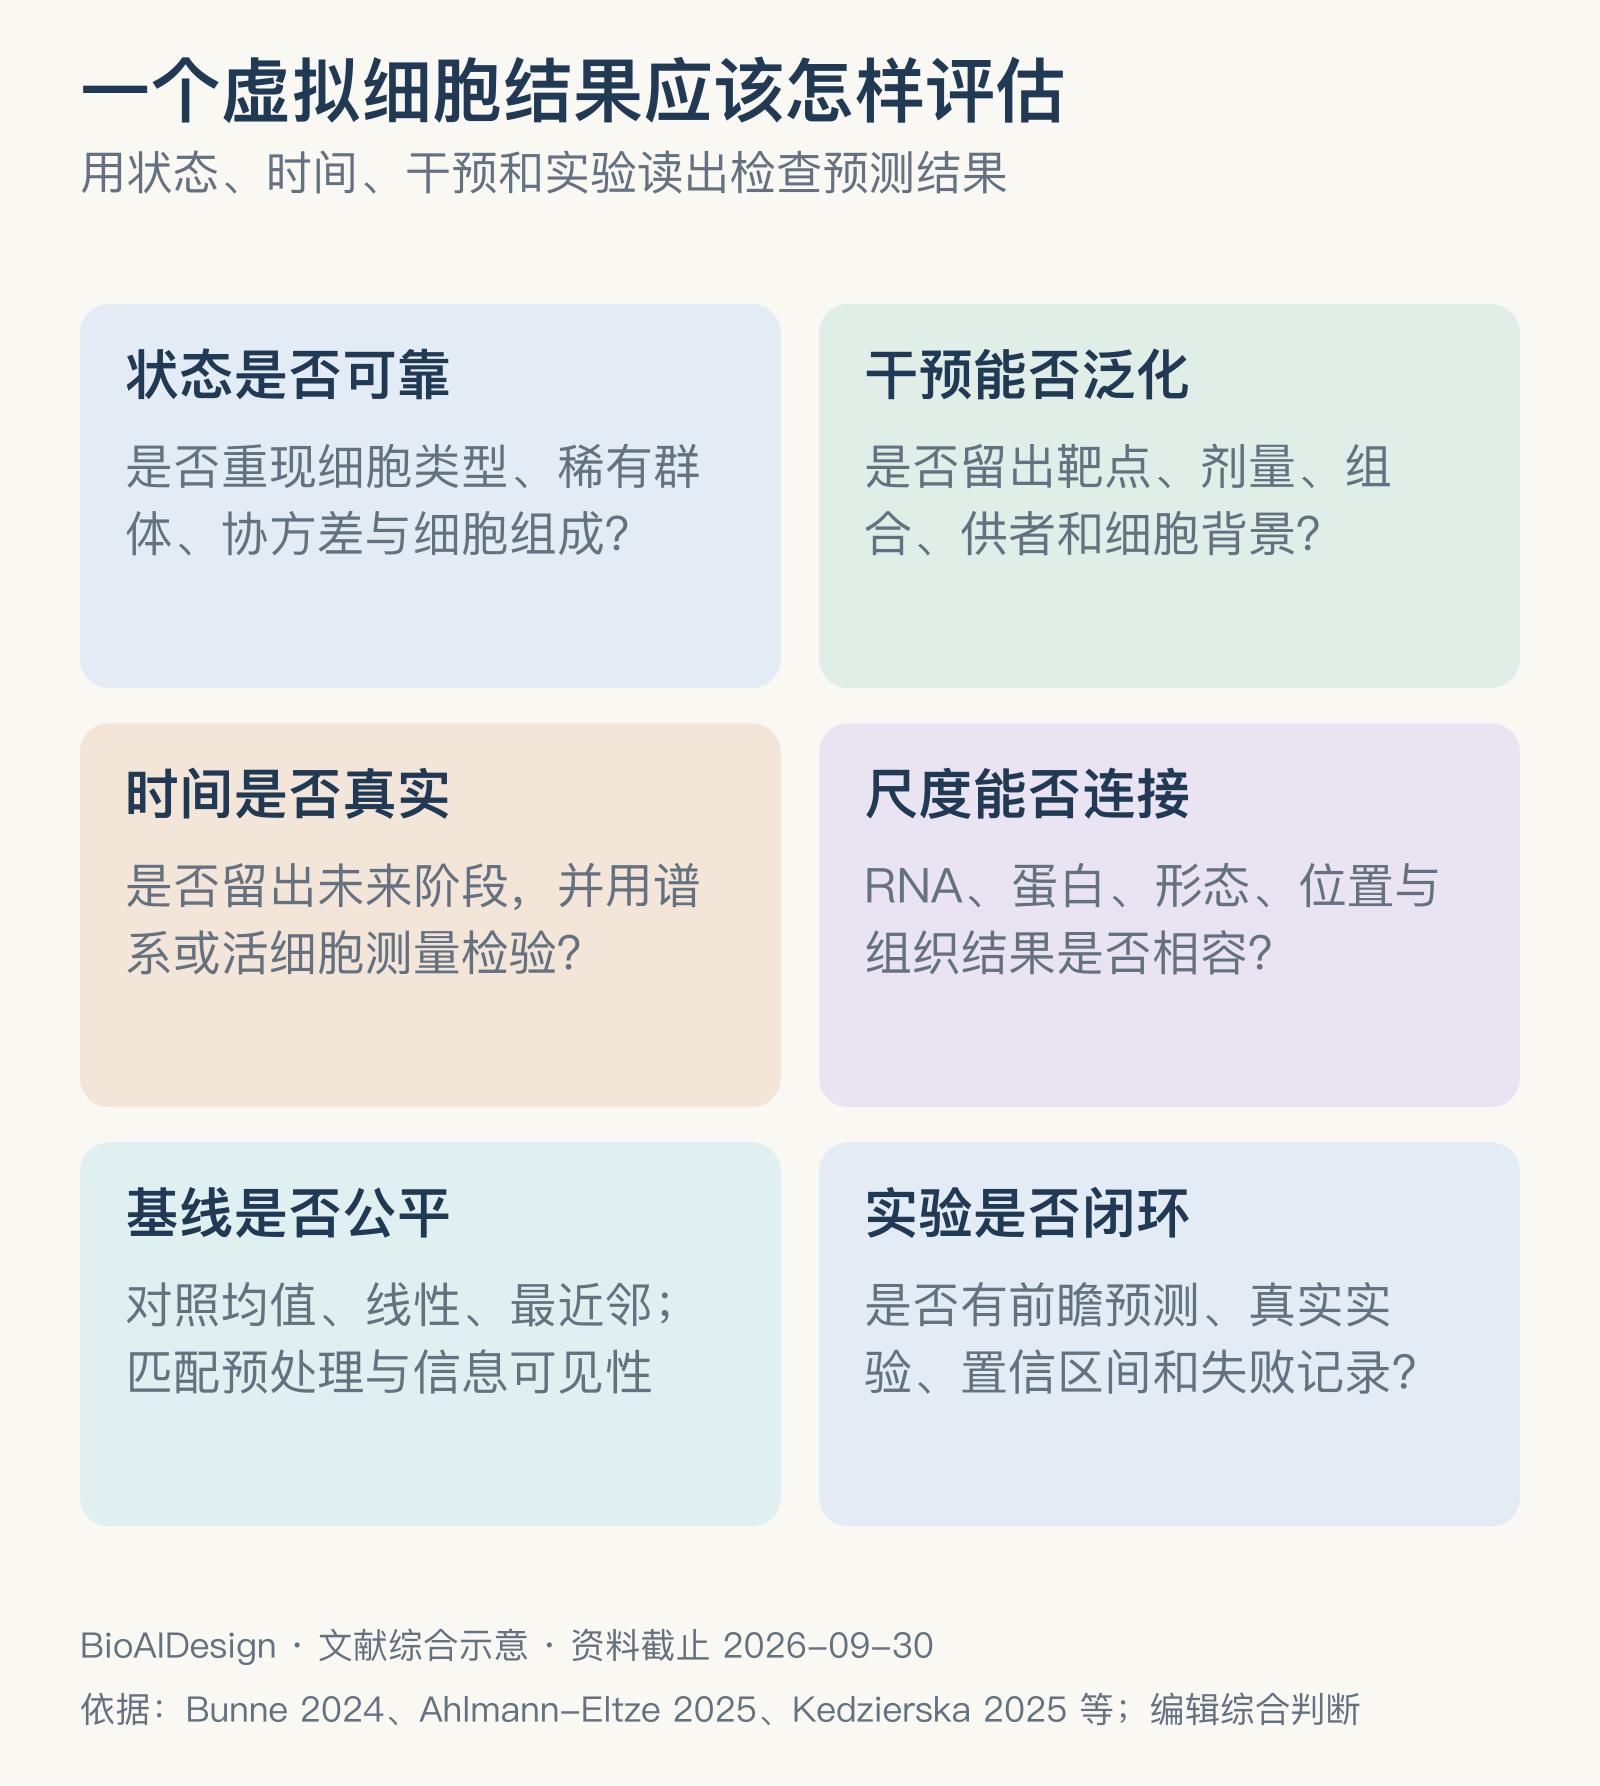
首先,庞大的语料仍有明显的覆盖空白。细胞总数很大,仍可能缺少某类组织、真实的剂量梯度、长期连续干预或罕见状态。癌细胞系上的密集测量,解决不了原代组织里的新机制。数据设计应当报告独立条件数、供者和背景,而不只是细胞数。
共同观测是另一个现实困难。RNA、形态、蛋白、代谢和空间各有大规模资源,但能在同一实验背景、同一时间尺度上把它们连起来的数据要稀缺得多。完全配对并非所有实验都做得到,至少应当标明哪些对齐来自实验、哪些来自推断,并用新的模态去检验已有的预测。
在真实时间尺度上,连续干预尤其考验模型。从快照生成目标分布,到持续模拟分裂、死亡和反馈,中间还隔着多个环节。长程误差会累积,新状态还会反过来改变下一次干预的结果。可以先在一个可观察的细胞系或类器官协议里,测试多步模型是否优于逐步独立预测。
遇到未知机制时,模型还应当给出可信的适用范围:在哪些条件下不该给出强预测?跨物种、新靶点、高阶组合和组织外背景,都需要记录不确定性和适用边界。对机制模型,参数可辨识性是具体的障碍;对学习模型,先验泄漏、背景记忆和分布偏移同样会造成虚假的泛化优势。
比回顾性的相关系数更直接的终点,是模型能否帮助选出有信息量的实验、减少筛选轮次、识别失败机制,并在前瞻数据上改善预测。
这需要固定的预测、独立的测量和失败记录。单次成功案例可以支持一个具体用途,还不足以说明所有细胞过程都已经能被计算复现。
如果据此选题,可以从一个小而完整的闭环做起:同一背景下RNA与形态的联合预测,从调控网络到命运的干预验证,空间邻域中的背景迁移,代谢约束辅助的响应预测,或者有真实时间点与谱系支持的发育生成。先确定拿得到的新读出,再选模型,更容易判断一项预测是否成立。
从现有数据开始实践
生信研究者可以先用scvi-tools建立稳定的表达基线,再按问题进入SCENIC+、CellRank、METAFlux或空间分析。AI研究者可以先选定一个明确的泛化目标,读懂State或Tahoe-x1的数据处理与划分,再复现对照均值、线性和最近邻基线。实验研究者则可以从手头可测的读出出发,确定哪些预测能被新的时间点、干预或模态直接否证。
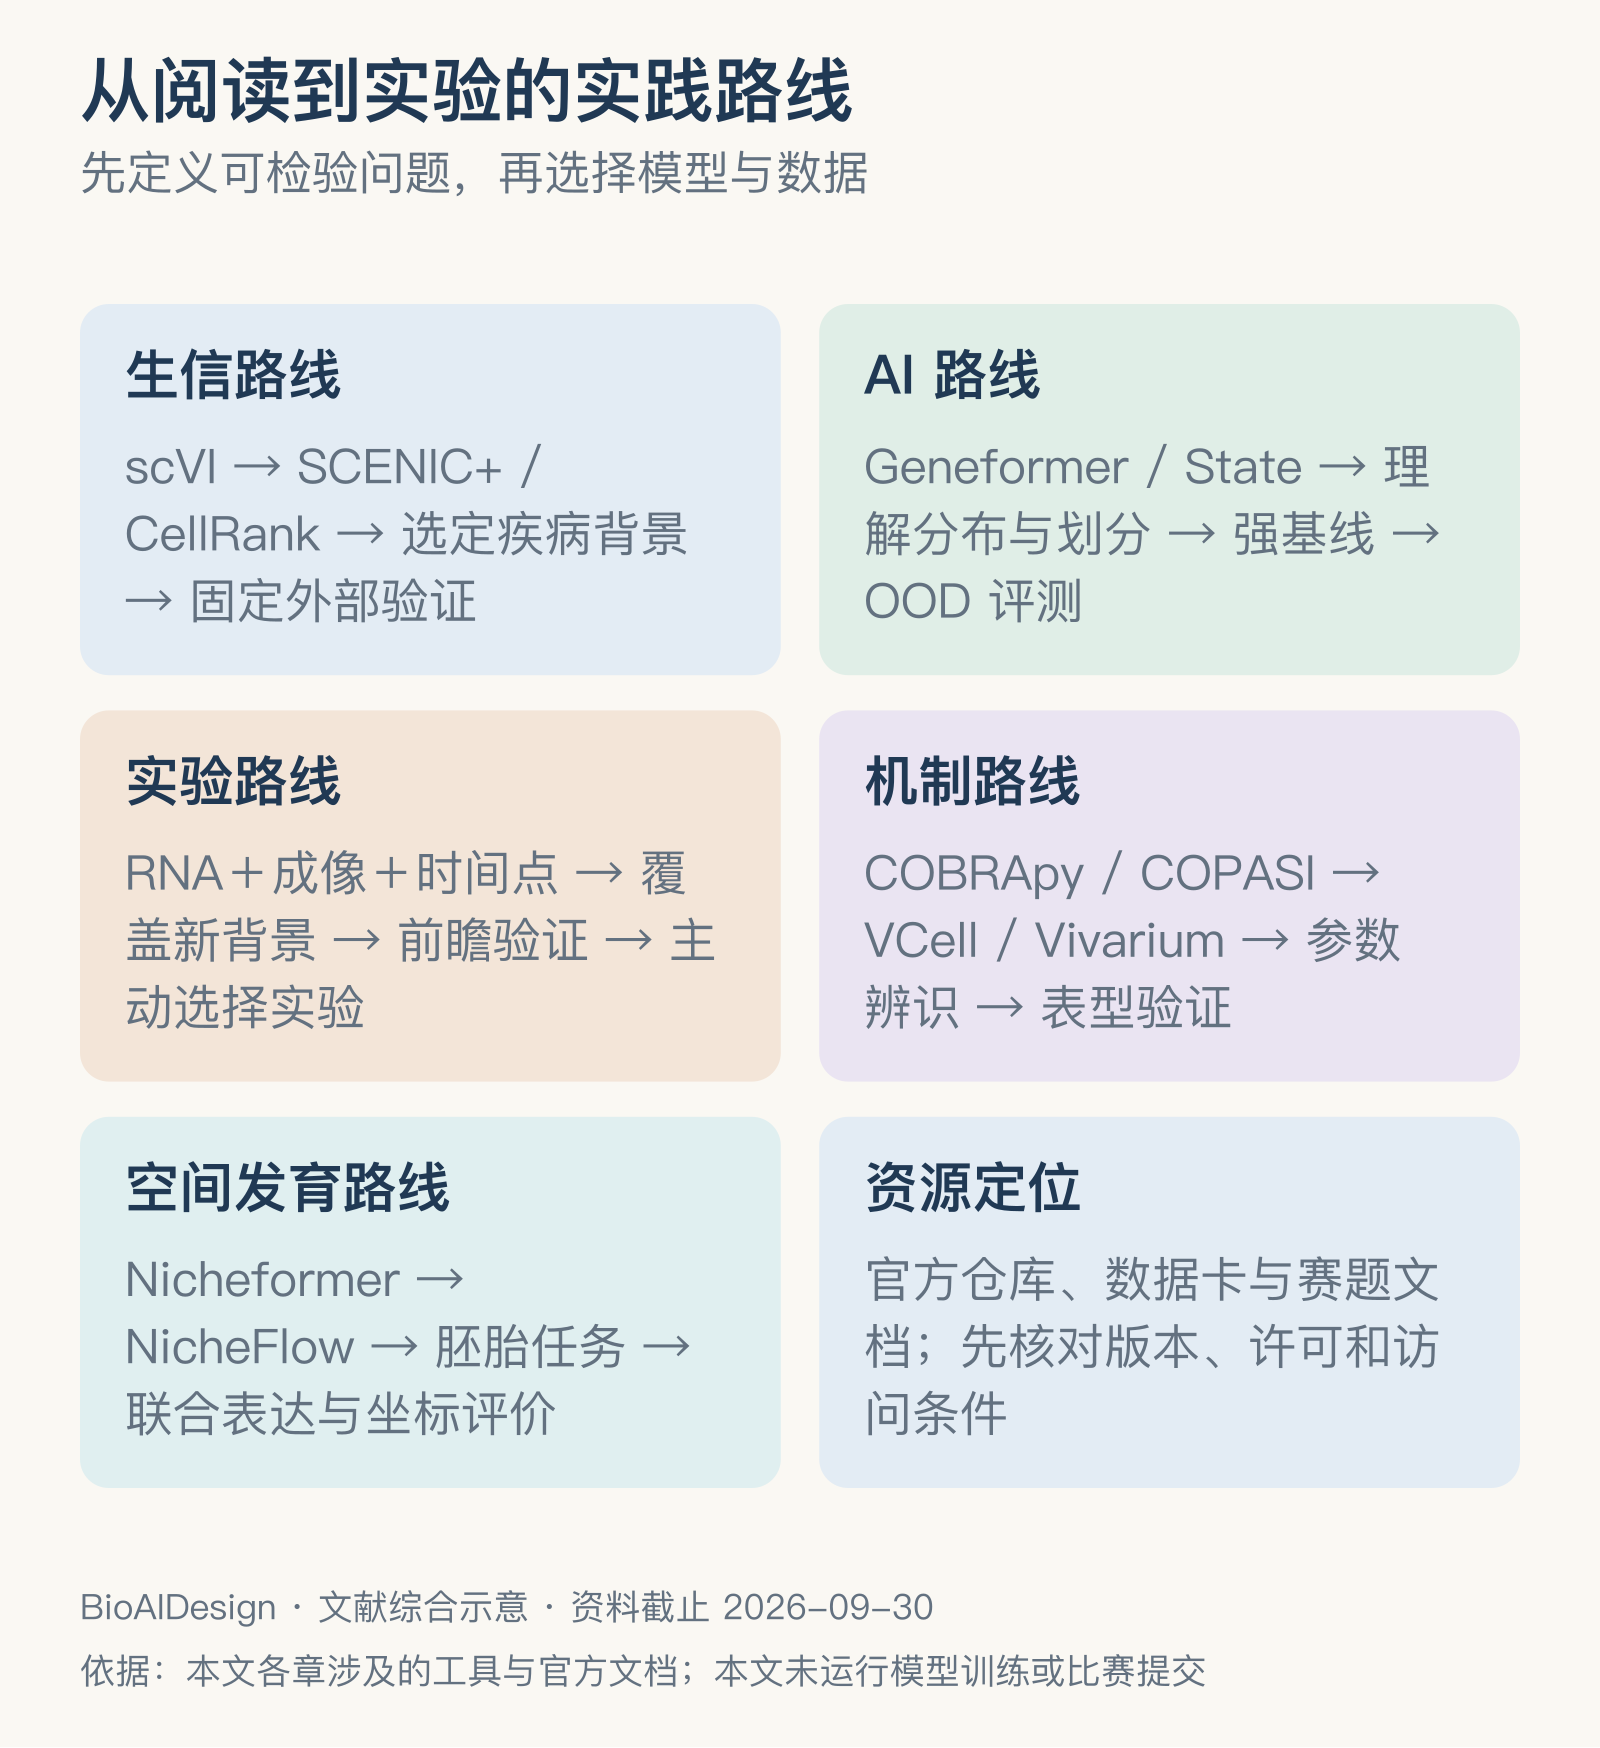
以State为例,官方README区分了嵌入和状态转移两组命令,可以先查看任务入口,再选择对应教程。下面是官方文档中的安装与帮助命令;本文没有运行模型、下载权重或生成预测结果。
uv tool install arc-state
state --help
state tx --help
state emb --help
真正开始实验之前,先冻结数据版本、基因顺序、背景标签和训练划分,再记录模型checkpoint与软件版本。目标是VCC或虚拟胚胎赛事的话,先读赛题对表达单位、隐藏条件和格式检查的要求。目标是新的生物学发现的话,把验证读出和失败判据放在模型选择之前。
参考文献
- Bunne et al. How to build the virtual cell with artificial intelligence: Priorities and opportunities. Cell (2024). doi:10.1016/j.cell.2024.11.015
- Tomita et al. E-CELL: software environment for whole-cell simulation. Bioinformatics (1999). doi:10.1093/bioinformatics/15.1.72
- Moraru et al. The virtual cell: an integrated modeling environment for experimental and computational cell biology. Annals of the New York Academy of Sciences (2002). doi:10.1111/j.1749-6632.2002.tb04535.x
- Hoops et al. COPASI—a COmplex PAthway SImulator. Bioinformatics (2006). doi:10.1093/bioinformatics/btl485
- Karr et al. A whole-cell computational model predicts phenotype from genotype. Cell (2012). doi:10.1016/j.cell.2012.05.044
- Lopez et al. Deep generative modeling for single-cell transcriptomics. Nature Methods (2018). doi:10.1038/s41592-018-0229-2
- La Manno et al. RNA velocity of single cells. Nature (2018). doi:10.1038/s41586-018-0414-6
- Macklin et al. Simultaneous cross-evaluation of heterogeneous E. coli datasets via mechanistic simulation. Science (2020). doi:10.1126/science.aav3751
- Thornburg et al. Fundamental behaviors emerge from simulations of a living minimal cell. Cell (2022). doi:10.1016/j.cell.2021.12.025
- Thornburg et al. Bringing the genetically minimal cell to life on a computer in 4D. Cell (2026). doi:10.1016/j.cell.2026.02.009
- Ebrahim et al. COBRApy: COnstraints-Based Reconstruction and Analysis for Python. BMC Systems Biology (2013). doi:10.1186/1752-0509-7-74
- Hoffmann et al. ReaDDy 2: Fast and flexible software framework for interacting-particle reaction dynamics. PLOS Computational Biology (2019). doi:10.1371/journal.pcbi.1006830
- Agmon et al. Vivarium: an interface and engine for integrative multiscale modeling in computational biology. Bioinformatics (2022). doi:10.1093/bioinformatics/btac049
- Theodoris et al. Transfer learning enables predictions in network biology. Nature (2023). doi:10.1038/s41586-023-06139-9
- Cui et al. scGPT: toward building a foundation model for single-cell multi-omics using generative AI. Nature Methods (2024). doi:10.1038/s41592-024-02201-0
- Hao et al. Large-scale foundation model on single-cell transcriptomics. Nature Methods (2024). doi:10.1038/s41592-024-02305-7
- Rosen et al. Universal cell embedding provides a foundation model for cell biology. Nature (2026). doi:10.1038/s41586-026-10689-z
- Pearce et al. TranscriptFormer: A generative cell atlas across 1.5 billion years of evolution. Science (2026). doi:10.1126/science.aec8514
- Yang et al. GeneCompass: deciphering universal gene regulatory mechanisms with a knowledge-informed cross-species foundation model. Cell Research (2024). doi:10.1038/s41422-024-01034-y
- Zeng et al. CellFM: a large-scale foundation model pre-trained on transcriptomics of 100 million human cells. Nature Communications (2025). doi:10.1038/s41467-025-59926-5
- Bai et al. scLong: a billion-parameter foundation model for capturing long-range gene context in single-cell transcriptomics. Nature Communications (2026). doi:10.1038/s41467-026-69102-y
- Wen et al. CellPLM: Pre-training of Cell Language Model Beyond Single Cells. ICLR 2024. proceedings.iclr.cc
- Levine et al. Cell2Sentence: Teaching Large Language Models the Language of Biology. ICML 2024. proceedings.mlr.press
- Rizvi et al. Scaling Large Language Models for Next-Generation Single-Cell Analysis. bioRxiv (2025). doi:10.1101/2025.04.14.648850
- Dong et al. Stack: In-Context Learning of Single-Cell Biology. bioRxiv (2026). doi:10.64898/2026.01.09.698608
- Wang et al. Speciesformer learns conserved cellular states for cross-species generative virtual cell modeling. bioRxiv (2026). doi:10.64898/2026.09.22.752128
- Li et al. AetherCell: A generative engine for virtual cell perturbation and in vivo drug discovery. bioRxiv (2026). doi:10.64898/2026.03.13.710968
- Zhang et al. Lingshu-Cell: A generative cellular world model for transcriptome modeling toward virtual cells. arXiv (2026). arXiv:2603.25240
- Gayoso et al. Joint probabilistic modeling of single-cell multi-omic data with totalVI. Nature Methods (2021). doi:10.1038/s41592-020-01050-x
- Ashuach et al. MultiVI: deep generative model for the integration of multimodal data. Nature Methods (2023). doi:10.1038/s41592-023-01909-9
- Cao & Gao. Multi-omics single-cell data integration and regulatory inference with graph-linked embedding. Nature Biotechnology (2022). doi:10.1038/s41587-022-01284-4
- Bravo González-Blas et al. SCENIC+: single-cell multiomic inference of enhancers and gene regulatory networks. Nature Methods (2023). doi:10.1038/s41592-023-01938-4
- Kalfon et al. scPRINT: pre-training on 50 million cells allows robust gene network predictions. Nature Communications (2025). doi:10.1038/s41467-025-58699-1
- Hu et al. RegFormer: a single-cell foundation model powered by gene regulatory hierarchies. Nature Communications (2026). doi:10.1038/s41467-026-72198-x
- Avsec et al. Effective gene expression prediction from sequence by integrating long-range interactions. Nature Methods (2021). doi:10.1038/s41592-021-01252-x
- Bergen et al. Generalizing RNA velocity to transient cell states through dynamical modeling. Nature Biotechnology (2020). doi:10.1038/s41587-020-0591-3
- Qiu et al. Mapping transcriptomic vector fields of single cells. Cell (2022). doi:10.1016/j.cell.2021.12.045
- Schiebinger et al. Optimal-Transport Analysis of Single-Cell Gene Expression Identifies Developmental Trajectories in Reprogramming. Cell (2019). doi:10.1016/j.cell.2019.01.006
- Sha et al. Reconstructing growth and dynamic trajectories from single-cell transcriptomics data. Nature Machine Intelligence (2023). doi:10.1038/s42256-023-00763-w
- Weiler et al. CellRank 2: unified fate mapping in multiview single-cell data. Nature Methods (2024). doi:10.1038/s41592-024-02303-9
- Klein et al. CellFlow enables generative single-cell phenotype modeling with flow matching. bioRxiv (2025). doi:10.1101/2025.04.11.648220
- Robinson et al. An atlas of human metabolism. Science Signaling (2020). doi:10.1126/scisignal.aaz1482
- Alghamdi et al. A graph neural network model to estimate cell-wise metabolic flux using single-cell RNA-seq data. Genome Research (2021). doi:10.1101/gr.271205.120
- Wagner et al. Metabolic modeling of single Th17 cells reveals regulators of autoimmunity. Cell (2021). doi:10.1016/j.cell.2021.05.045
- Huang et al. Characterizing cancer metabolism from bulk and single-cell RNA-seq data using METAFlux. Nature Communications (2023). doi:10.1038/s41467-023-40457-w
- Sun et al. An operational perturbation proteomics-based virtual cell model. Nature (2026). doi:10.1038/s41586-026-11001-9
- Bray et al. Cell Painting, a high-content image-based assay for morphological profiling using multiplexed fluorescent dyes. Nature Protocols (2016). doi:10.1038/nprot.2016.105
- Chandrasekaran et al. Three million images and morphological profiles of cells treated with matched chemical and genetic perturbations. Nature Methods (2024). doi:10.1038/s41592-024-02241-6
- Kraus et al. Masked Autoencoders for Microscopy are Scalable Learners of Cellular Biology. CVPR 2024. openaccess.thecvf.com
- Zhang et al. CellFlux: Simulating Cellular Morphology Changes via Flow Matching. ICML 2025. arXiv:2502.09775
- Zhang et al. CellFluxV2: An Image Generative Foundation Model for Virtual Cell Modeling. bioRxiv (2026). doi:10.64898/2026.01.19.696785
- Wang et al. Prediction of cellular morphology changes under perturbations with a transcriptome-guided diffusion model. Nature Communications (2025). doi:10.1038/s41467-025-63478-z
- Ounkomol et al. Label-free prediction of three-dimensional fluorescence images from transmitted-light microscopy. Nature Methods (2018). doi:10.1038/s41592-018-0111-2
- Cho et al. OpenCell: Endogenous tagging for the cartography of human cellular organization. Science (2022). doi:10.1126/science.abi6983
- Thul et al. A subcellular map of the human proteome. Science (2017). doi:10.1126/science.aal3321
- Tejada-Lapuerta et al. Nicheformer: a foundation model for single-cell and spatial omics. Nature Methods (2025). doi:10.1038/s41592-025-02814-z
- Wenckstern et al. The Virtual Tissues foundation model resolves spatial proteomics across scales. Nature (2026). doi:10.1038/s41586-026-10884-y
- Jin et al. Inference and analysis of cell-cell communication using CellChat. Nature Communications (2021). doi:10.1038/s41467-021-21246-9
- Browaeys et al. NicheNet: modeling intercellular communication by linking ligands to target genes. Nature Methods (2019). doi:10.1038/s41592-019-0667-5
- Cang et al. Screening cell–cell communication in spatial transcriptomics via collective optimal transport. Nature Methods (2023). doi:10.1038/s41592-022-01728-4
- Sakalyan et al. Modeling Microenvironment Trajectories on Spatial Transcriptomics with NicheFlow. NeurIPS 2025. arXiv:2511.00977
- Ghaffarizadeh et al. PhysiCell: An open source physics-based cell simulator for 3-D multicellular systems. PLOS Computational Biology (2018). doi:10.1371/journal.pcbi.1005991
- Swat et al. Multi-Scale Modeling of Tissues Using CompuCell3D. Methods in Cell Biology (2012). doi:10.1016/b978-0-12-388403-9.00013-8
- Starruß et al. Morpheus: a user-friendly modeling environment for multiscale and multicellular systems biology. Bioinformatics (2014). doi:10.1093/bioinformatics/btt772
- Sarma et al. OpenWorm: overview and recent advances in integrative biological simulation of Caenorhabditis elegans. Philosophical Transactions of the Royal Society B: Biological Sciences (2018). doi:10.1098/rstb.2017.0382
- Qian et al. Towards the construction of a virtual yeast. Nature (2026). doi:10.1038/s41586-026-10574-9
- Song et al. How to build an AI-driven digital organism. Nature Medicine (2026). doi:10.1038/s41591-026-04595-0
- Xing & Song. A world model of the virtual cell. Cell (2026). doi:10.1016/j.cell.2026.08.042
- Lotfollahi et al. scGen predicts single-cell perturbation responses. Nature Methods (2019). doi:10.1038/s41592-019-0494-8
- Lotfollahi et al. Predicting cellular responses to complex perturbations in high‐throughput screens. Molecular Systems Biology (2023). doi:10.15252/msb.202211517
- Roohani et al. Predicting transcriptional outcomes of novel multigene perturbations with GEARS. Nature Biotechnology (2023). doi:10.1038/s41587-023-01905-6
- Bunne et al. Learning single-cell perturbation responses using neural optimal transport. Nature Methods (2023). doi:10.1038/s41592-023-01969-x
- Zhang et al. Tahoe-100M: Mapping drug-induced molecular phenotypes at single-cell resolution. Cell (2026). doi:10.1016/j.cell.2026.08.035
- Wang et al. X-Cell: Scaling Causal Perturbation Prediction Across Diverse Cellular Contexts via Diffusion Language Models. bioRxiv (2026). doi:10.64898/2026.03.18.712807
- Youngblut et al. scBaseCount: an AI agent-curated, uniformly processed, and autonomously updated single cell data repository. bioRxiv (2025). doi:10.1101/2025.02.27.640494
- Adduri et al. Predicting cellular responses to perturbation across diverse contexts with State. Cell (2026). doi:10.1016/j.cell.2026.07.052
- Gandhi et al. Tahoe-x1: Scaling Perturbation-Trained Single-Cell Foundation Models to 3 Billion Parameters. bioRxiv (2025). doi:10.1101/2025.10.23.683759
- Jiang et al. OCOO-T: A Simple and Scalable Virtual Cell Model for Transcriptional Perturbation Response Prediction. arXiv (2026). arXiv:2606.12838
- Li et al. UniPert-G2CP bridges genetic and chemical screens from molecular representation to phenotype modeling. Cell (2026). doi:10.1016/j.cell.2026.06.005
- Devarakonda. scDEFT: A deep learning framework for drug-effect prediction and counterfactual reasoning. arXiv (2026). arXiv:2609.10831
- Ahlmann-Eltze et al. Deep-learning-based gene perturbation effect prediction does not yet outperform simple linear baselines. Nature Methods (2025). doi:10.1038/s41592-025-02772-6
- Kedzierska et al. Zero-shot evaluation reveals limitations of single-cell foundation models. Genome Biology (2025). doi:10.1186/s13059-025-03574-x
- Svensson et al. Back to basics: Observed statistics are sufficient to predict drug responses. bioRxiv (2026). doi:10.64898/2026.06.09.731197
- Roohani et al. Virtual Cell Challenge: Toward a Turing test for the virtual cell. Cell (2025). doi:10.1016/j.cell.2025.06.008
- Adduri et al. Virtual Cell Challenge 2026: Benchmarking zero-shot generalization across cellular contexts. Cell (2026). doi:10.1016/j.cell.2026.08.004
- Heumos et al. Pertpy: an end-to-end framework for perturbation analysis. Nature Methods (2025). doi:10.1038/s41592-025-02909-7
- Qiu et al. BioLLM: A standardized framework for integrating and benchmarking single-cell foundation models. Patterns (2025). doi:10.1016/j.patter.2025.101326
- Wei et al. VCWorld: A Biological World Model for Virtual Cell Simulation. ICLR 2026. proceedings.iclr.cc
- Ma & Jiang. PRAXIS-VirtualCell: A Programmable and Trustworthy Framework for Agentic Virtual Cell Experiments. arXiv (2026). arXiv:2609.29221
来源与资源
文中论文原图均为开放获取(CC BY 4.0),完整保留原图、原编号与署名;其余示意图为本文依据文献绘制的综合图,不含新增实验数据。使用代码、权重、图像或数据时,请以对应版本的原始许可条款为准。
关键词
#虚拟细胞 #单细胞基础模型 #多模态生物学 #全细胞模拟 #数字胚胎 #BioAIDesign