RiboBridge: generating RNA conformations and protein-binding poses
Separating RNA shape from relative pose reveals distinct challenges in structure recovery, interface selection, and sequence–structure self-consistency.
南京大学 × 香港中文大学 × 新加坡国立大学 · 2026-10-22
把RNA形状与结合姿态分开建模,有助于恢复复合物结构;但选对位点、找到能折回目标形状的序列,仍是关卡。
想为某个蛋白设计一条能结合它的RNA,光知道靶蛋白长什么样还不够。RNA自身要折成合适的形状,还得落在合适的位置;如果连结合位点也未指定,两件事就得一起解决。
南京大学、香港中文大学和新加坡国立大学合作提出的 RiboBridge,选择把这道题拆开:先预测可能的界面,生成适合该界面的RNA形状,再计算它与蛋白怎样组装。输入是靶蛋白结构和期望RNA长度,输出是候选RNA结构及其结合姿态,而不是已经验证有效的RNA药物。
论文信息
| Title | RiboBridge: protein-conditioned de novo RNA binder structure design |
| Journal | arXiv |
| Posted | 2026-10-22 |
| URL | https://arxiv.org/abs/2610.30668 |
先把RNA生成好,再决定怎样靠近蛋白
“形状”和“姿态”听起来相近,实际是两个问题:一条RNA自身怎样弯曲、折叠,是形状;把它整体旋转、移动,放到蛋白的哪一面,是姿态。若在同一个坐标空间里同时学习,模型就需要从有限的复合物数据中兼顾这两件事。
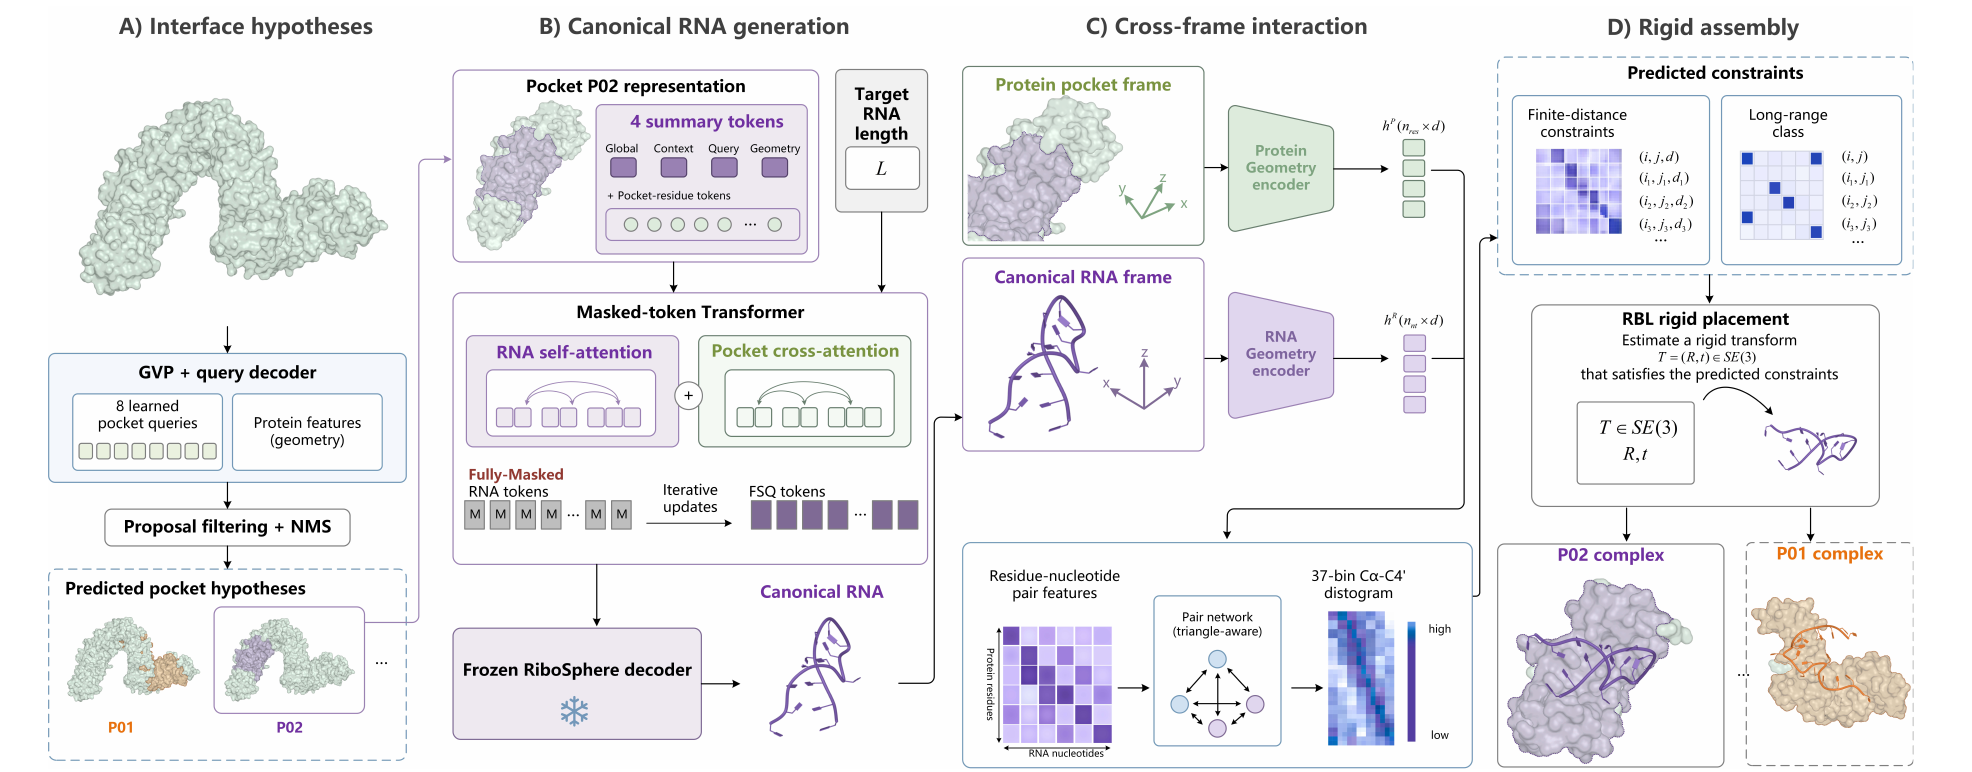
RiboBridge将流程分成四步。
- 找候选界面。 模型扫描整个蛋白表面,提出多个可能与RNA接触的区域,再过滤重叠候选。用户不需要提前圈出结合位点。
- 按界面生成RNA形状。 借用预训练结构模型 RiboSphere 的能力,条件生成器反复更新结构编码,再由冻结的解码器还原RNA坐标。这里生成的是结构编码,不是A、U、G、C序列。
- 预测结合后的距离。 模型分别读取蛋白和RNA内部的几何特征,预测二者在结合状态下哪些位置应该靠近,而不把尚未确定的相对摆放当成输入。
- 整体移动并组装。 用预测的距离约束求出RNA的旋转和平移。这个阶段保持RNA自身形状不变,不再把它扭成另一种构象。
这样做复用了已有RNA结构知识,也让两类误差可以分开诊断。需要强调,分开坐标系不等于忽略靶蛋白:RNA的形状从生成阶段起,就受到候选界面的引导。
不预设位点,不代表已经会选对位点
研究整理了29,624条蛋白–RNA复合物记录,按时间划分数据,再对测试集实施序列相似性过滤与去冗余,最终得到124个测试复合物。这里的“记录数”不等于不同靶蛋白的数量。
最影响结论的细节,是候选怎样被选中参加评分。每个预测界面先生成一个候选复合物,全部生成结束后,研究者才依据真实界面,选出预测界面与之最匹配的候选。真实信息没有参与生成,但参与了生成后的选择。
因此,主结果回答的是:“这些候选中,与真实界面对应的那个,恢复得怎么样?”它还不能等同于模型自行选出第一名的盲测表现。
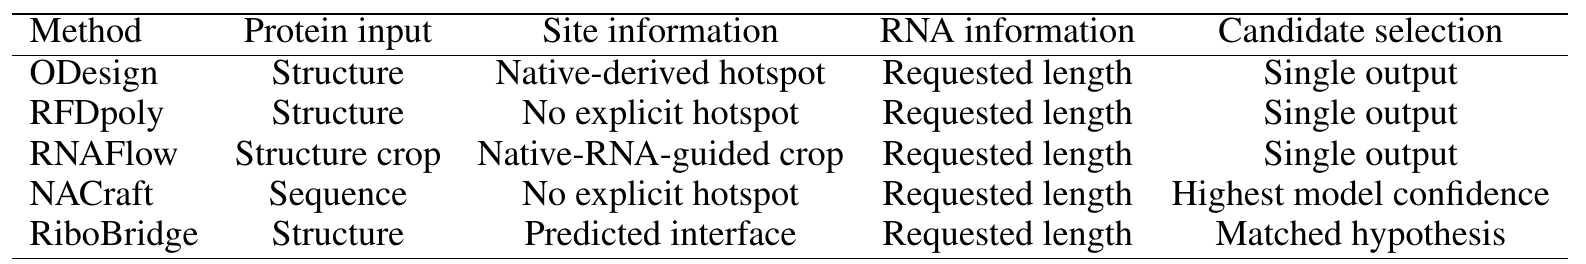
各基线的输入也不完全相同:ODesign 获得来自真实界面的热点;RNAFlow 使用真实RNA引导的蛋白裁剪;RFDpoly 不接收显式热点;NACraft 从蛋白序列出发并按模型置信度选候选。下表保留了这些条件,避免把排名理解为完全同条件的较量。
多保留几个位点确实有帮助,但尚未解决定位问题。按附录的严格匹配标准,只取置信度最高的位点,能覆盖45个测试目标;保留全部候选后增至54个,仍不到124个目标的一半。
结构恢复有进步,序列兑现仍吃力
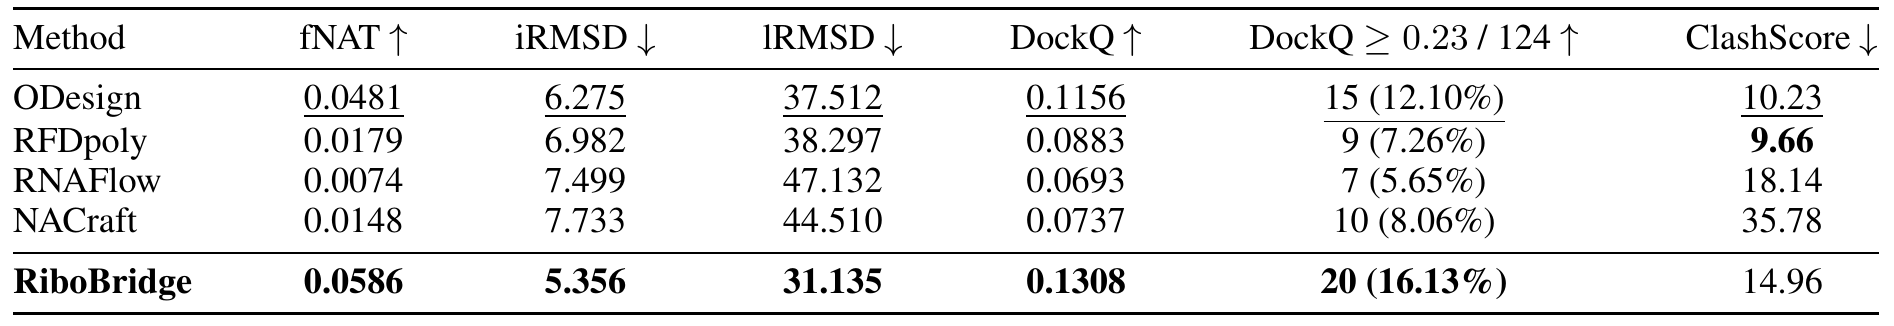
在上述评测条件下,RiboBridge 的平均DockQ为0.1308,高于 ODesign 的0.1156;界面和RNA位置偏差也更小。DockQ综合衡量接触与几何恢复情况,数值越高,预测复合物越接近参考结构。
以DockQ≥0.23为标准,20/124个候选达标,比例16.13%;ODesign 为15/124。这是“结构恢复达到阈值”,不是“16.13%的RNA被实验确认能够结合”。模型也并非各项最优:空间冲突分数仍高于 RFDpoly 和 ODesign。连续指标在有效输出上统计,达标比例则以全部124个目标为分母。
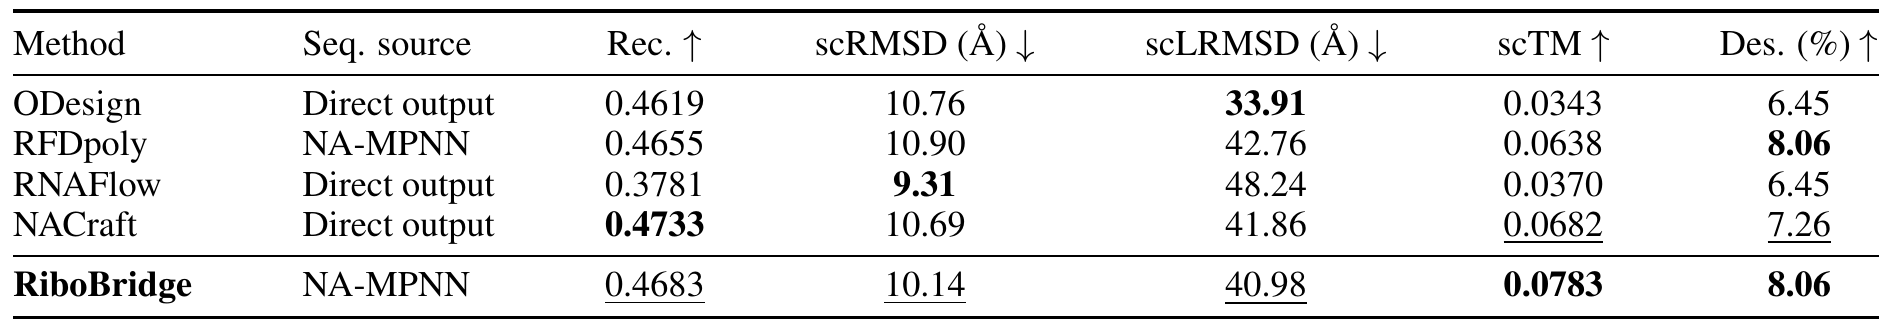
还有一道更实际的检验:设计出这样的结构,能否找到一条序列,让它折回来?作者用 NA-MPNN 为生成的RNA结构补上序列,再让 AlphaFold3 从序列重新预测。这个复核不输入生成的坐标,也不输入真实RNA结构。
结果没有结构排名那么乐观。按“RNA自身对齐后偏差小于2 Å”的标准,可设计率只有8.06%,与 RFDpoly 并列,而非独占第一。在有效输出中,平均RNA自身偏差为10.14 Å;若先对齐蛋白,再比较RNA的位置,偏差则达到40.98 Å。
前一个指标看形状能否折回,后一个连同结合位置一起看。即使通过前者,也不自动意味着RNA回到了正确界面,更不意味着已经具备真实亲和力。
RNA没有提前摆好,靶蛋白还管用吗
要证明模型真的按目标界面生成RNA,不能只看最终排名。作者固定评测方式,把正确界面条件换成“只告诉长度”,或换成长度匹配但来自其他目标的界面。
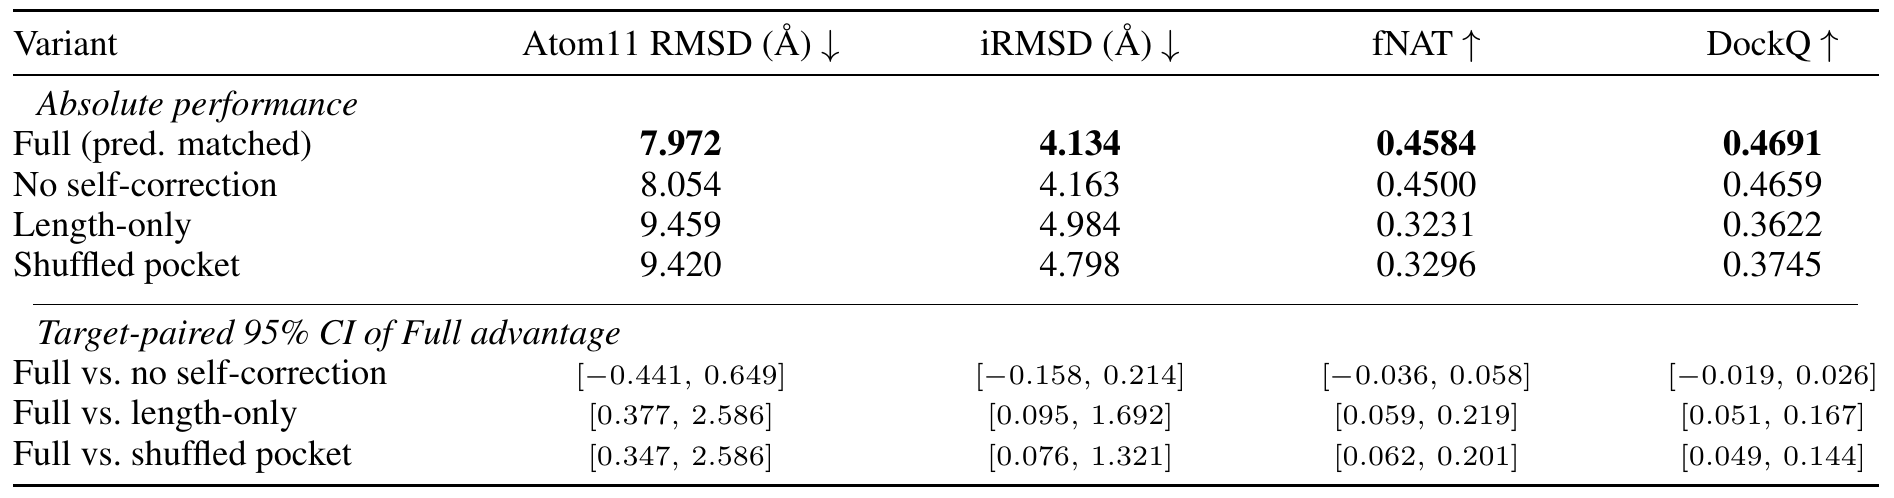
这项消融只使用54个满足严格界面匹配标准的目标,并借助参考结构提供的理想摆放方式,尽量排除后续定位误差。正确条件下的DockQ为0.4691,长度条件和打乱界面条件分别为0.3622、0.3745,比较的95%置信区间支持正向差异。
这说明界面信息确实改变了RNA形状,不只是给生成器额外塞入一些输入。不过,加入“自纠错”训练的收益较小,相关置信区间包含零,不能把它写成已经证实的主要增益来源。
真正拖后腿的是形状与距离预测
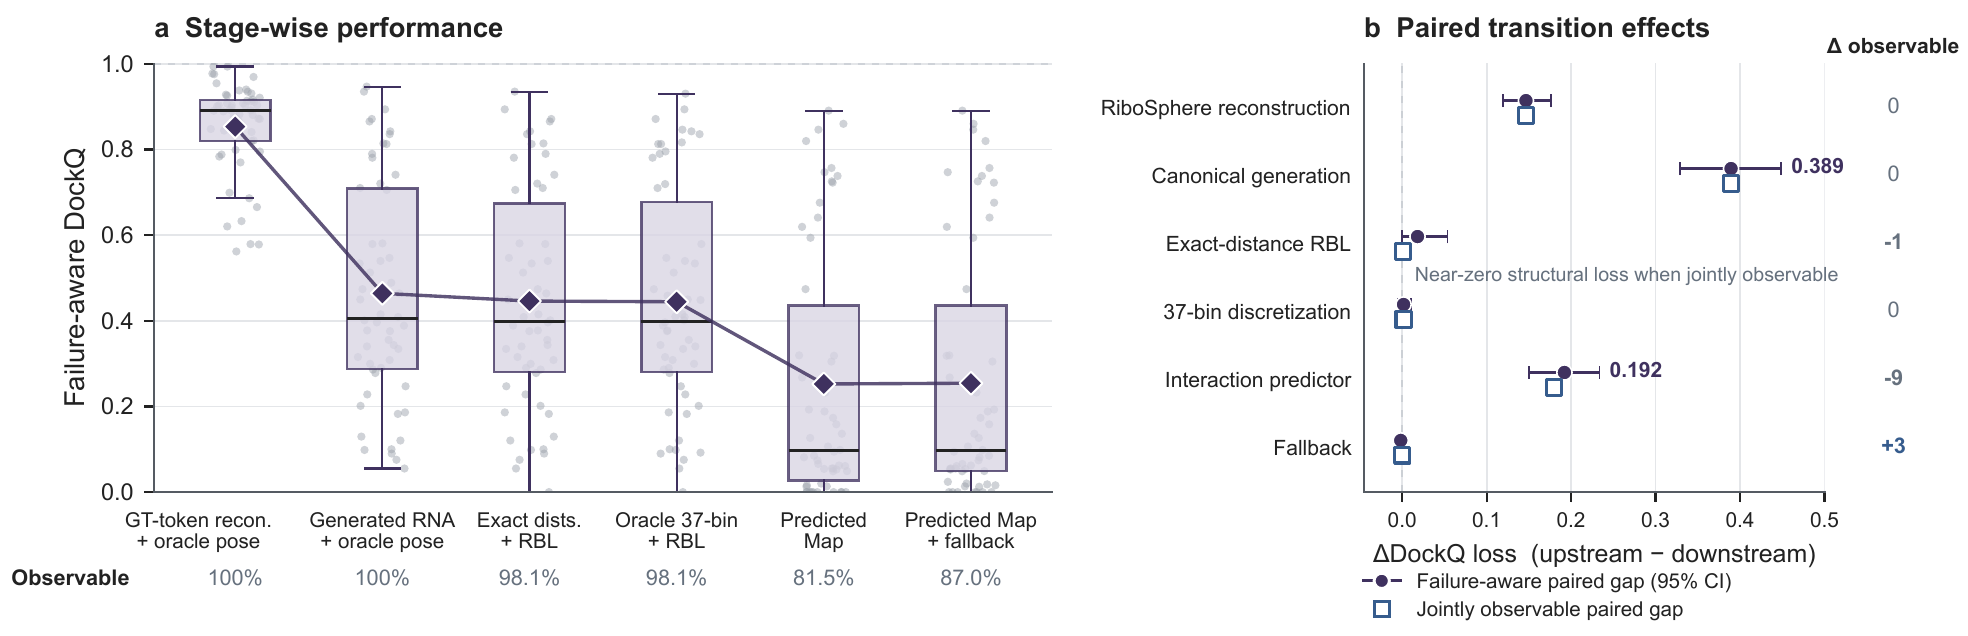
模块拆开以后,研究者还能逐步替换其中的预测,用真实信息检查误差从哪里开始扩大。该诊断同样限于54个严格匹配的目标,分数不能直接与全体124个目标的主结果混用。
借助真实结构编码重建RNA,并给它理想姿态,平均DockQ可到0.854;换成模型生成的RNA,即使仍给理想姿态,也降到0.464。再把正确的跨链距离换成预测距离,最终降到约0.253。主要损失分别出现在RNA形状生成和相互作用预测。
反过来,在距离准确且几何约束足够时,整体旋转和平移带来的额外损失很小。增加数值求解的补救步骤能让更多样本得到姿态,却几乎不提高平均DockQ。由此看,优先改善“生成什么形状、哪些位置应靠近”,比单纯打磨最后的摆放算法更有针对性。
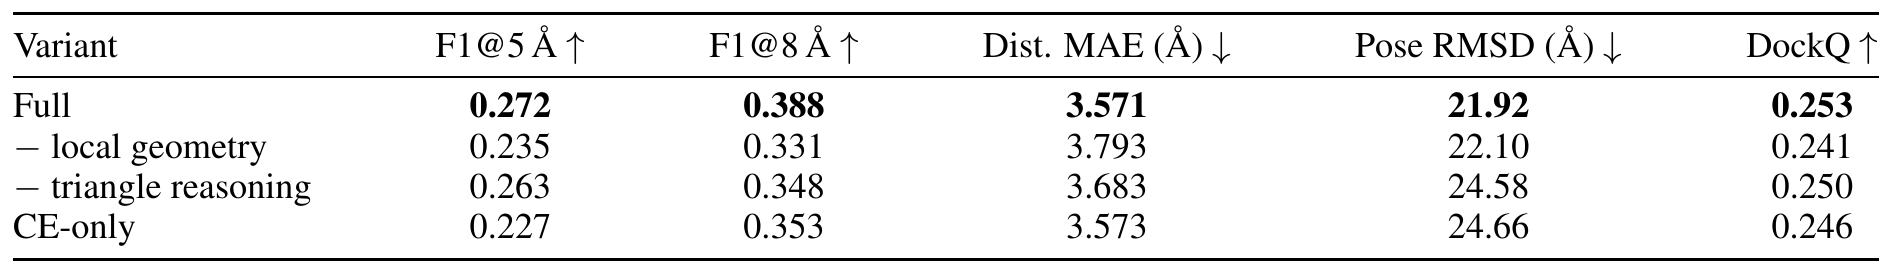
距离模块内部的消融也提醒我们,平均误差并不能说明一切。去掉显式接触监督,距离平均绝对误差几乎不变,近距离接触的F1却下降;去掉局部几何特征,接触预测也变差。不过,这些改动对应的最终DockQ差距较小,不能据此宣称每个组件都带来大幅收益。
不同位点与长度,打开的是候选空间
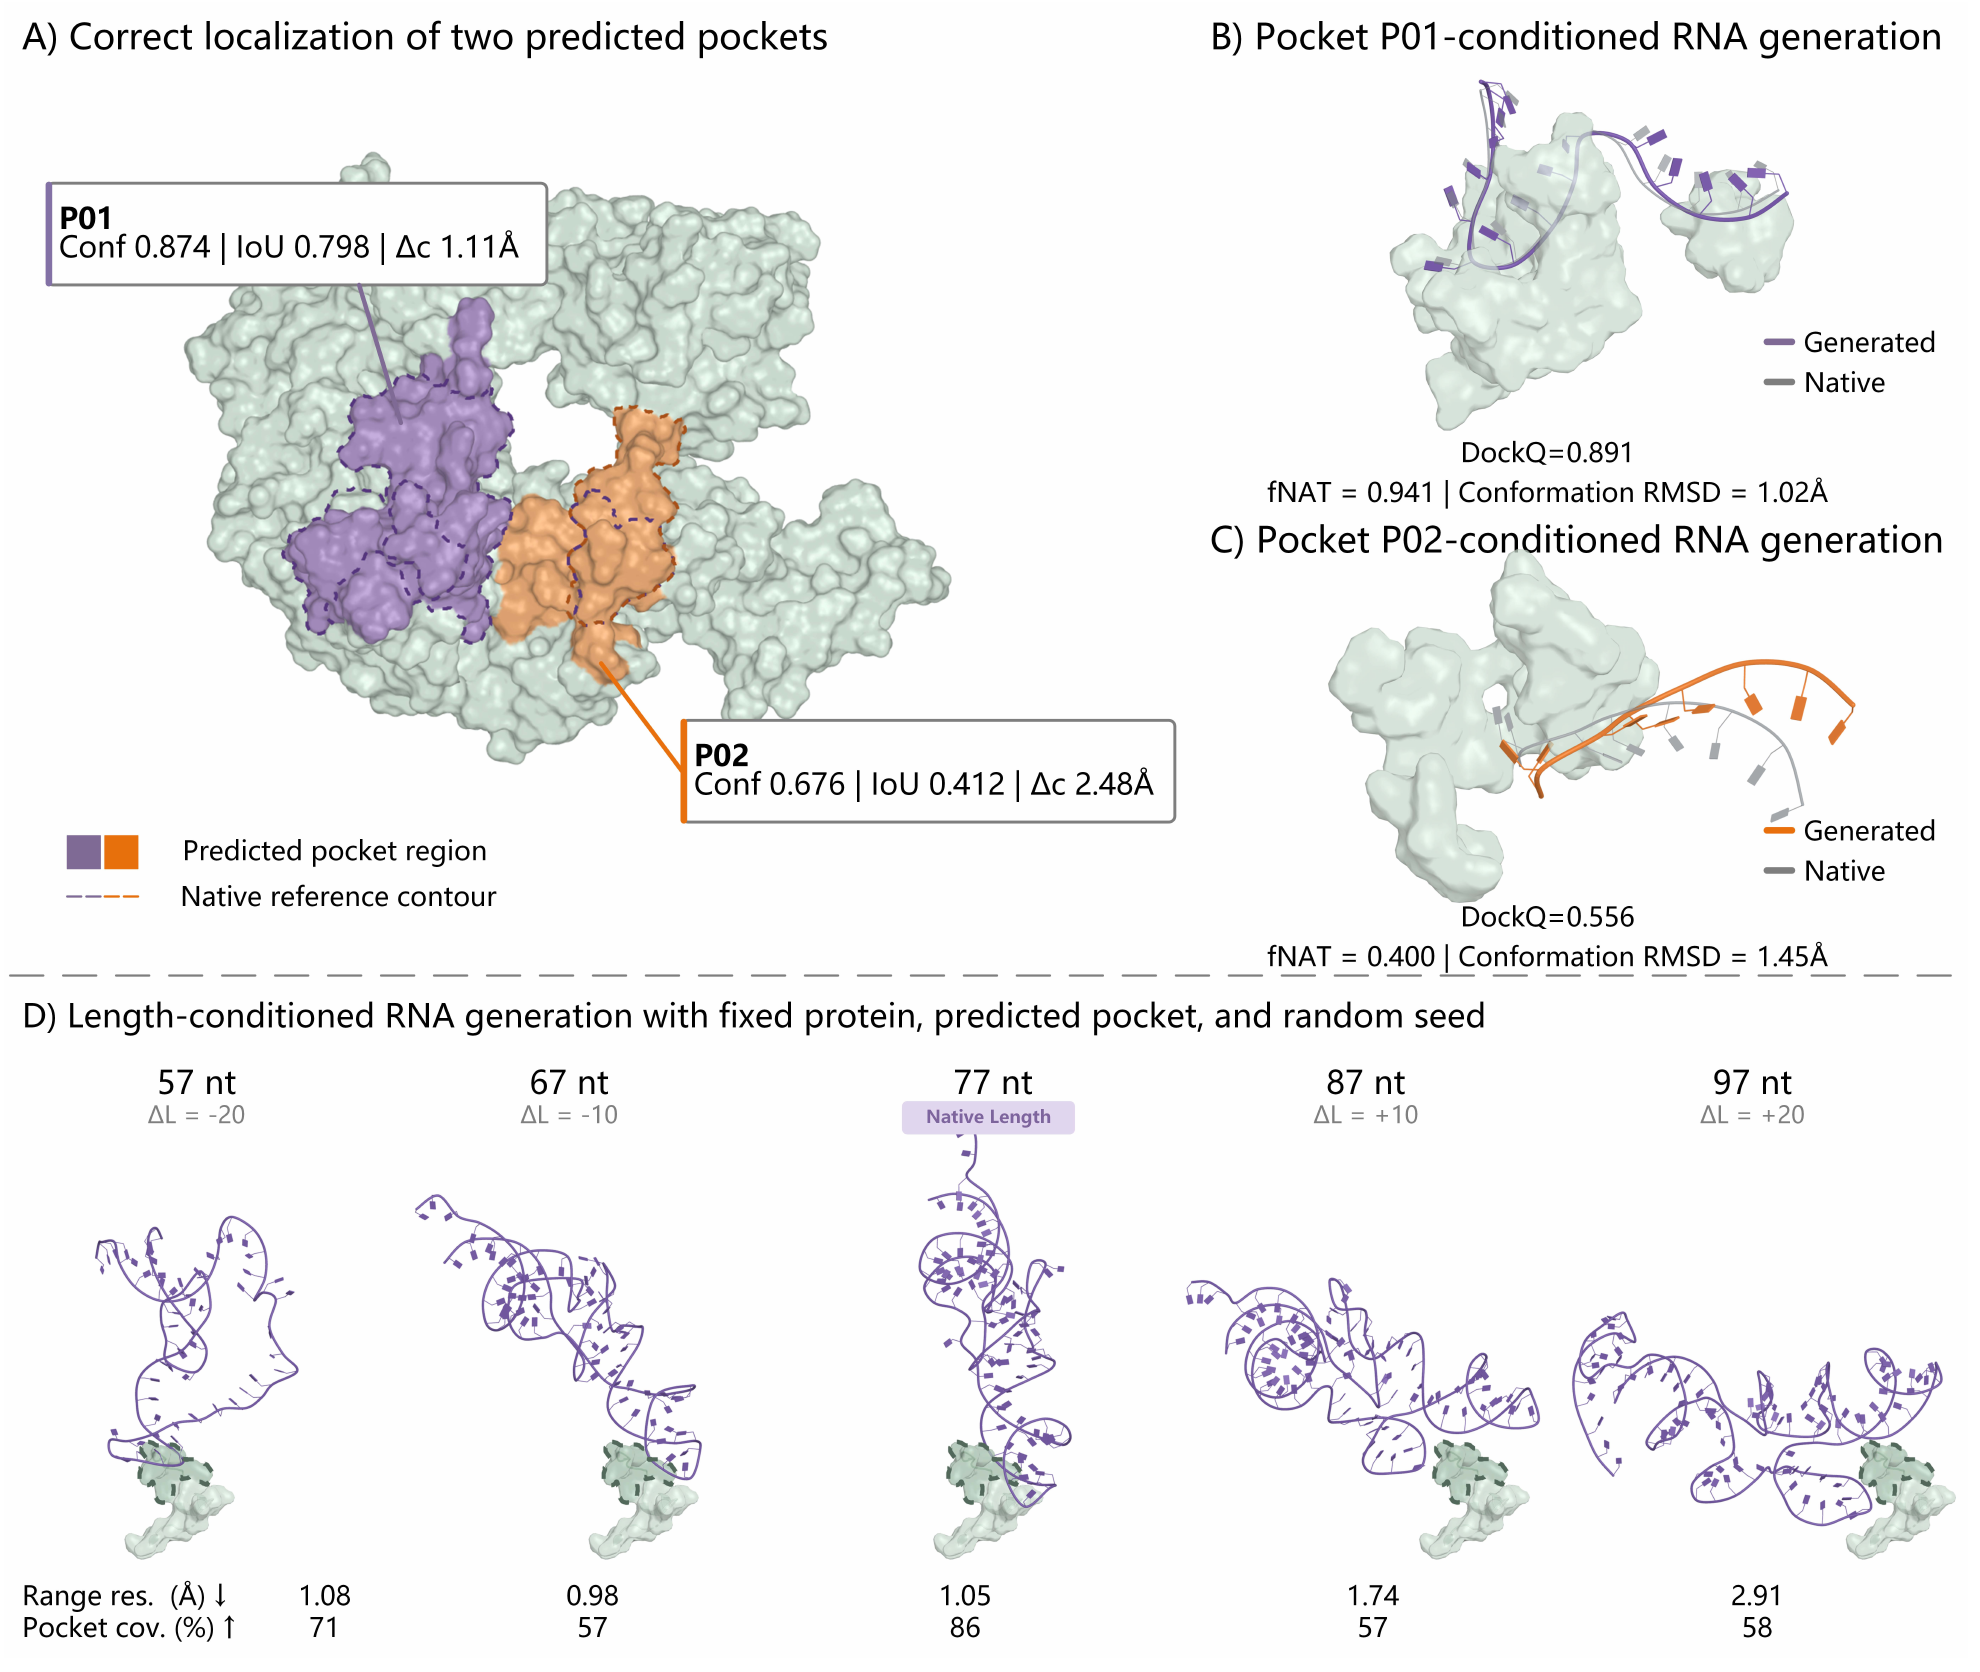
案例中,同一个蛋白上两个相隔的预测界面,分别得到不同RNA形状和姿态,对应DockQ为0.891和0.556。这说明多位点假设可以产生不同结合方案,但它们是挑出的示例,不能代替全测试集表现。
另一个目标固定蛋白、位点与随机种子,只把RNA长度从57调整到97个核苷酸。生成结果都满足指定长度,并接触同一候选位点;但较长的87、97核苷酸结构,对预测距离约束的符合程度变差。长度可控,不等于越长越好。
回到最初的问题,RiboBridge提供了一种从蛋白结构出发、探索RNA形状与结合姿态的计算路线。它的价值还在于把后续该改哪里指得更清楚:候选位点需要可靠排序,生成的结构需要找到能实现它的序列。
这篇工作目前是arXiv预印本,未报告湿实验结合验证。对于真正要合成RNA的研究者,现阶段更适合把它视为结构候选生成与误差分析框架,而非已经能够交付高亲和力RNA的设计工具。
FOLLOW THE QUESTION