Chaperone: turning protein design tools into inspectable workflows
From resource-use comparisons across nine tasks to binder, nanoparticle, and crystal experiments, examine what a tool framework adds to agent-driven protein design.
华盛顿大学IPD · David Baker团队 · 2026-10-20
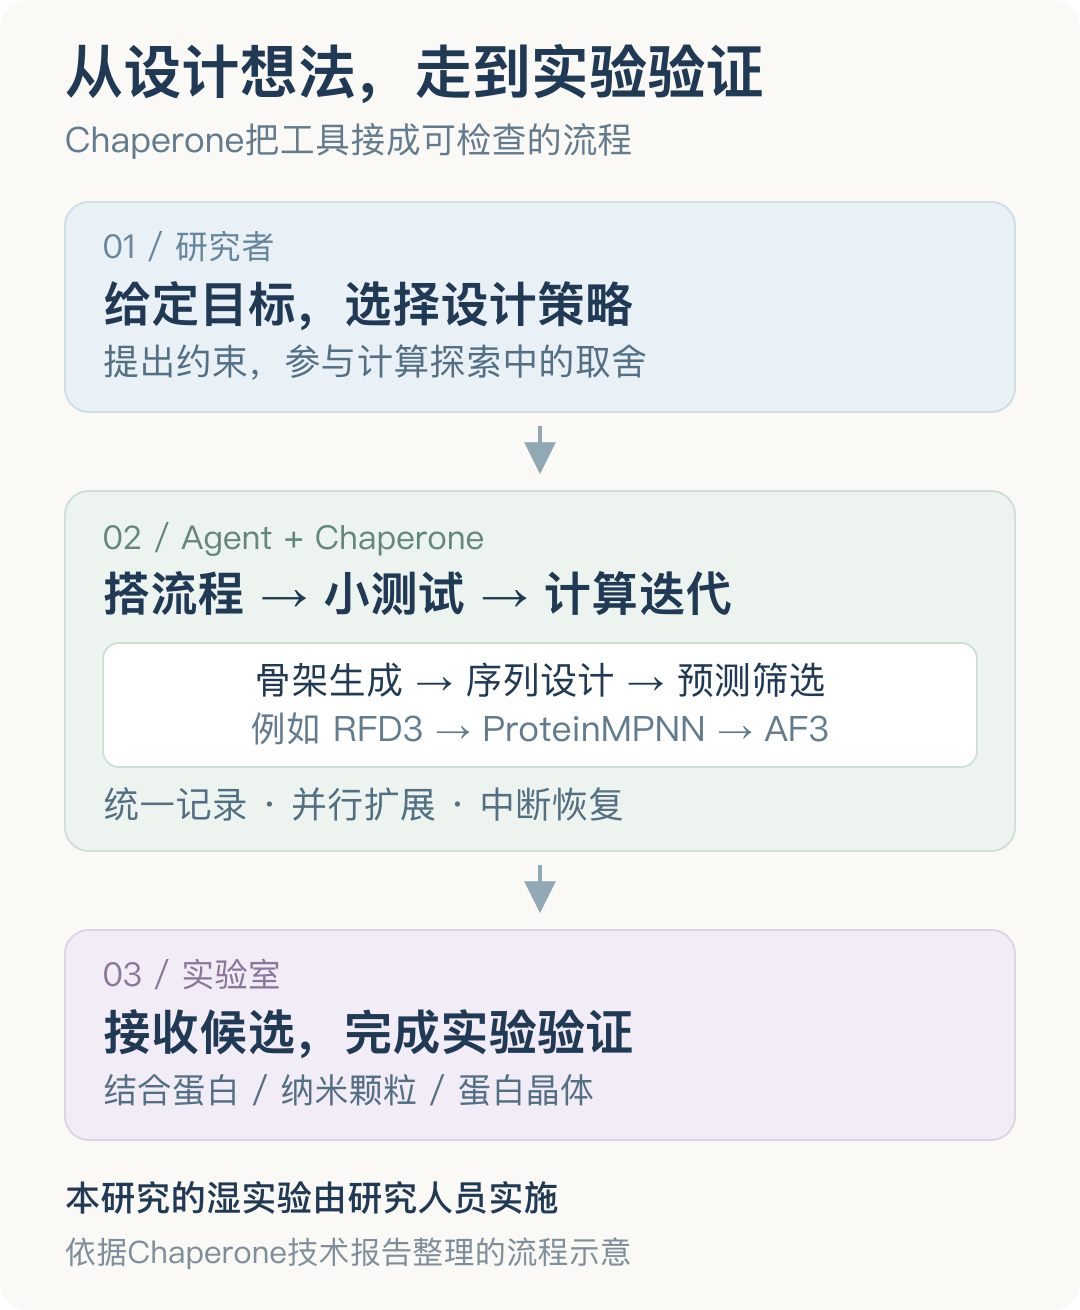
Chaperone把分散的蛋白设计工具接成可测试、可扩展的流程,减少Agent的执行开销,并将设计交到实验室检验。
让AI写出一份蛋白设计方案,和让它把设计真正跑完,中间隔着一长串工具:生成骨架、设计序列、预测结构、计算指标,还要处理格式转换、集群排队和失败重跑。Agent的时间和Token,可能就耗在这些衔接工作上。
David Baker团队的Chaperone瞄准了这个缺口。它把RFD3等专业模型接入统一工作流,让Agent能编写、测试和修改设计流程。报告给出了两层证据:九类任务中的计算效率对照,以及三种设计任务的实验验证。
给设计工具统一接口,Agent才有余力探索
Chaperone是一套工作流框架。报告介绍,它整合了RFdiffusion3(RFD3)、ProteinMPNN、AlphaFold3(AF3)及50余种其他蛋白设计工具;原图的注册表包含80余个功能模块。工具与模块口径不同,一个工具可以有多种封装方式。
关键设计可以理解成一份持续更新的“设计台账”:每行对应一个候选,记录结构、文件位置、残基信息和评价指标。每个工具模块接收这份表格,完成任务后,再把新结构和分数补回相应候选。上一步的结果自然成为下一步的输入,设计的来龙去脉也能追溯。
这让Agent能够把生成、预测、筛选和自定义分析写进同一个脚本。例如,在RFD3生成骨架之后加入自定义筛选,再衔接LigandMPNN序列设计和AF3预测。研究者想改变筛选规则时,可以修改对应环节,无须重新搭建整条流程。
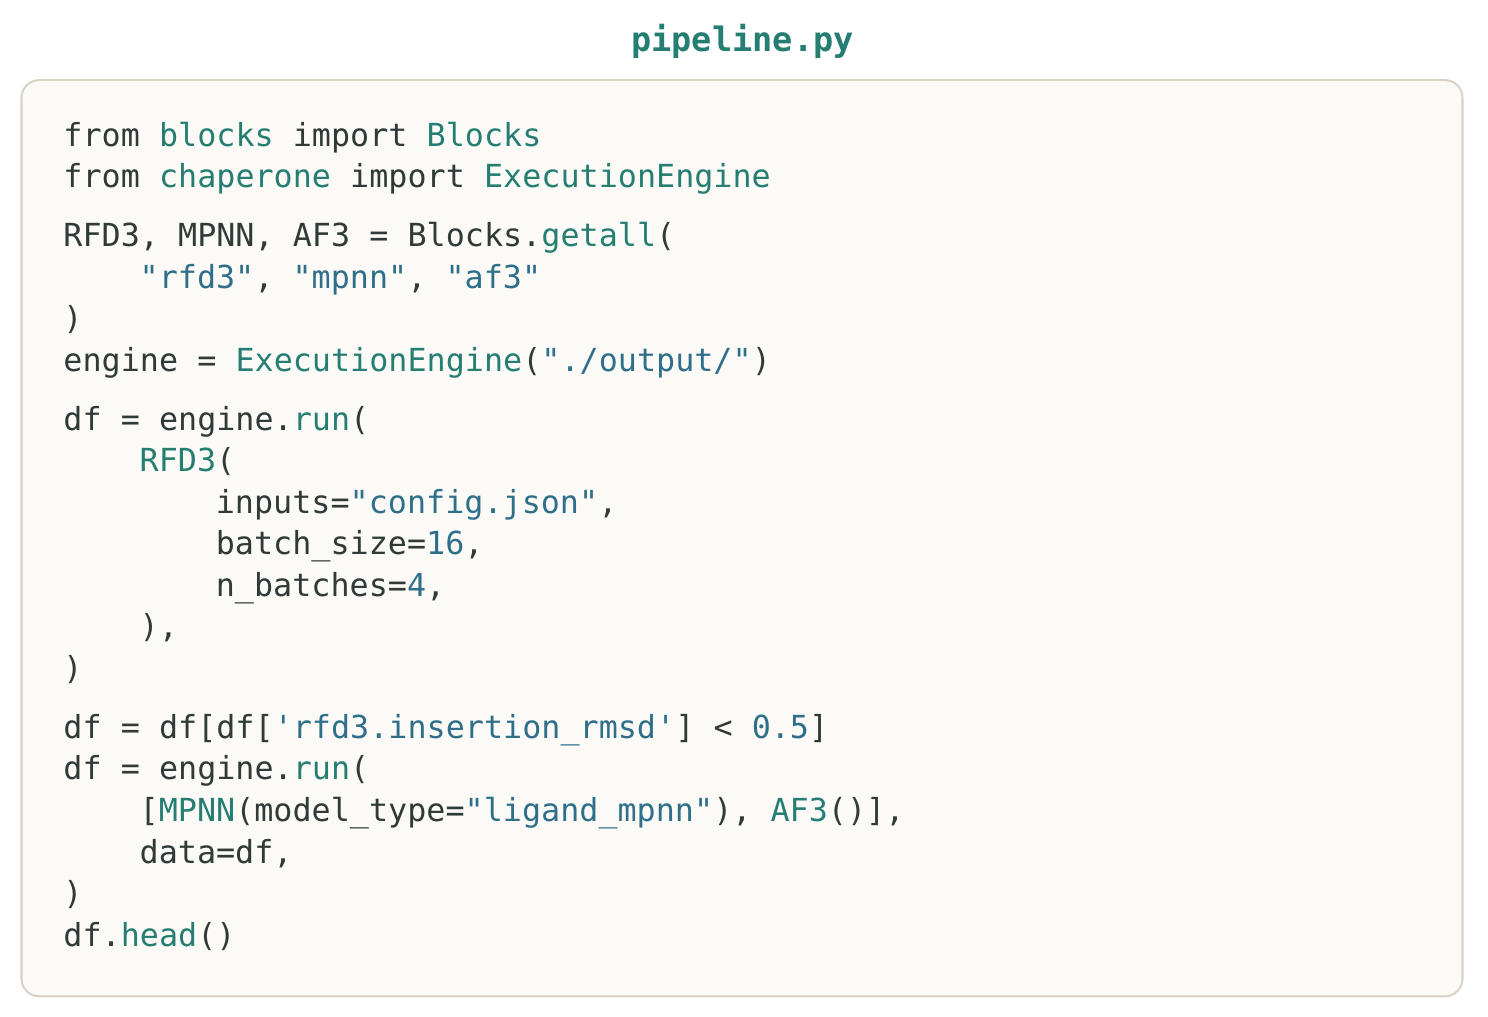
框架还提供工具文档、示例和工作流技能。Agent先用少量样本检查整条流程是否跑通,再用同一脚本扩大规模。执行引擎负责分块并行、保存中间结果和恢复未完成任务,也能把多个步骤放在同一作业里,减少反复排队。
先把流程跑通,再扩大设计规模,因此成为一个可反复检查的过程。模型的推理能力能否转化成产出,也取决于它身边这套工具环境是否顺手。
Token少86%,计算通过率接近翻倍
作者围绕酶、蛋白及核酸结合、对称组装、抗体改造等设置了九类任务,使用GPT-5.6 Sol经Codex运行。每轮有12小时计算窗口,需要提交96条具有序列多样性的候选;独立评分流程从序列重新预测结构,再检查预设标准。
以原文Figure 1图注的汇总口径,在低、中、高推理强度的81次运行中,接入框架后,平均计算设计通过率从6.1%升至11.7%;每轮Token用量下降86%,GPU小时下降64%。这里的GPU小时是累计资源用量,不能直接换算成墙钟时间缩短了64%。
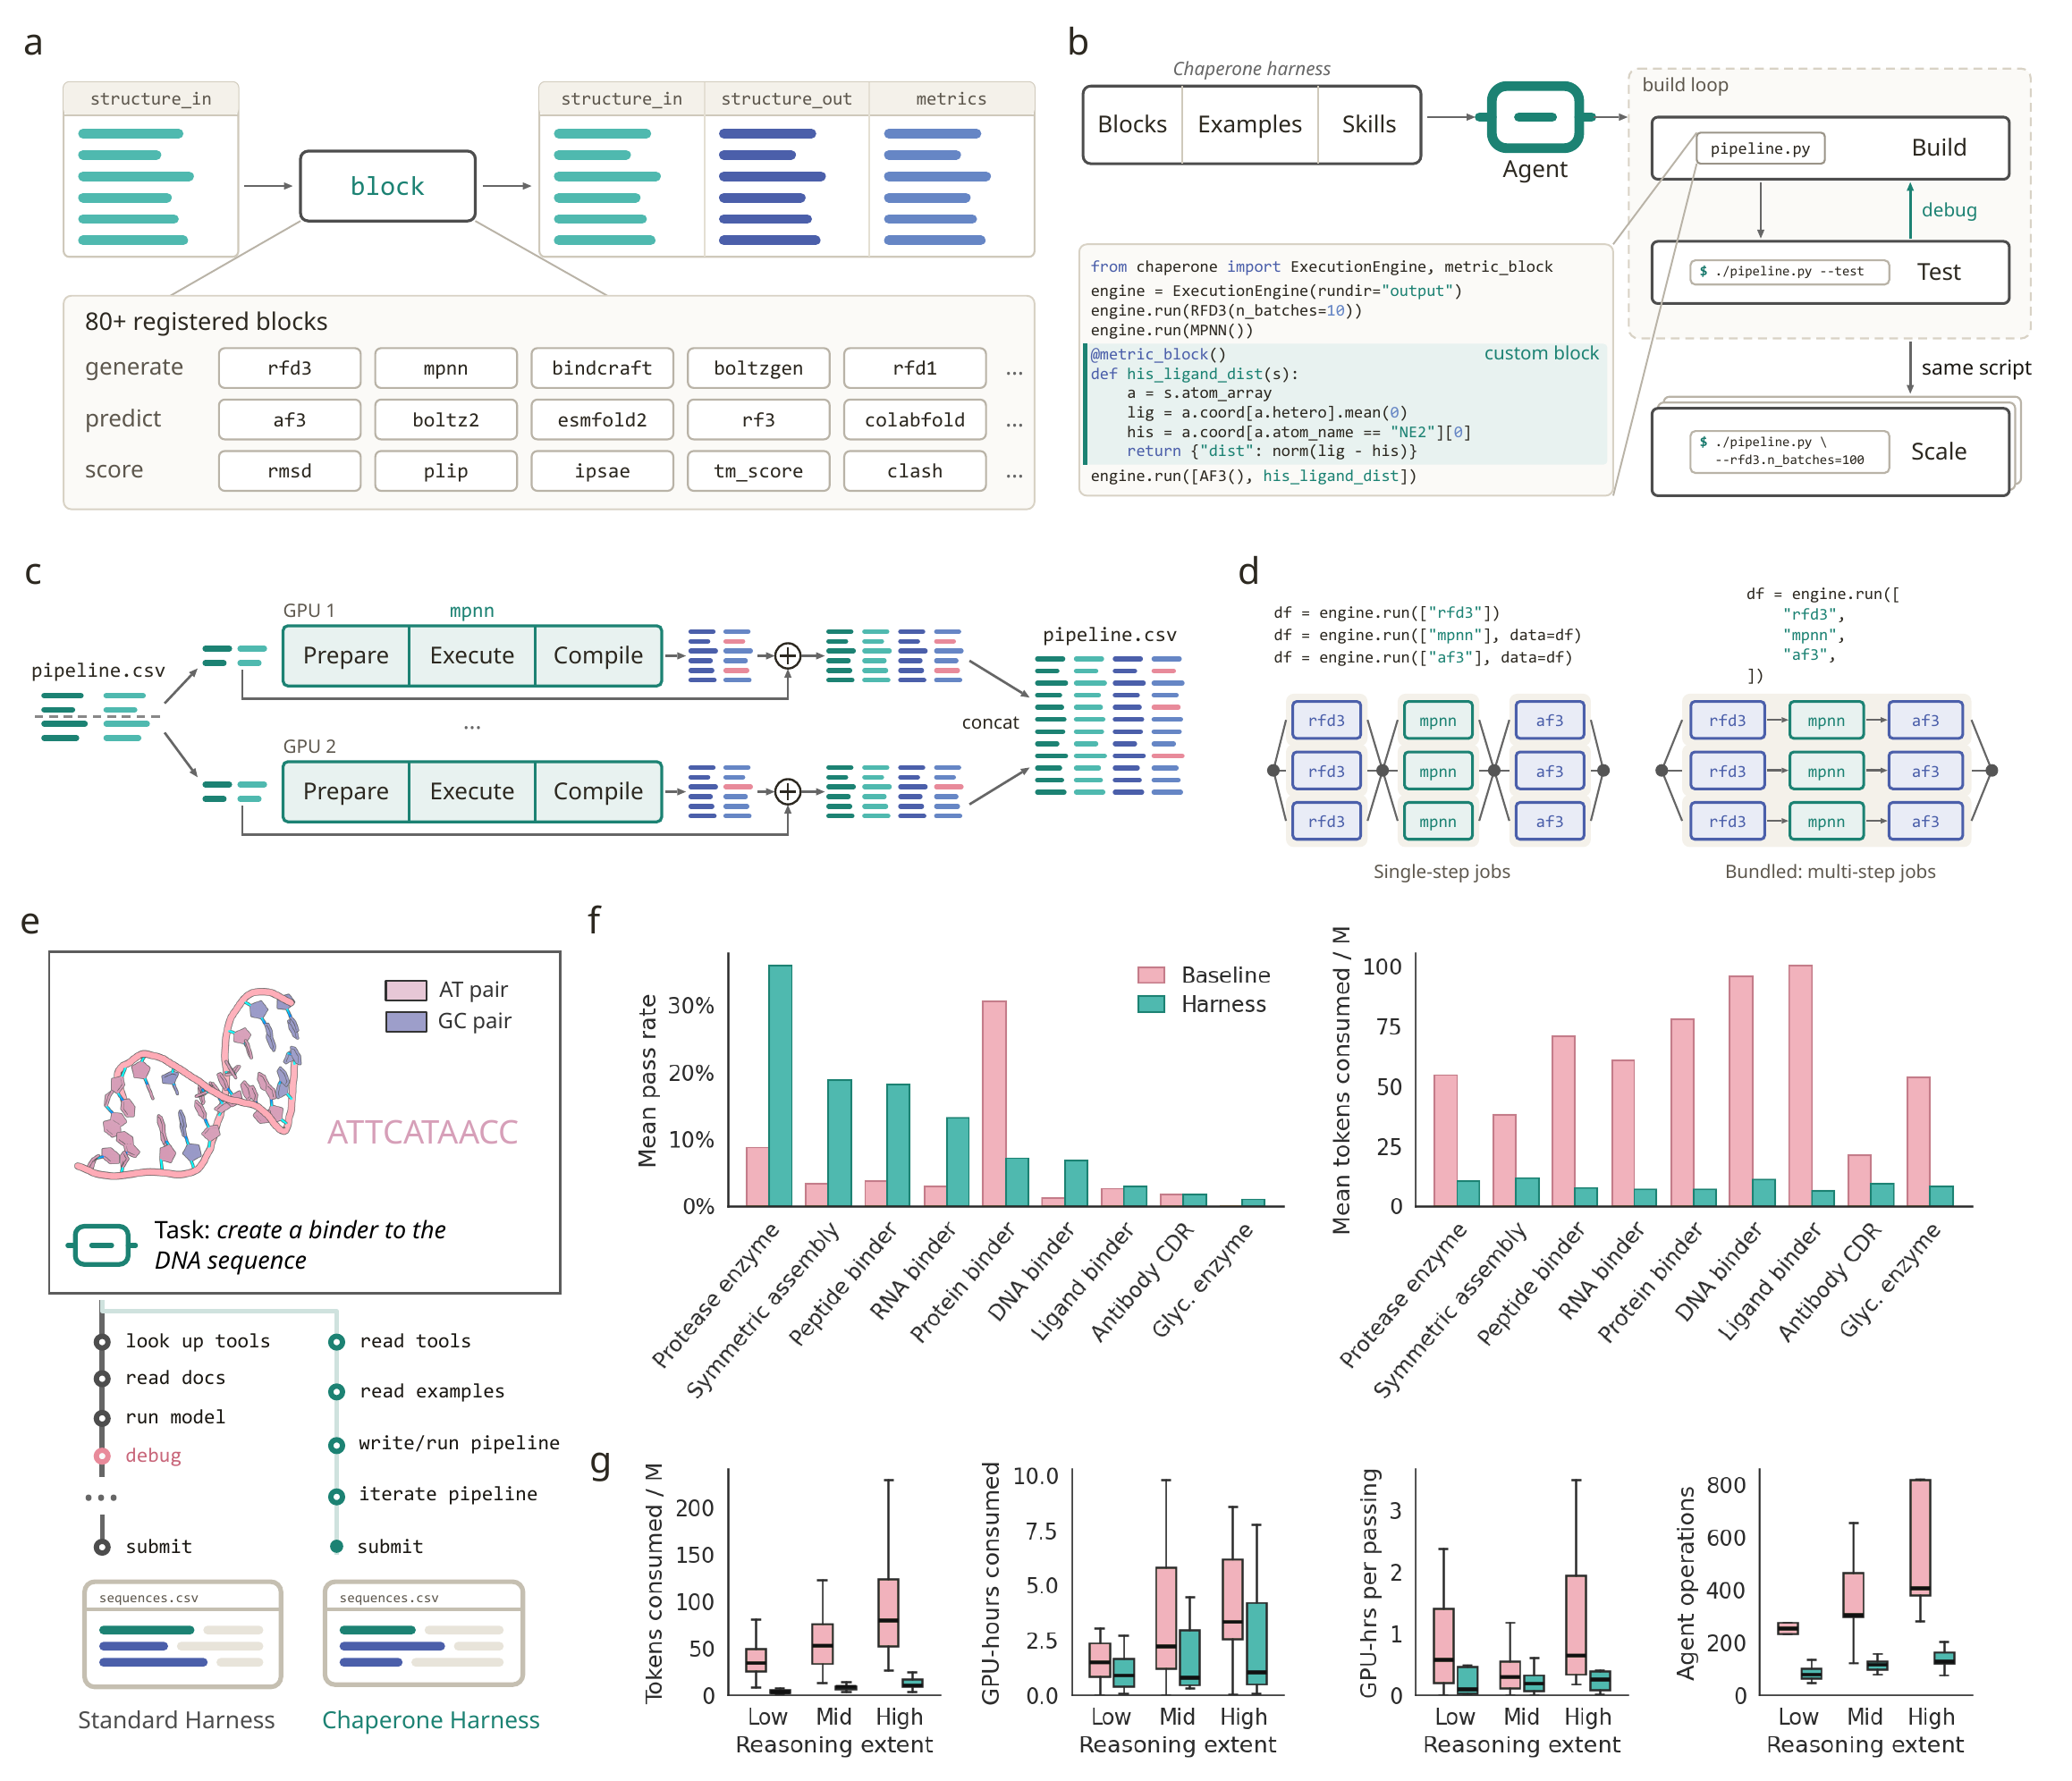
读图时可以先看f面板:六类任务的通过率更高,两类接近,PD-L1蛋白结合任务反而较低。平均提升并不意味着每个靶点都受益。g面板则显示,基线Agent提高推理强度时,Token及操作次数增长明显;接入框架后,这些开销受到抑制,反复查询作业状态的行为也减少了。
这组比较测试的是完整工具环境带来的实际收益:基线Agent可以联网找工具并安装,框架组预装了所需容器并关闭网络。它包含环境准备和流程管理的差异,尚不能单独证明模型的生物学推理能力提高了多少。
此外,6.1%与11.7%对应结构、几何和能量等计算标准。它们不能当作湿实验命中率;实验是否成立,要看下一组结果。
两周推进到送检序列,皮质醇结合有了实测结果
皮质醇是一种小分子。为它设计结合蛋白,需要同时考虑口袋形状、疏水接触和氢键网络,单靠某一个模型的分数很难决定最佳路线。
研究者与Agent共同探索不同的骨架生成位置、蛋白长度、LigandMPNN氨基酸偏好,以及结构预测与筛选组合。Agent在设计者指导下执行、监测了104次小规模计算;研究者挑出更有希望的设置,再扩大生成规模。
报告写明,从初始设计假设到准备好送检序列用了两周。这个计时终点在湿实验之前;它体现的是设计流程开发与计算筛选的周期。
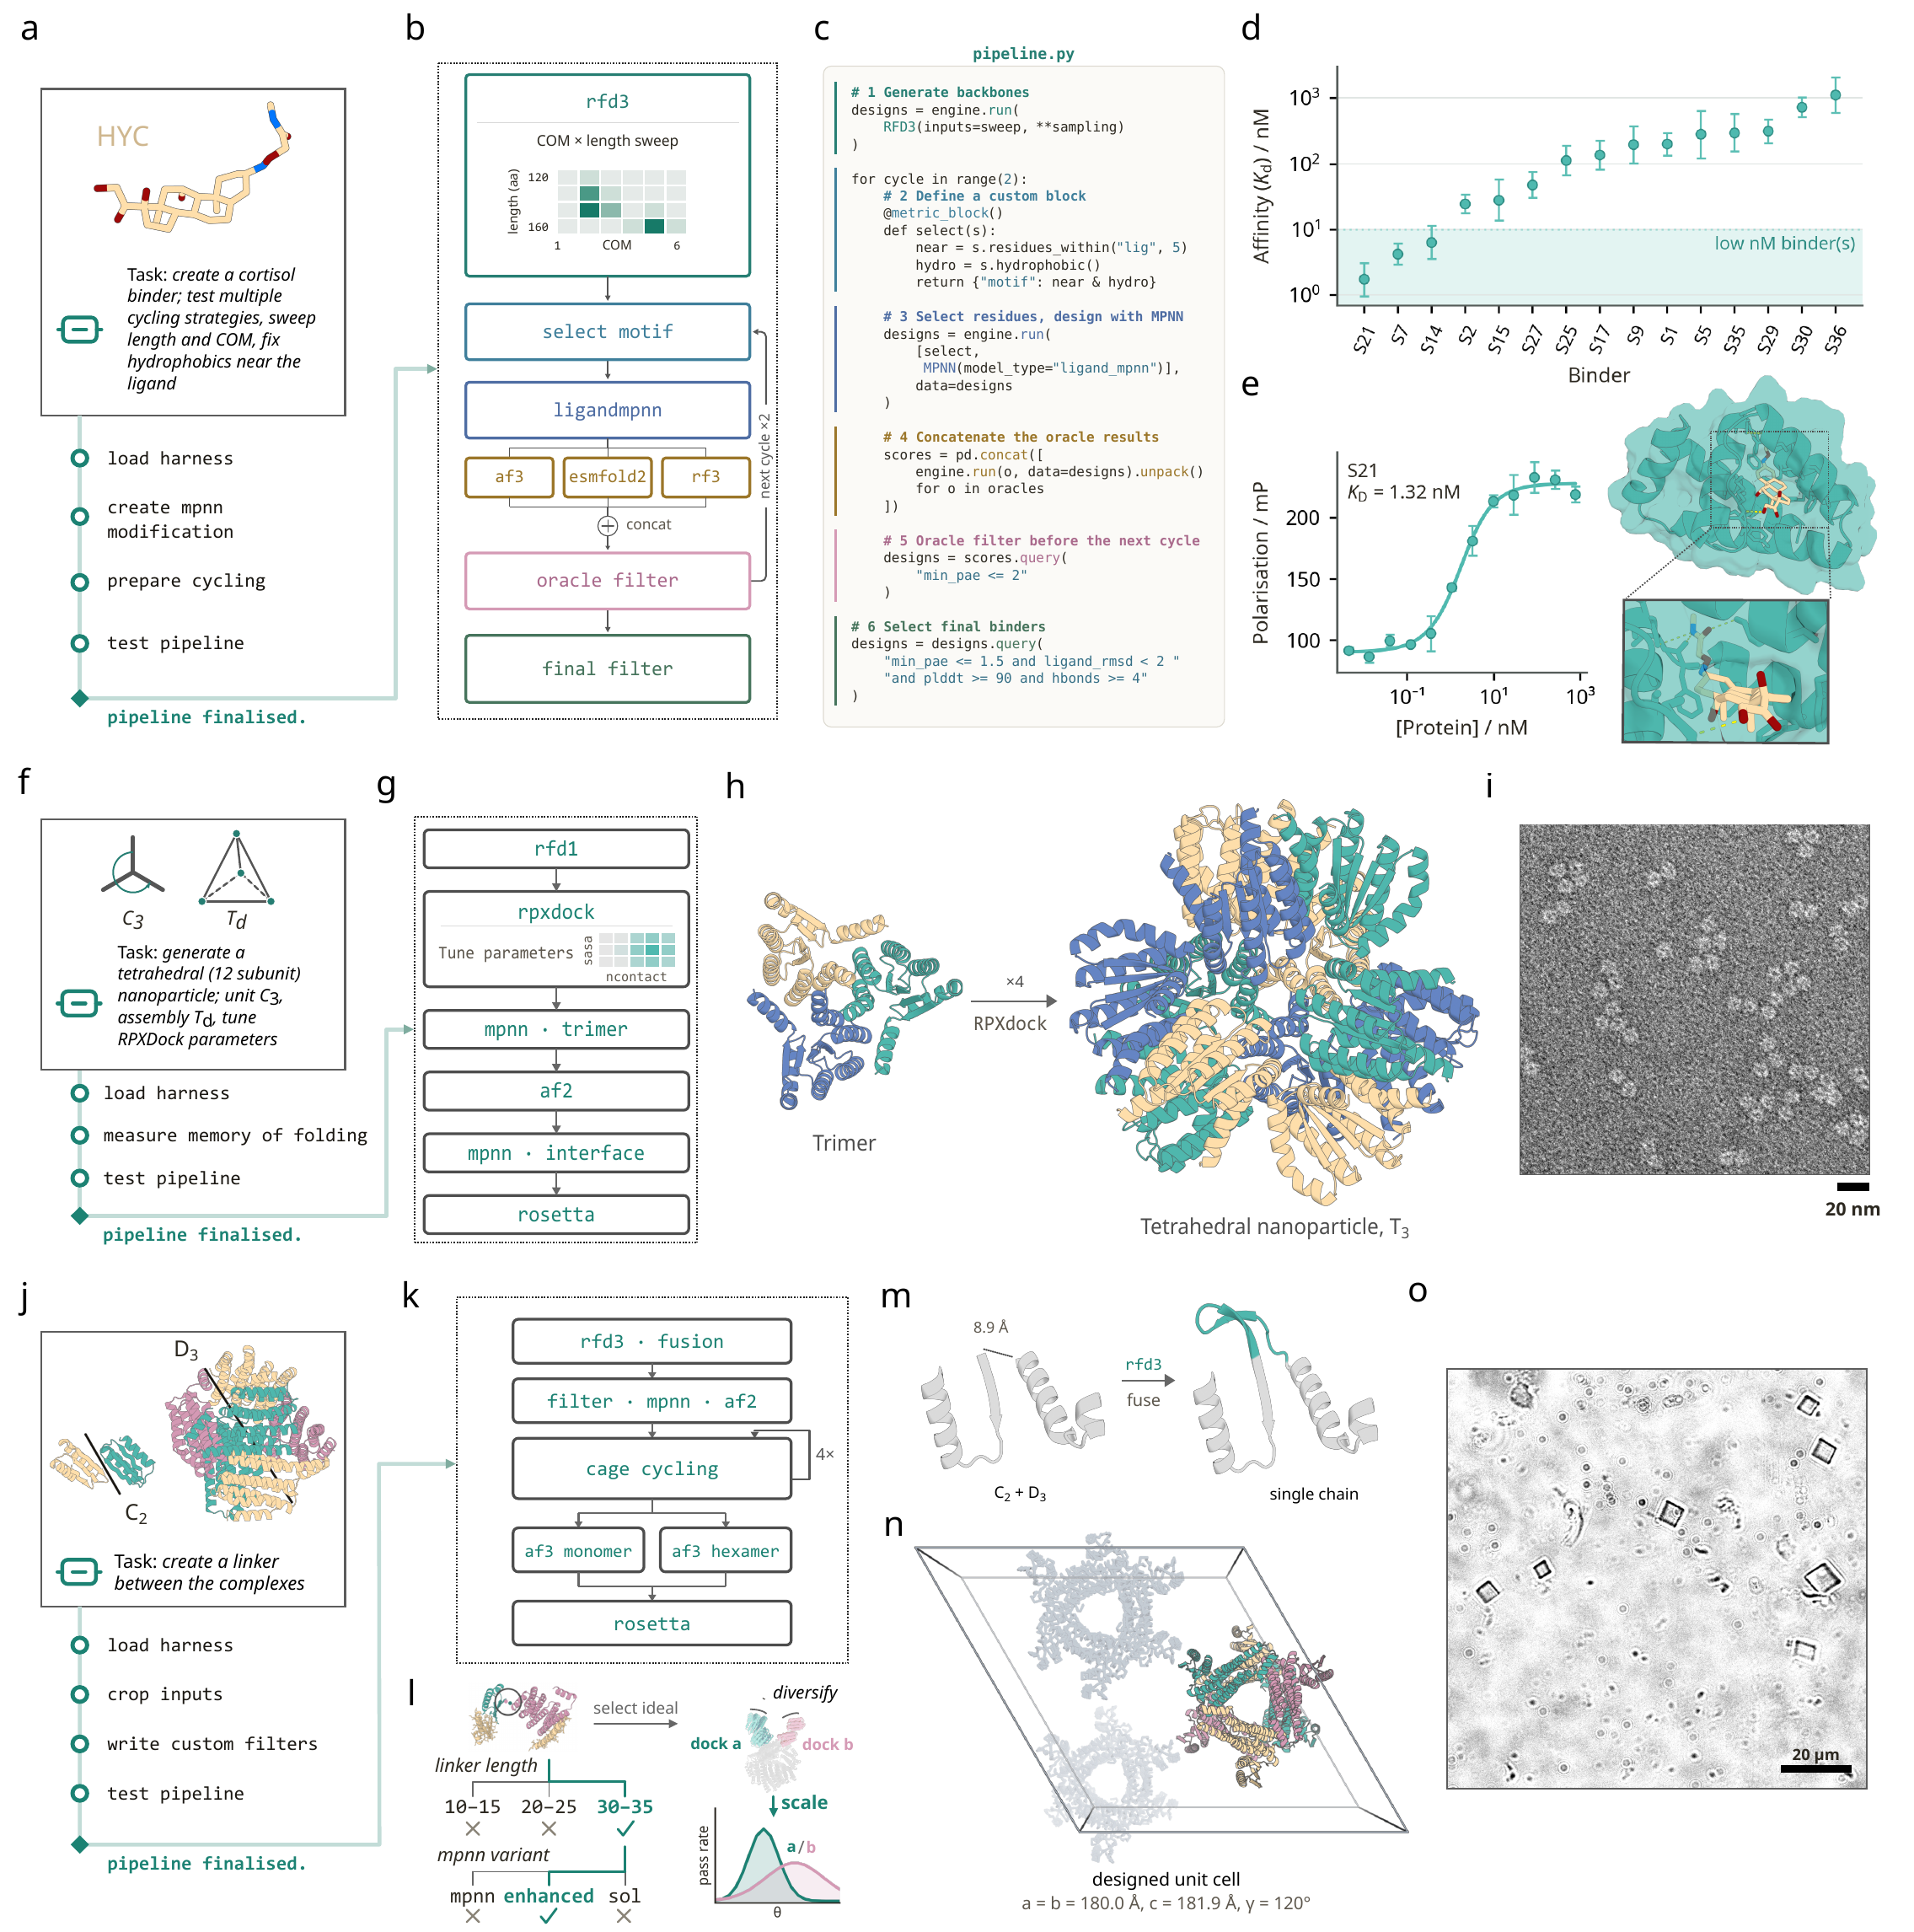
在首轮荧光偏振(FP)检测的27个候选中,15个得到有数据支持且无质控标记的亲和力拟合,9个拟合带有质控标记,3个没有明确响应。原图d只画出了前15个,因此不能把图中候选都理解为全部送检样本。
最佳候选S21的表观解离常数K_D为1.32 nM,没有经过亲和力成熟。K_D较低表示在该测定条件下结合更紧;这里所说的“零样本设计”,也不排除此前大量计算探索和候选筛选。
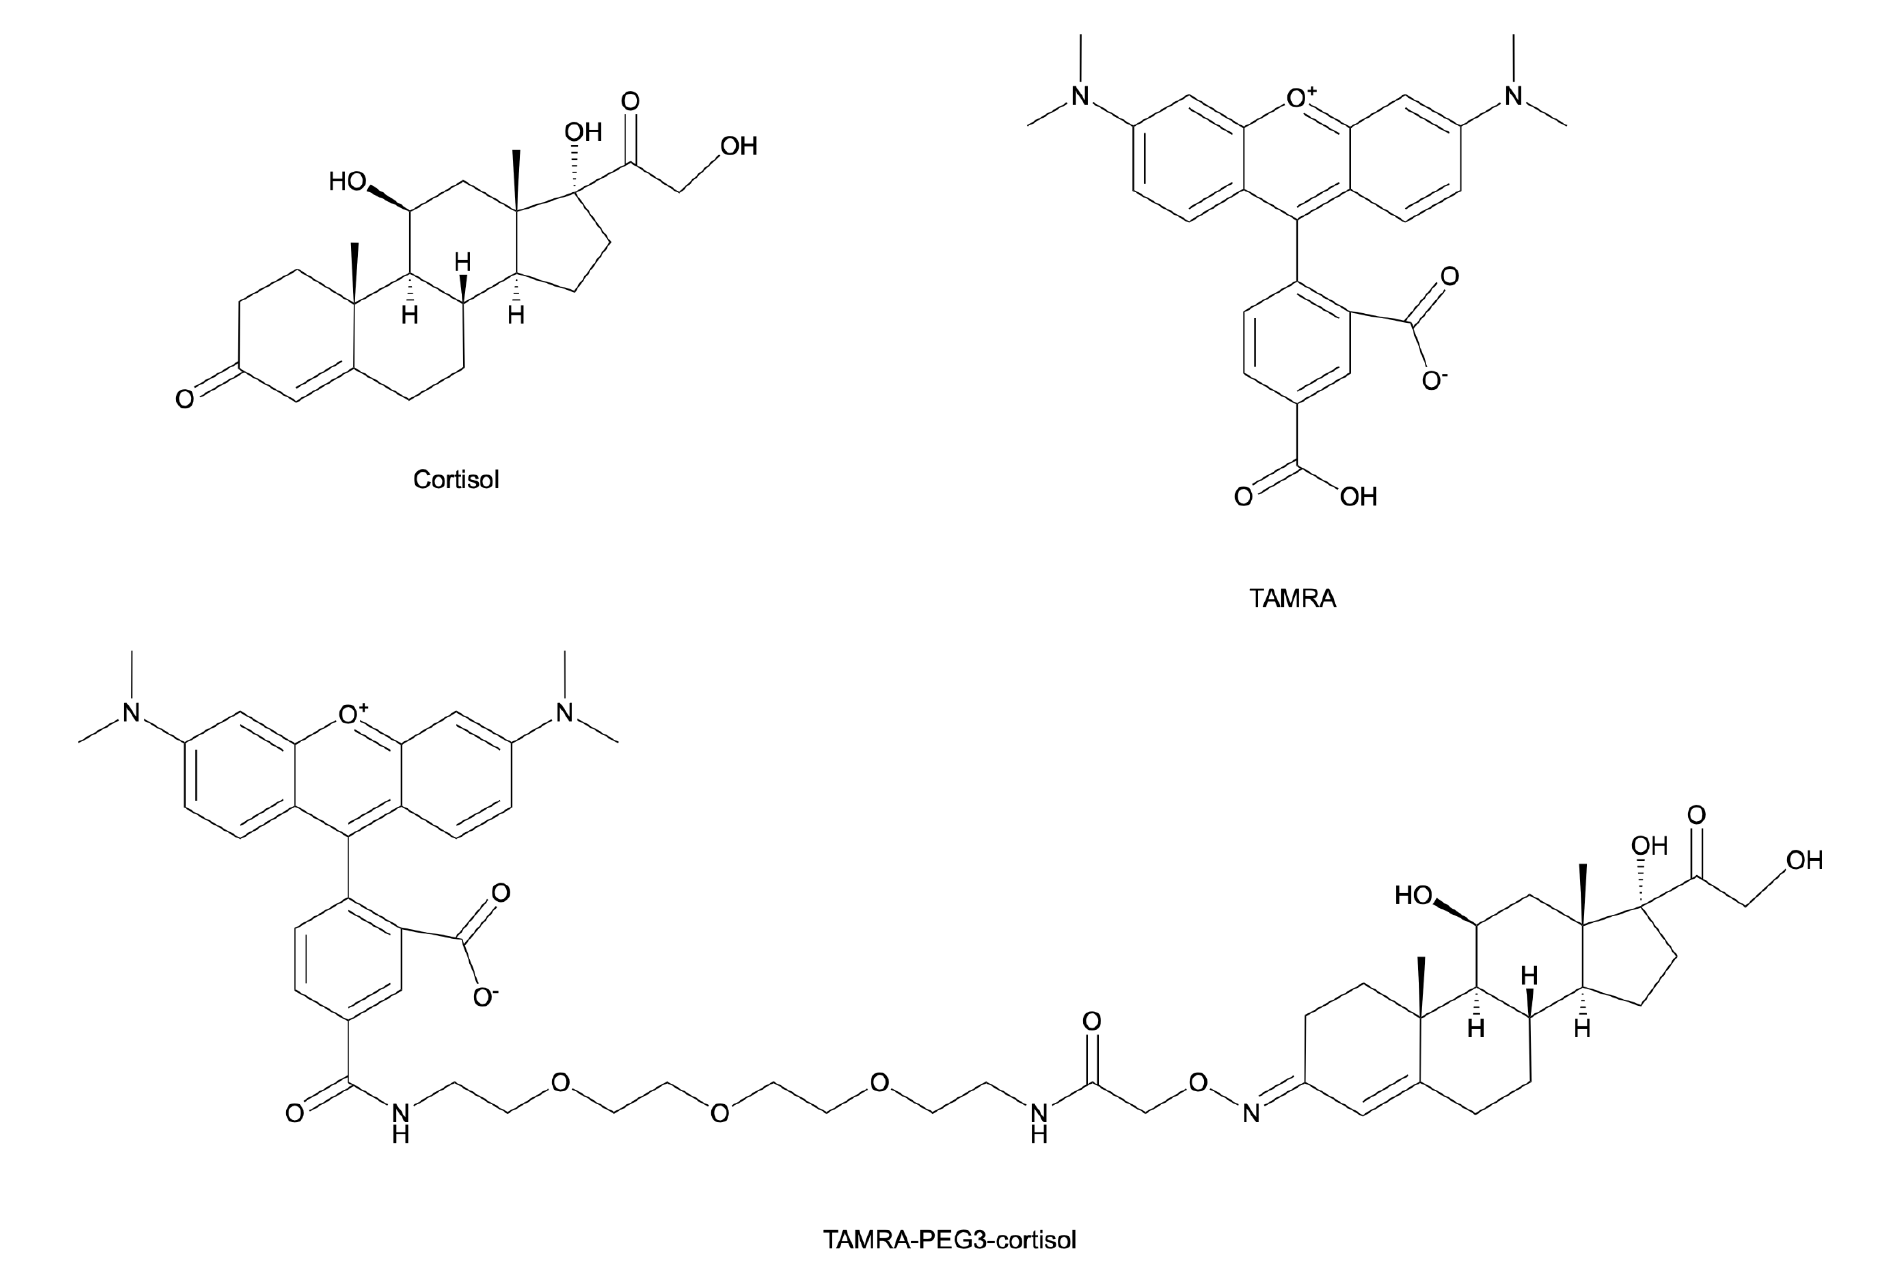
这个数值还有一个关键条件:FP使用的是荧光标记探针TAMRA-PEG3-cortisol。补充方法记录了TAMRA对照与未标记皮质醇竞争检测,但1.32 nM本身仍是标记探针体系的拟合值,不应直接写成游离皮质醇的独立实测亲和力。
从纳米颗粒到晶体,验证流程能否换任务
结合蛋白之外,团队又让Agent设计带有三聚体基序的四面体纳米颗粒。流程串起RFD1、负责几何对接的RPXdock、ProteinMPNN、AlphaFold和Rosetta,检验框架能否接入常规生成与预测之外的软件。
15个送检设计中,1个成功组装,命中率6.7%。原图Figure 2中排给出12亚基设计模型及负染电镜,观察到预期大小的颗粒。这个结果支持流程产出了可组装候选;电镜在此提供形态与尺寸证据,还没有给出原子级结构验证。
另一个任务是用刚性连接肽,把C2和D3对称蛋白组件融合起来,为晶体组装保持相对取向。组件的预定位由实验室另一套流程提供;Agent探索连接长度、序列设计方法和迭代策略,再把同一流程扩展到更多输入。
原图下排展示H11的设计连接区、预期晶胞和实际观察到的晶体。明场显微镜证实出现了晶体形态,报告未提供衍射解析的结构来确认预期晶格。三类任务的实验读数各不相同,共同检验的是框架能否组织多步计算,并交付可实验测试的设计。
蛋白设计Agent,要配上一套可检查的工作环境
这项工作对正在搭建Agent蛋白设计流程的团队,有一个具体启发:把工具接口、设计记录、小规模测试和任务恢复做好,本身就可能显著改善效率。研究者能保留选择设计路线的角色,Agent则承担流程编写、调度与计算迭代。
Chaperone已提供公开代码和文档,可配合Claude Code、Codex等编码Agent使用;本文的定量对照集中在GPT-5.6 Sol,其他模型能获得多大收益仍待测试。容器、模型权重和计算资源也需要按所用工具配置。
这是一套通向实验验证的设计工作流:计算端可以自动迭代,湿实验仍由研究人员实施。报告没有展示Agent直接控制物理设备,也没有证明湿实验结果已经自动回流驱动下一轮设计。对团队而言,值得借鉴的是把每一步做成可追踪、可检查、可扩展的流程,再逐步缩短设计与实验之间的距离。
论文信息
| Title | Reliable and Efficient Agentic Protein Design with Toolset Harnessing |
| Source | Chaperone技术报告;官方GitHub仓库公开 |
| Report added to repository | 2026-10-20 |
| URL | https://github.com/RosettaCommons/chaperone/blob/main/docs/chaperone-report.pdf |
本文依据原稿在2026年10月21日核对的技术报告版本;日期对应该报告加入仓库的记录。该PDF当时未标注期刊、DOI或独立发表日期,2026年10月25日整理时,官方仓库已提供 bioRxiv 预印本入口;本文未重新核对该版本全文,不将两版数据混合。
来源与资源
| 资源 | 内容 | 链接 |
|---|---|---|
| 完整报告 | 本文实验、评测与原图的来源 | https://github.com/RosettaCommons/chaperone/blob/main/docs/chaperone-report.pdf |
| 官方代码 | Chaperone框架与工具接口 | https://github.com/RosettaCommons/chaperone |
| 官方文档 | 模块、示例与Agent使用说明 | https://rosettacommons.github.io/chaperone/ |
原始图表来源:Butcher、Chen等,Chaperone技术报告。中文流程图依据报告整理;正文数据以所提供PDF为准,资源入口以官方仓库核对。
FOLLOW THE QUESTION