Carbon-X:让 DNA 分析走进聊天框
从变异评分、序列特征识别到科研 Agent 调用,理解 Carbon-X 的输入方式、部署条件与预测边界。
Hugging Face联合中关村学院、TIGEM等团队发布Carbon-X:把DNA序列放进聊天框,就能围绕序列提问、获得预测和解释。
可以分析哪些问题
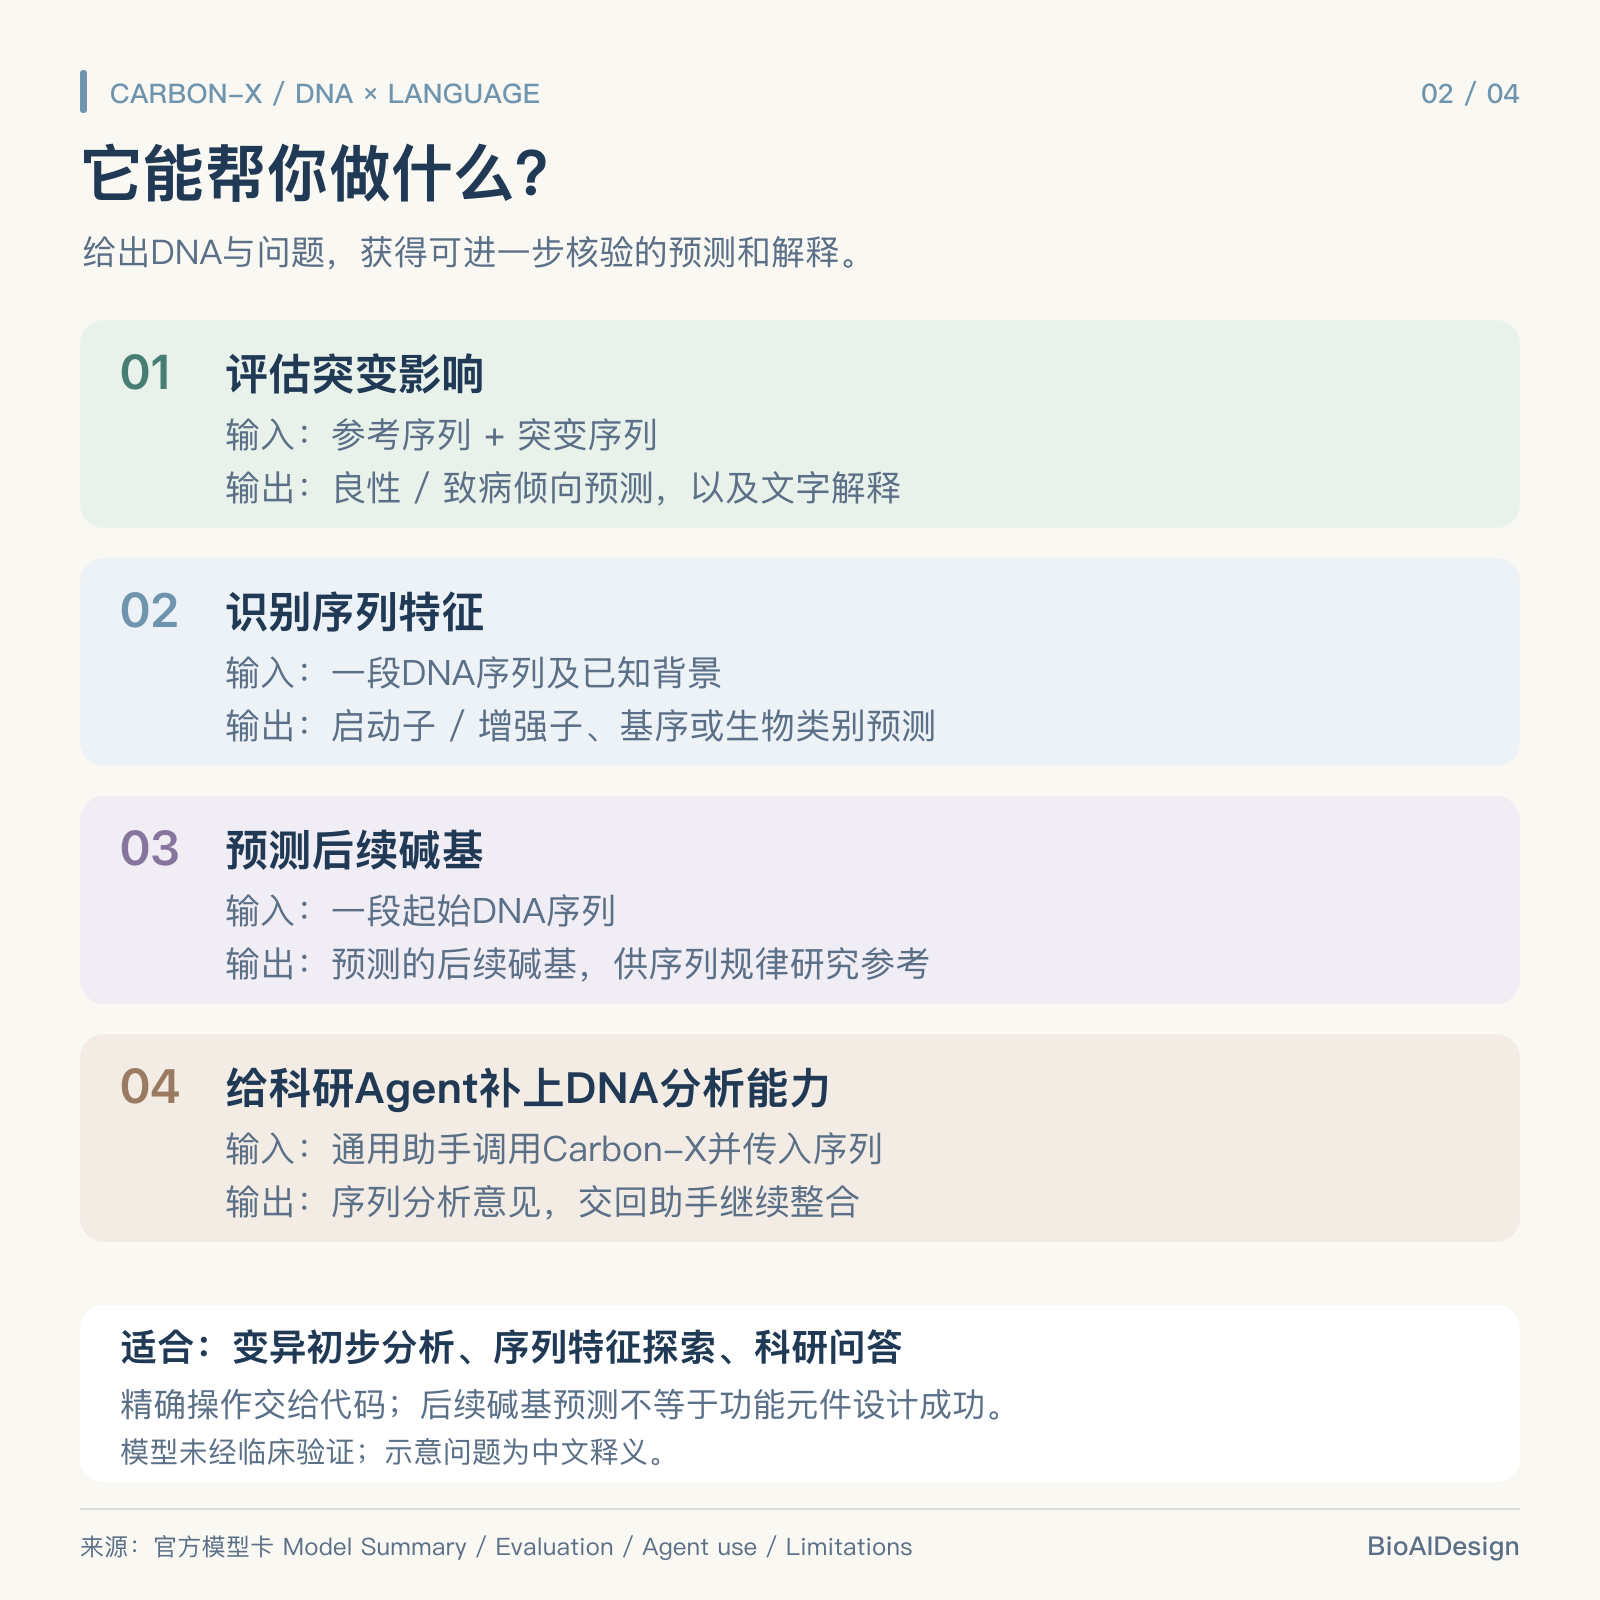
- 评估突变:输入参考序列与突变序列,辅助判断变异更可能良性还是致病,并给出解释。
- 识别序列:预测一段DNA更像启动子还是增强子、含有什么基序,或属于哪类生物。
- 预测后续碱基:给定一段DNA,尝试续写后面的序列,用于研究序列规律。
- 接入科研Agent:让通用助手遇到DNA问题时调用它,获得基于序列的分析意见。
对研究者来说,可以把它用于变异初步分析、序列特征探索,再结合注释、专用工具和实验确定哪些判断可信。
DNA 和自然语言怎样共用模型
模型基于Qwen3-14B,总参数约148亿,经过3020亿token中期训练,再进行监督微调与强化学习。DNA按6个碱基一组编码,与自然语言共用同一个模型。
如何理解能力与成本
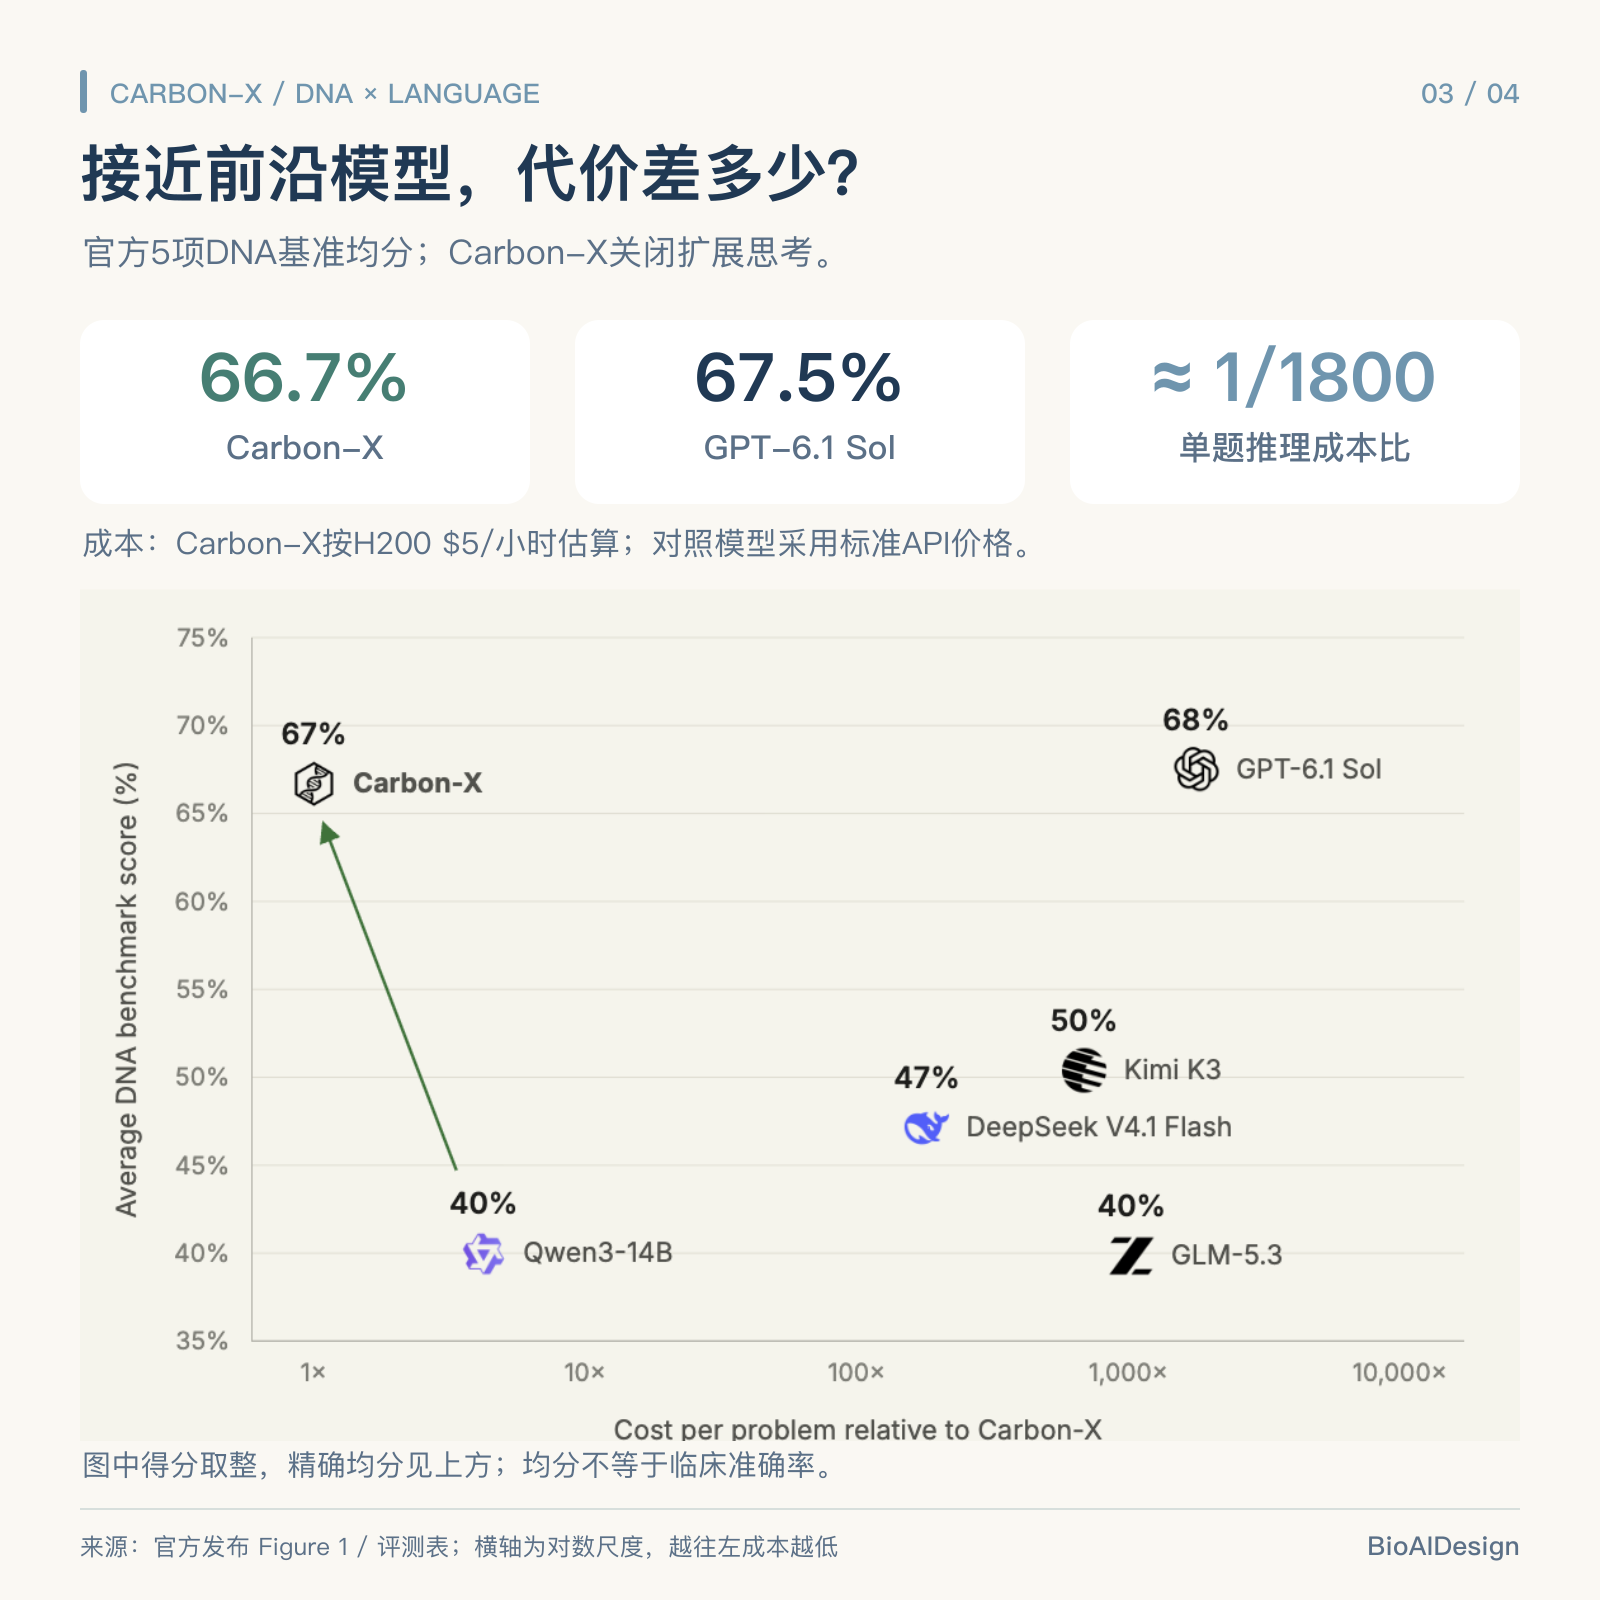
官方5项DNA基准平均得分66.7%,接近GPT-6.1 Sol的67.5%;编码区变异影响与后续碱基预测两项,超过此次测试的全部对照模型。 按H200每小时5美元及对照API价格估算,单题推理成本约为GPT-6.1 Sol的1/1800,仅适用于官方评测条件。
本地部署与 Agent 协作
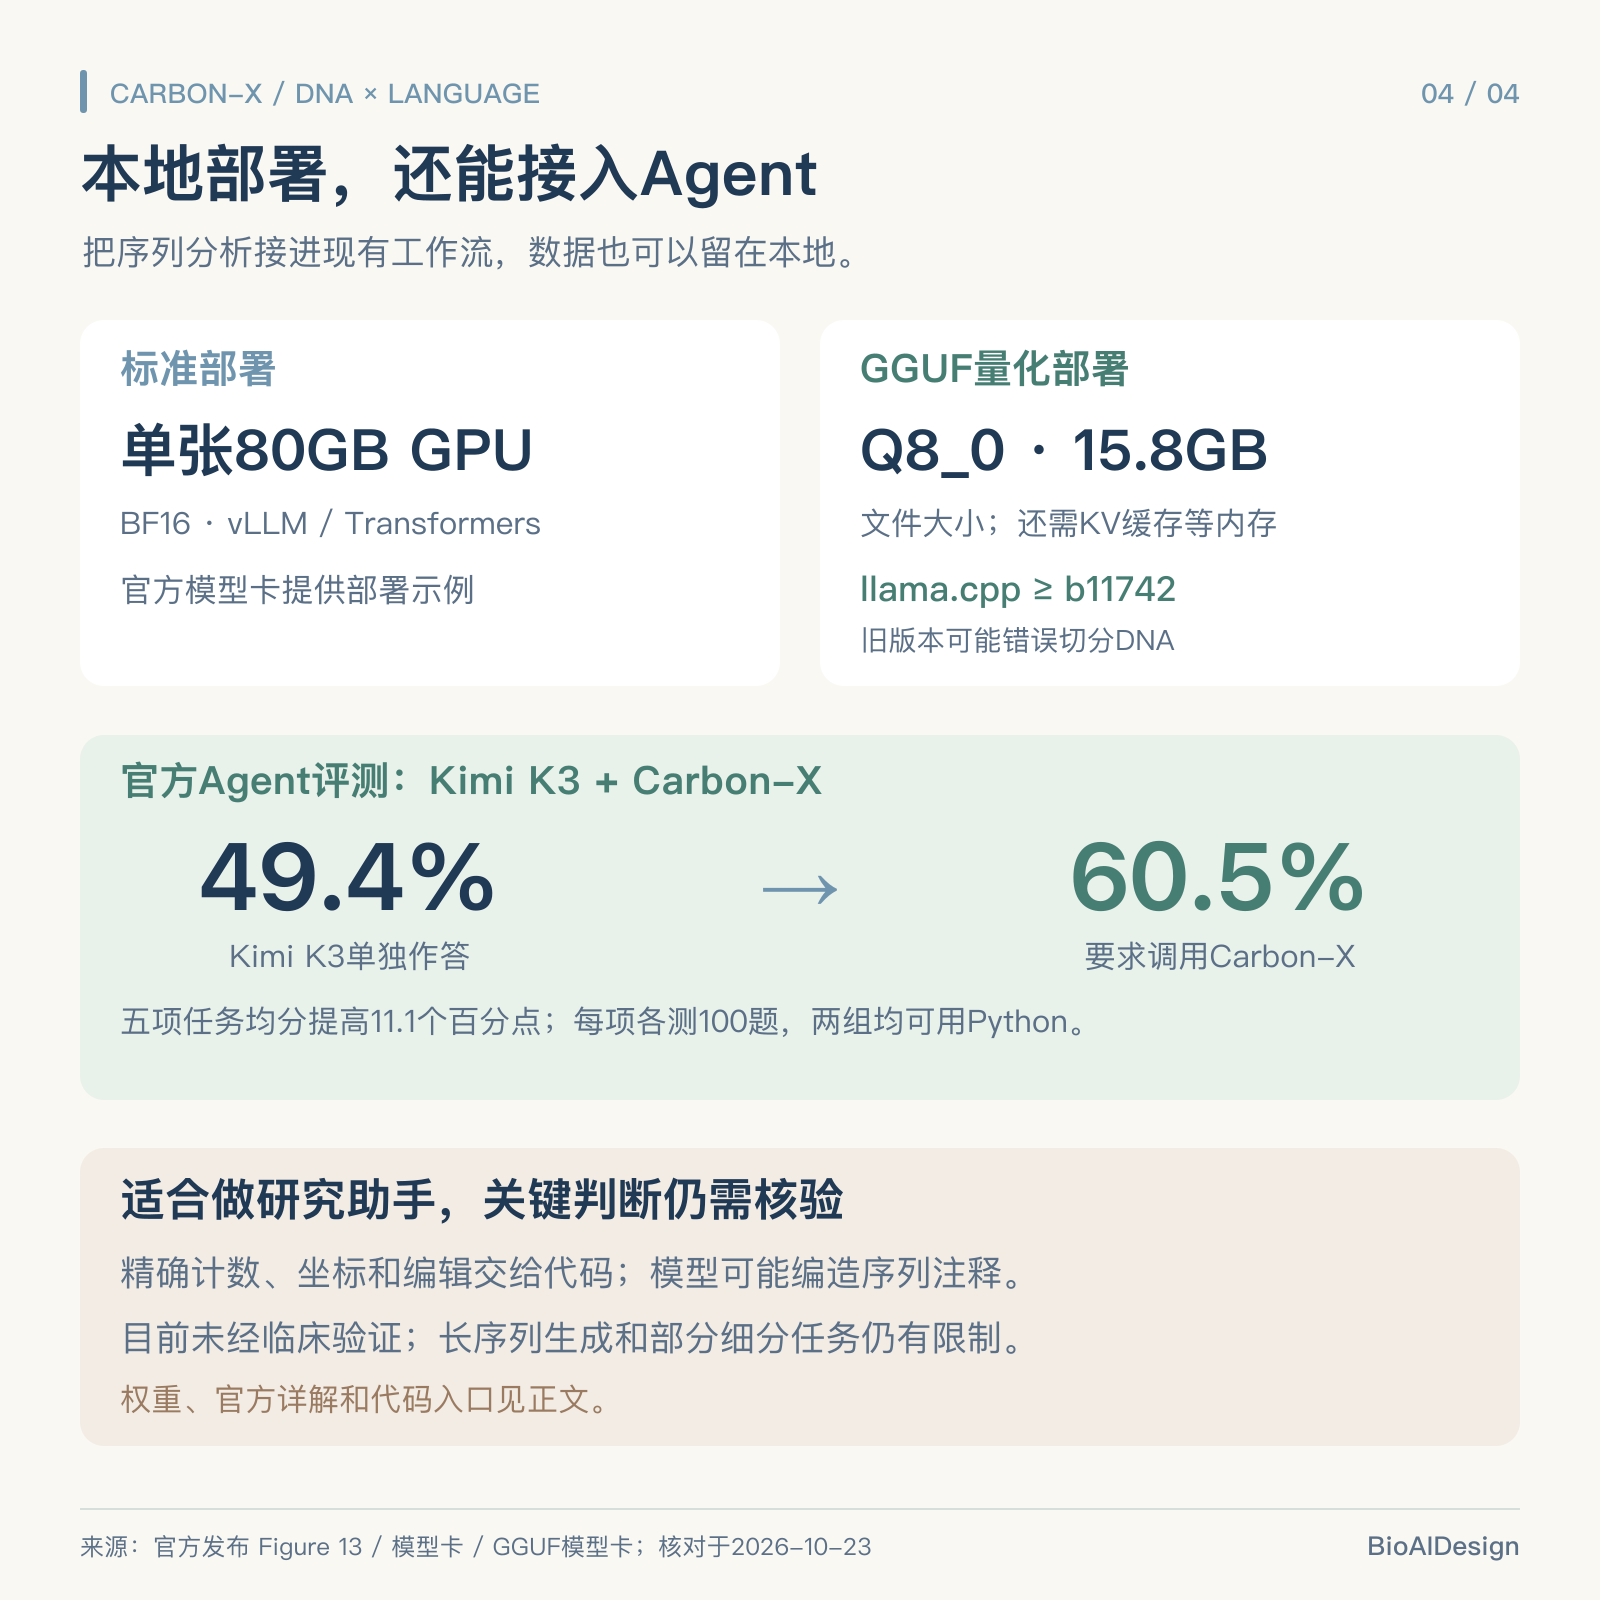
权重采用Apache 2.0许可。官方GGUF推荐Q8_0文件约15.8GB,需llama.cpp b11742或更新版本,运行还需额外内存。 在Agent评测中,要求Kimi K3调用它后,五项均分从49.4%升至60.5%;每项各测100题,两组均可用Python。
输出仍需核验
模型可能误判功能、算错碱基或坐标,未经临床验证;生成DNA也不代表获得了实验验证的功能元件。
来源与资源
官方详解:https://huggingface.co/spaces/HuggingFaceBio/Carbon-X-Release
沿着问题继续