COMPASS:从非编码序列寻找 RNA 与蛋白伙伴
结合序列表征、结构与基因邻域建立可搜索图谱,为 RNA 引导系统和潜在编辑工具提供待验证线索。
Arc Institute / Patrick D. Hsu团队 · 2026-10-22
COMPASS 把难以注释的非编码序列整理成可搜索的图谱,让寻找新RNA及其蛋白伙伴有了可追查的起点。
寻找新的基因编辑工具,不能只盯着蛋白。CRISPR需要引导RNA,桥重组酶也需要桥RNA来识别目标与供体DNA。但如果一种RNA的序列与已知家族差得太远,常规检索可能连候选都找不到。
Arc Institute的Patrick D. Hsu团队把目光转向这些难以注释的区域:用 Evo-PIN 学习原核生物基因间序列,再通过 COMPASS 建立非编码序列图谱。研究随后沿着RNA结构、邻近蛋白和科研智能体三条线索,寻找值得实验验证的分子工具。Arc官方发布线程也将重点放在“未知非编码生物学”,而非一种已经完成验证的新编辑器。
论文信息
| Title | Systematic mapping of the prokaryotic noncoding sequence space with a genomic language model |
| Journal | bioRxiv |
| Posted | 2026-10-22 |
| DOI | https://doi.org/10.64898/2026.10.21.760802 |
序列不像,能否先找到可能的同类
RNA可以在碱基序列变化很大时,仍保留相似结构与功能。直接逐字比较容易漏检;先做结构分析,又需要找到一批可能相关的序列。COMPASS 的切入口,是先用语言模型把这种关系转成可比较的数字表征。
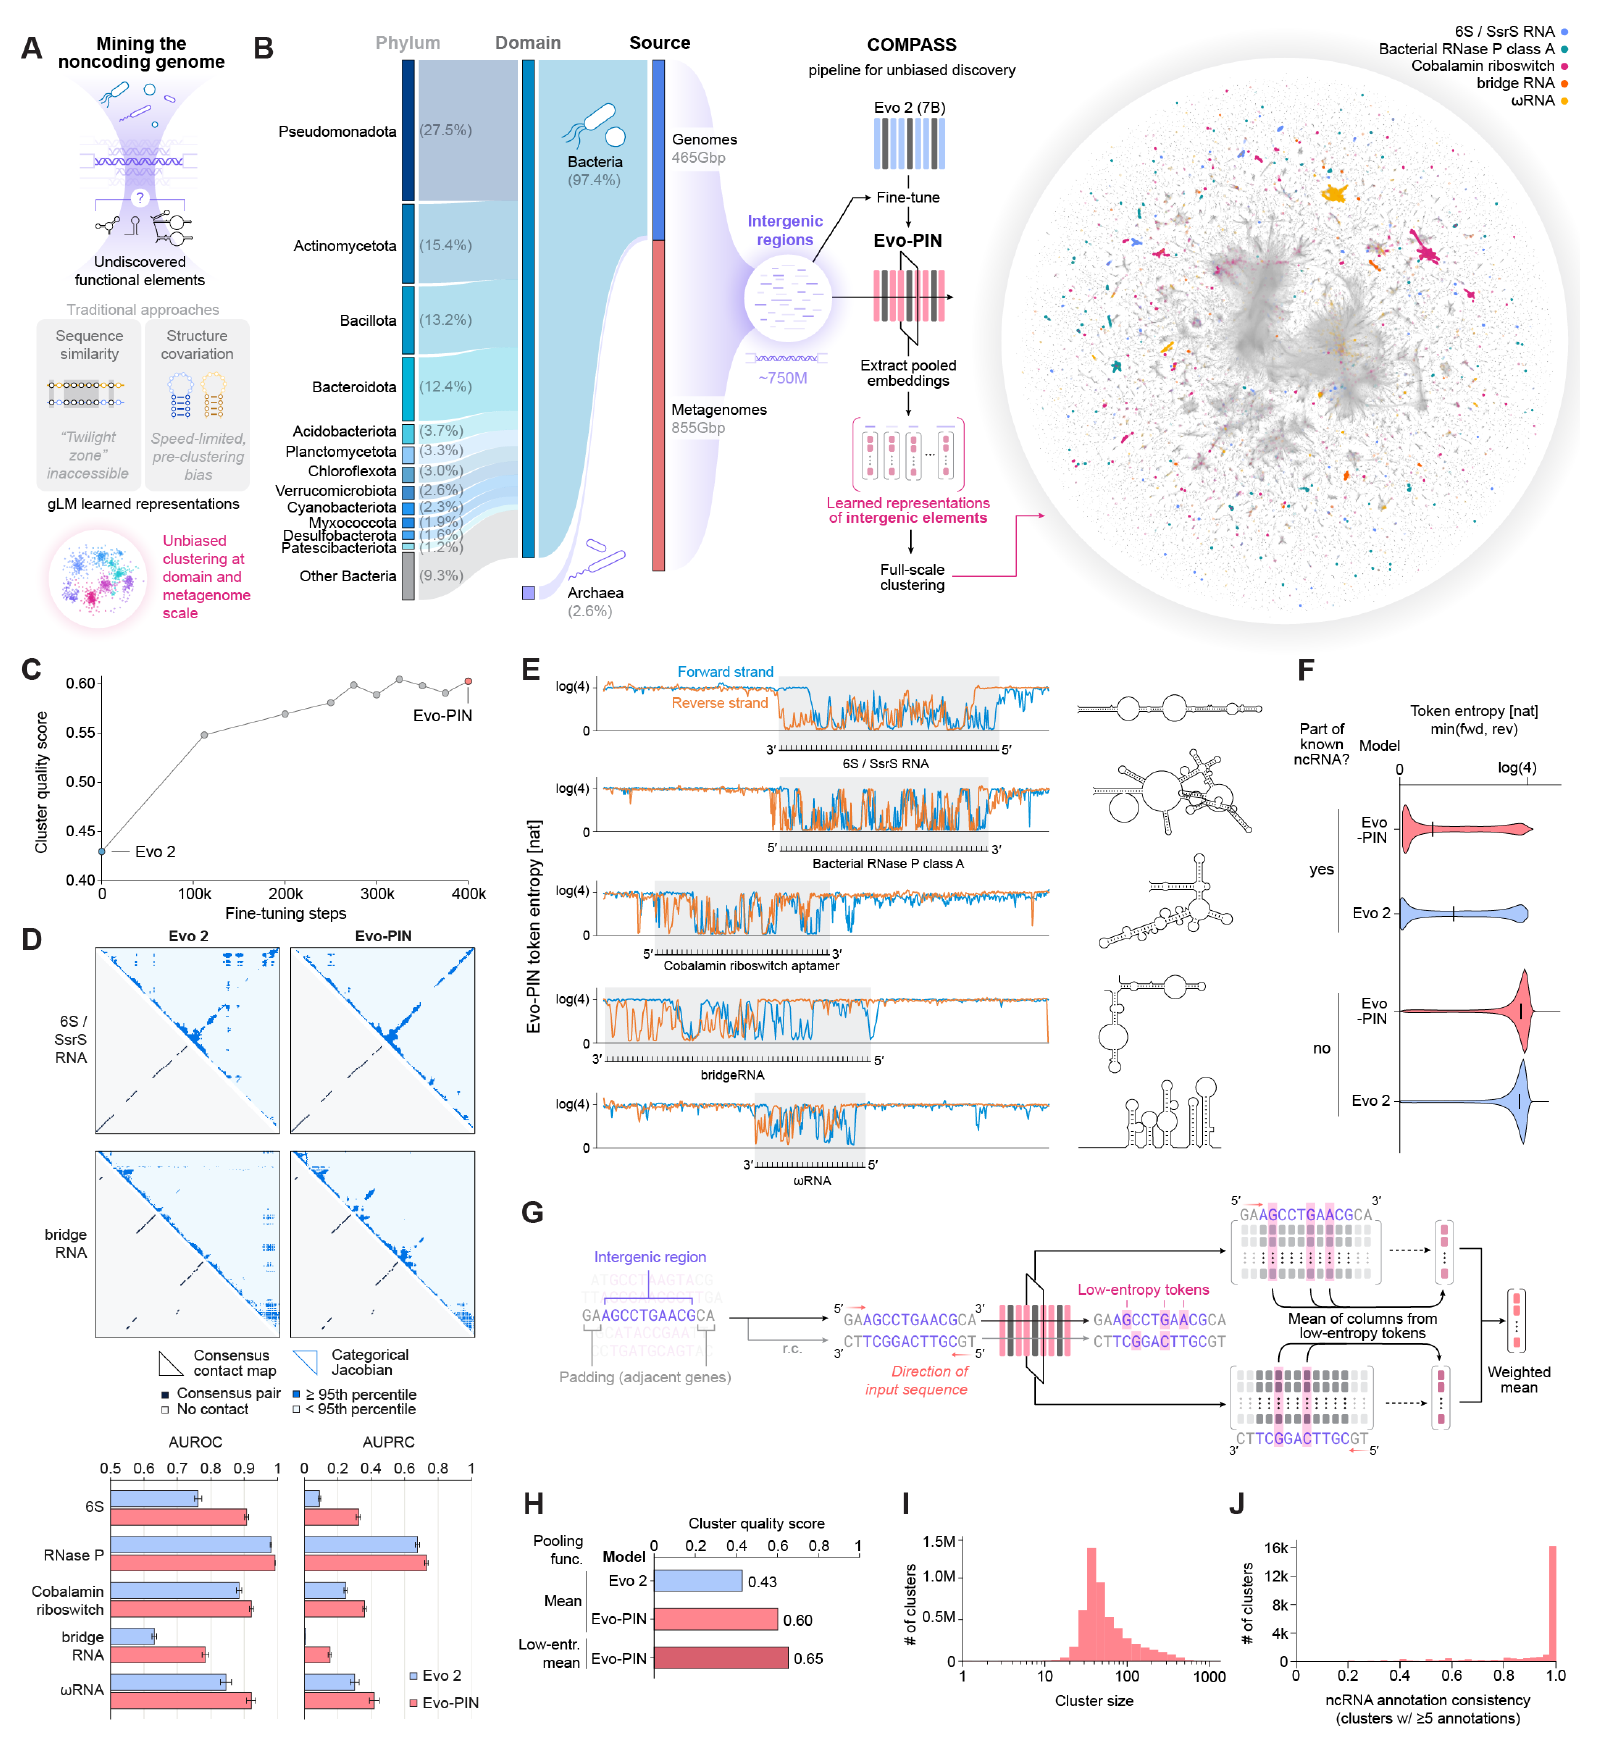
研究汇集约14.4万个细菌与古菌代表物种的基因组,加上宏基因组数据,总计约1.3万亿碱基对。提取基因间区域并减少同源冗余后,得到7.5亿条代表性序列,用于在 Evo 2-7B 基础上继续预训练,形成 Evo-PIN。这里的输入是DNA,目标则是捕捉其中可能编码RNA的规律。
整段序列求平均会稀释局部功能信号。团队因此利用“预测熵”:它表示模型预测某个碱基时有多不确定。在已知非编码RNA区域,模型通常更确定,于是只汇总低熵位置的表征。已知家族基准上的聚类质量分数,从原始模型的0.43升至微调后的0.60,再升至0.65。这衡量同类序列是否聚到一起,不是功能预测准确率。
模型是否也学到了结构联系?团队逐个改变碱基,观察其他位置的预测概率如何变化。在五类已知RNA中,这种位置间依赖比原始模型更好地恢复了共识碱基配对,支持表征包含结构信息,但尚不是新RNA三维结构的验证。
进一步质控与聚类内去冗余后,3.76亿段序列被组织成约514万个聚类。同簇序列的两两一致性中位数仅28.5%,说明模型不只是重新汇总高度相似的序列。含已知RNA注释的聚类不足1%,但这不意味着其余99%都是新RNA家族:同一家族可能分散到多个簇,未注释区域也未必都有RNA功能。
找到RNA候选,还要找它身边的蛋白
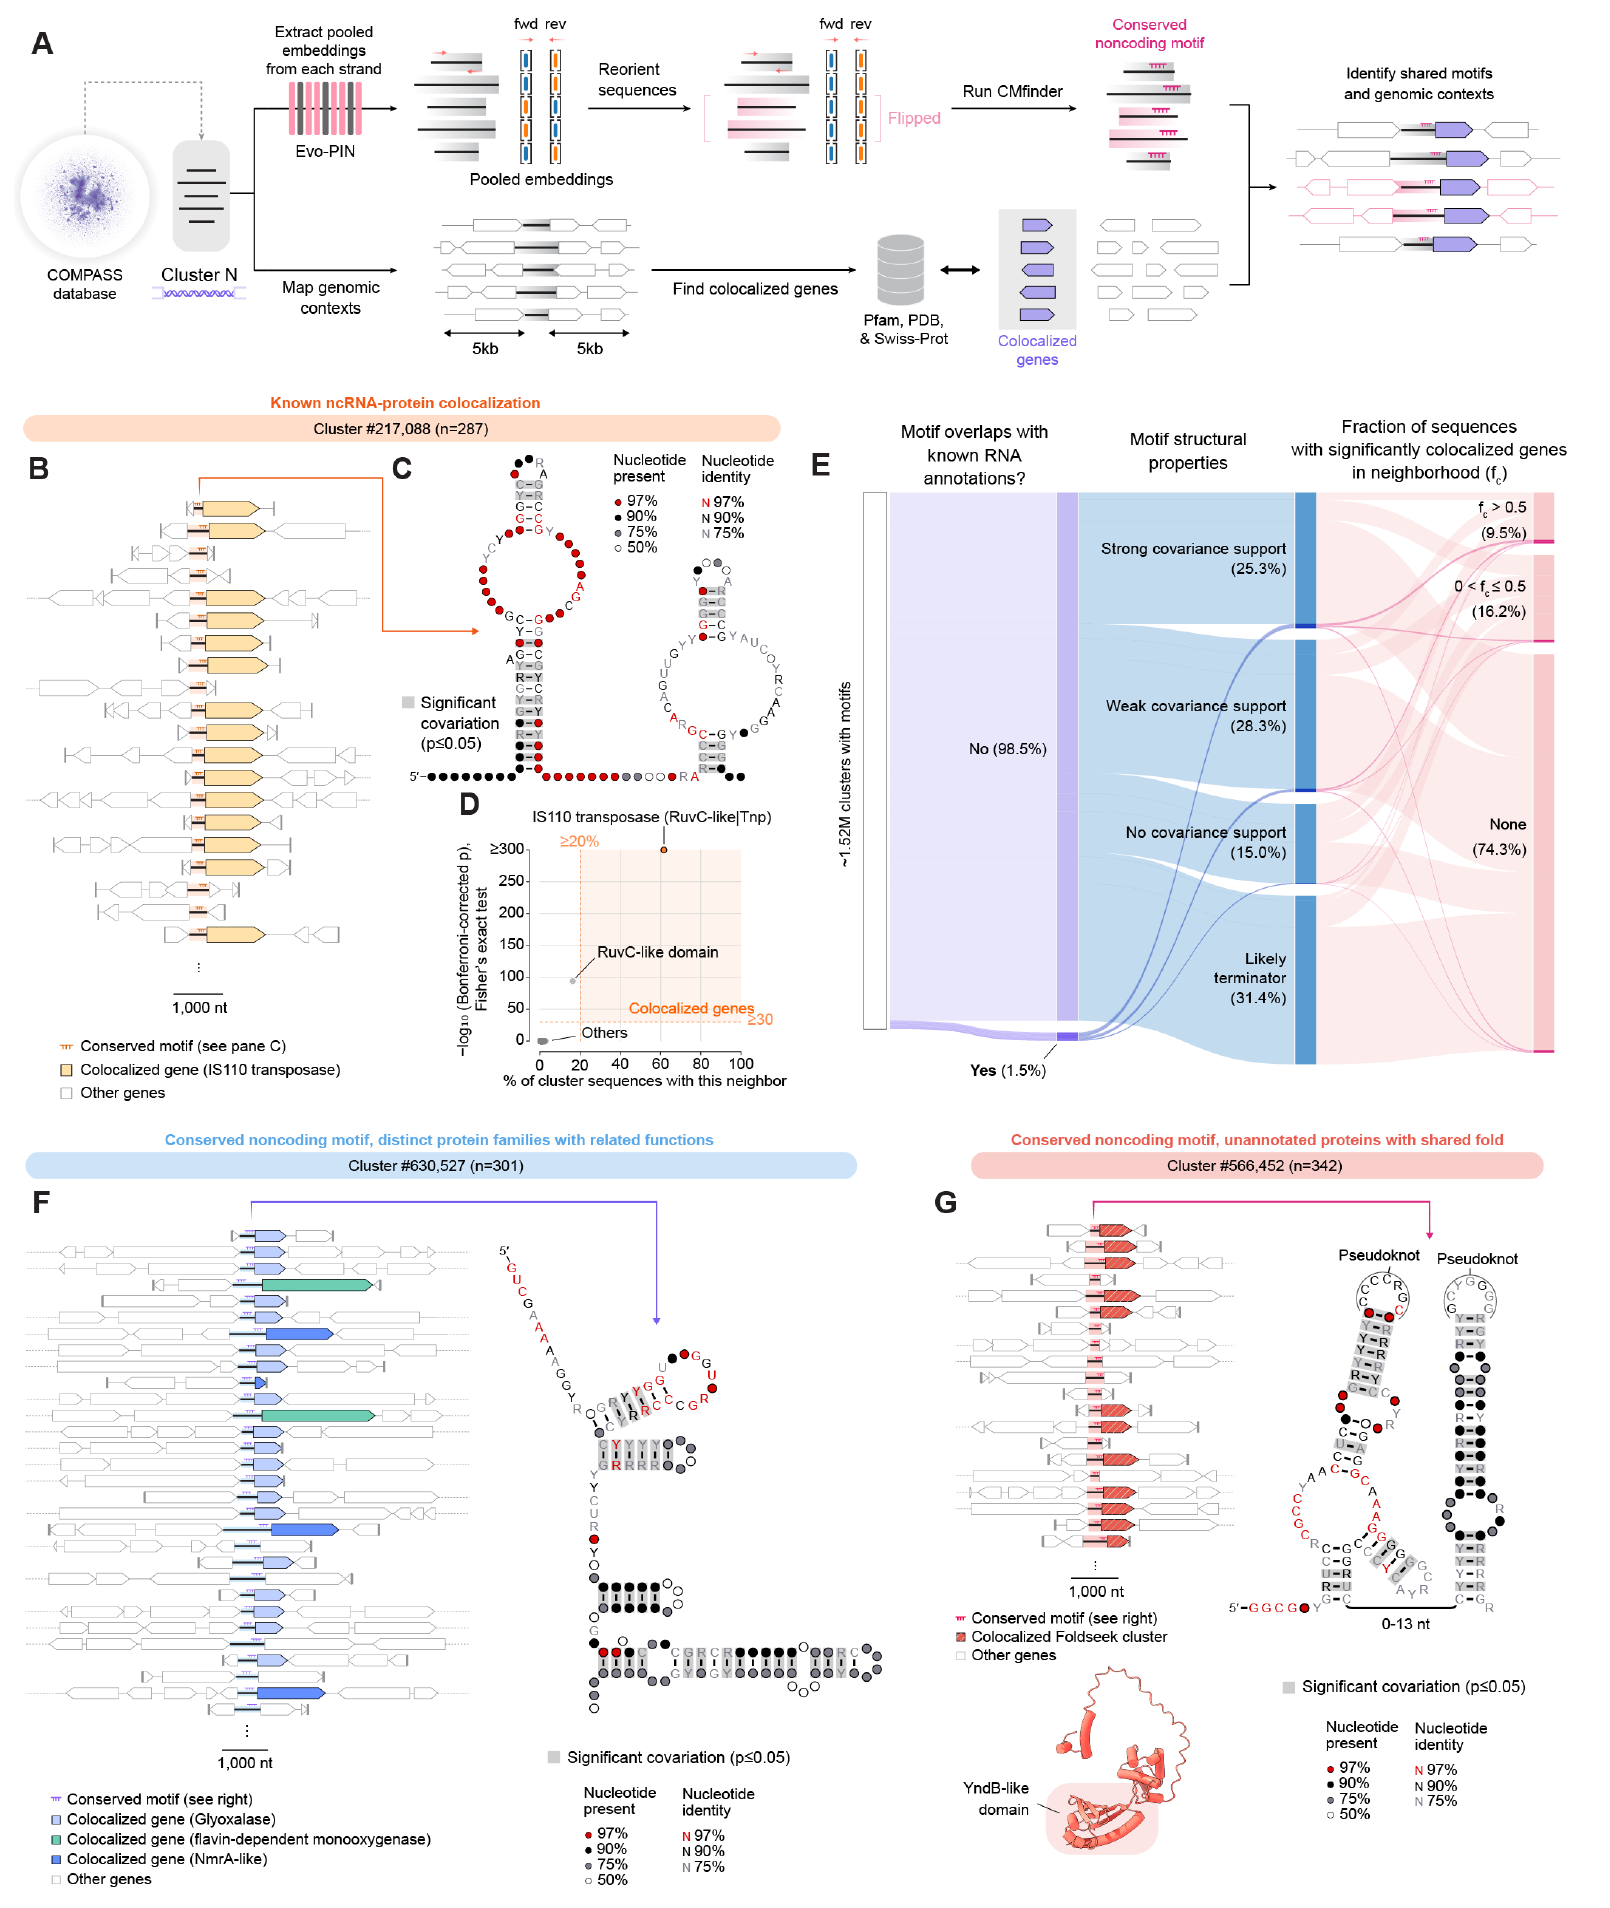
把序列分组只是开始。接下来要问:同簇成员是否保留共同的RNA结构?附近是否反复出现某类蛋白基因?
团队统一序列方向,用 CMfinder 寻找保守结构,再检查“协变”:如果RNA两端需要配对,一端改变,另一端可能随之改变以维持配对。这样的演化证据,比单条序列预测出一个漂亮结构更有说服力。
约152万个簇得到代表性结构基序。排除已知RNA与疑似转录终止子、结合较强协变信号和邻近基因富集后,研究提出20,149个带候选蛋白伙伴的结构RNA聚类。邻域分析覆盖两侧各5 kb,寻找的是跨成员反复出现的关联,不是某一条序列偶然挨着一个蛋白基因。
其中能重新找到桥RNA与IS110重组酶的关联,也能发现保守RNA分别邻接几类功能相关蛋白的情况。还有一组相邻蛋白没有明确家族注释,却呈现相似预测折叠。这些线索有助于安排实验,但基因挨得近,不等于已证明RNA与蛋白结合;RNA也可能调节邻近基因的表达。
这里的“不依赖比对”,指最初的大规模表征聚类。后续结构与功能解释仍使用序列比对、协变模型、蛋白注释和结构检索,不能把整条流程说成完全不用已知知识。
从重复节奏里找RNA引导系统
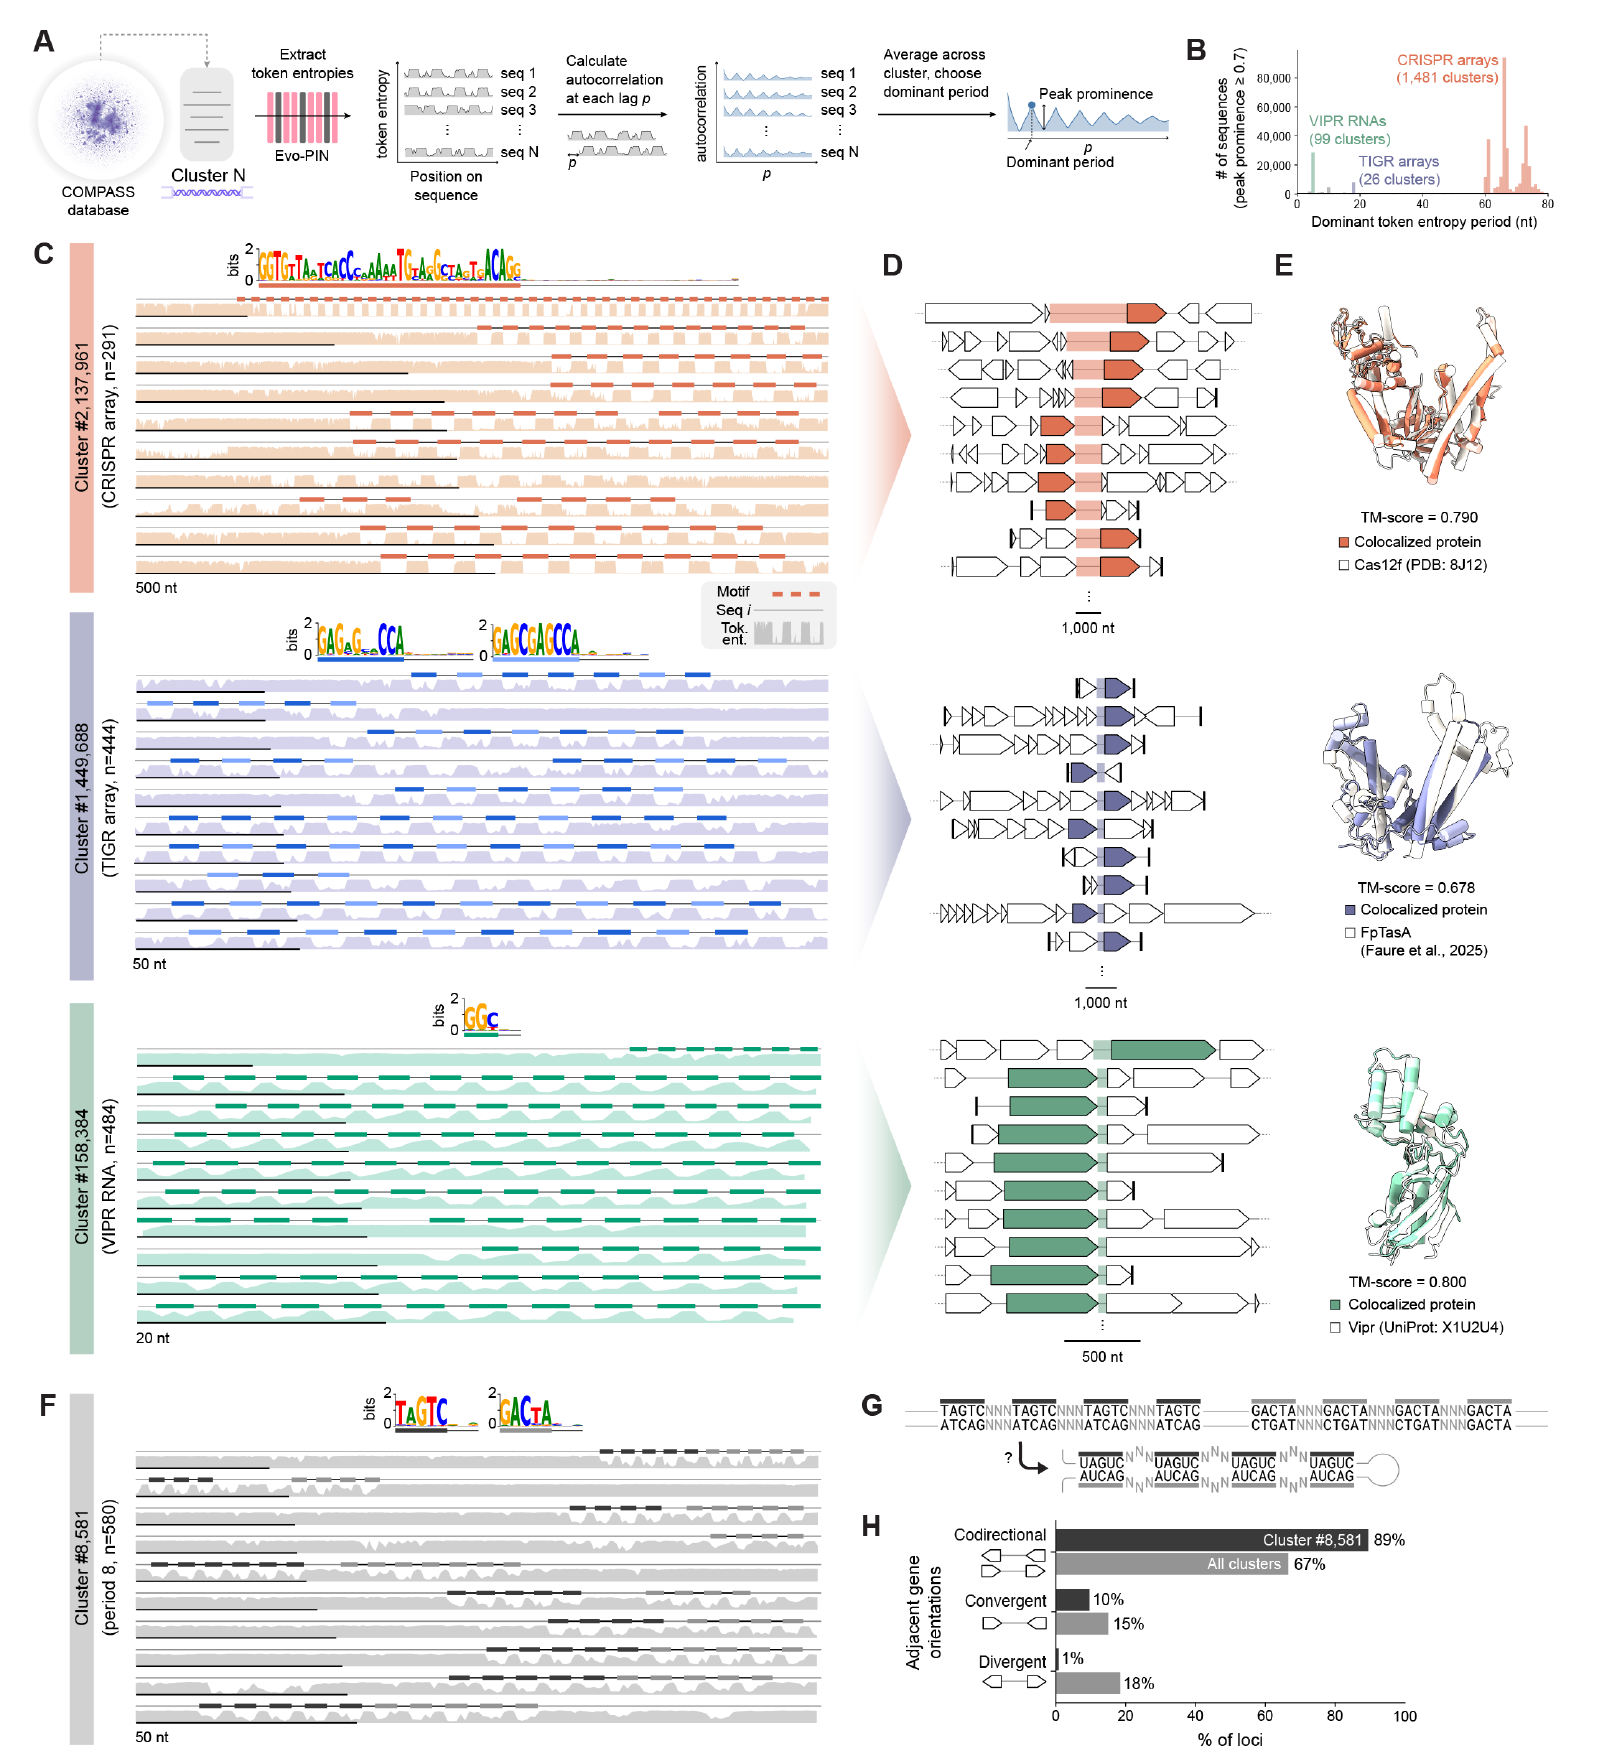
CRISPR阵列由较保守的重复序列和变化较大的间隔序列交替组成。模型面对前者更确定、后者更不确定,预测熵就可能出现重复起伏。团队据此搜索周期信号,而不必先指定某个已知RNA家族。
达到周期性筛选条件的1,672个聚类中,主要信号落在三类区间:CRISPR约60–79个核苷酸,TIGR约18个,VIPR约5个。结合邻近蛋白的预测结构,又能分别对应到Cas12f等相关效应蛋白,形成RNA阵列与蛋白的双重支持。
另外一些簇显示不同的重复架构,例如可能形成串联小发卡的序列。它们值得追查,却还没有找到对应效应蛋白。周期性也可能来自DNA本身的结构特征。因此,这一步既能找回已知系统,也能提出新候选,不能把所有重复阵列都叫作新的基因编辑系统。
桥RNA能否识别更长的DNA
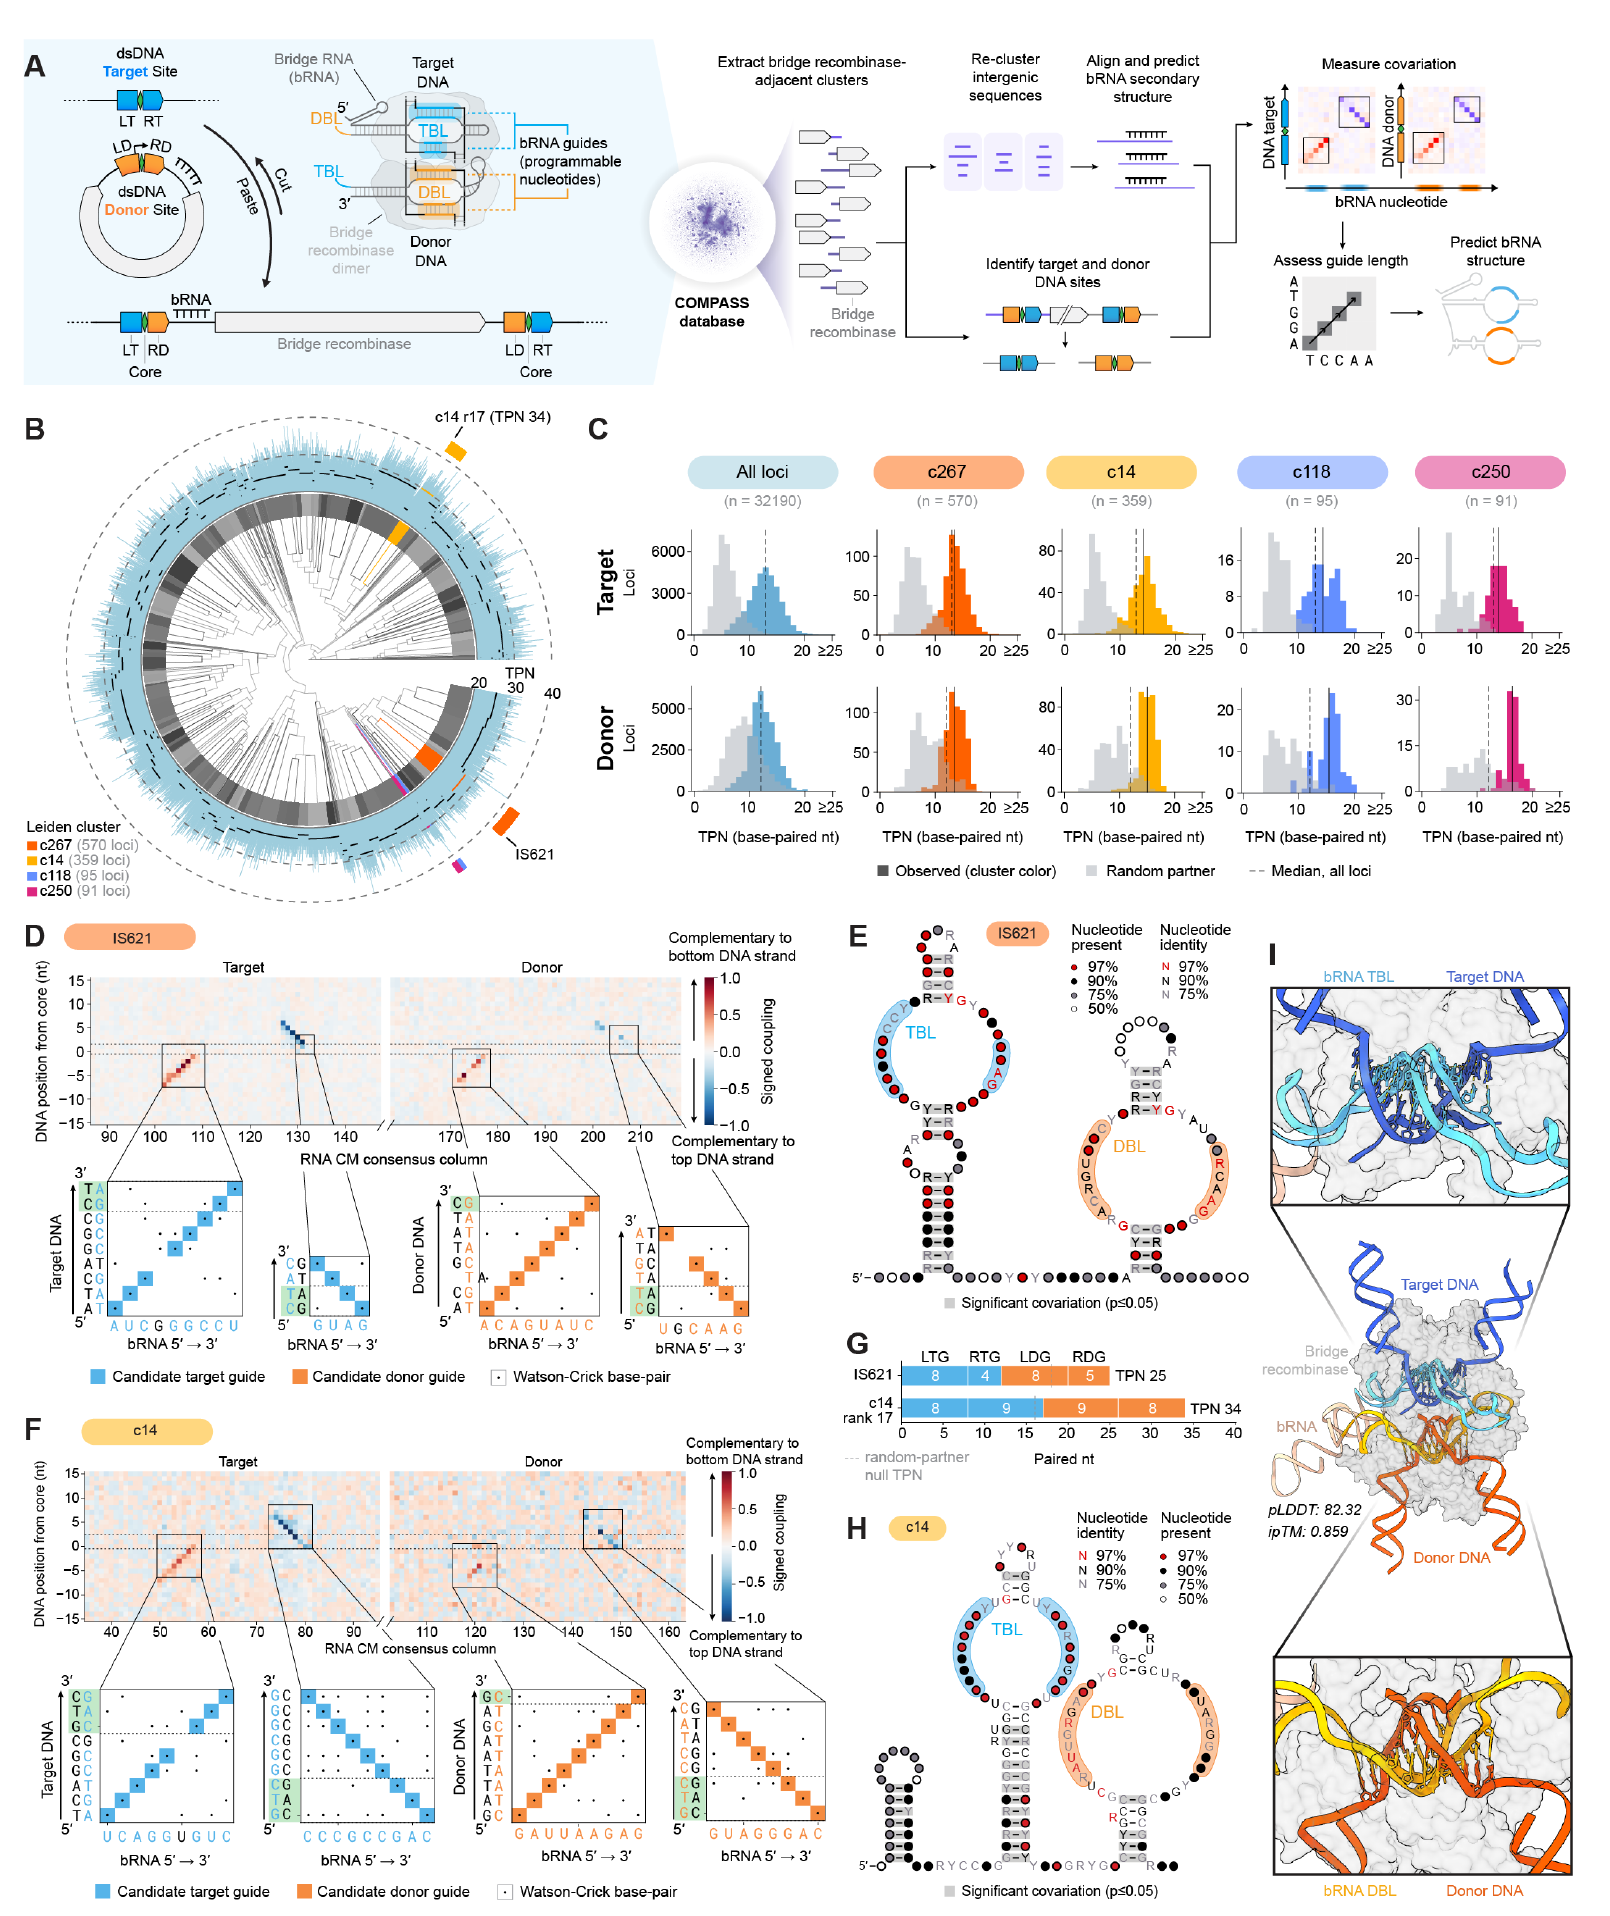
桥RNA包含两个识别环,分别与目标DNA和供体DNA配对,帮助重组酶完成DNA重组。对开发工具的人来说,一个具体问题是:自然界有没有识别序列更长、值得进一步测试的版本?
研究重新聚类桥重组酶附近的序列,结合RNA与DNA的协变,预测32,190个桥RNA位点的总可编程核苷酸数(TPN)。这个数是目标与供体识别段长度之和,并非单侧引导长度。
已实验表征的IS621桥RNA总计为28。此次预测中,6,113个候选、即19.0%的位点超过28。一个代表候选预计分别识别17个目标和17个供体核苷酸,合计34;用 Protenix 联合预测RNA、重组酶和DNA后,模型中也出现相应配对。
这使候选更值得测试,但结构图是计算模型,不是实验解析结构。识别更长,不等于已经证明编辑更准。 模型对已知IS621也存在漏判配对,后续还要检验实际重组效率、可编程性与脱靶情况。19%是“预测超过长度基准的候选比例”,不是精度提高19%。
智能体不只查资料,还要拼出候选证据
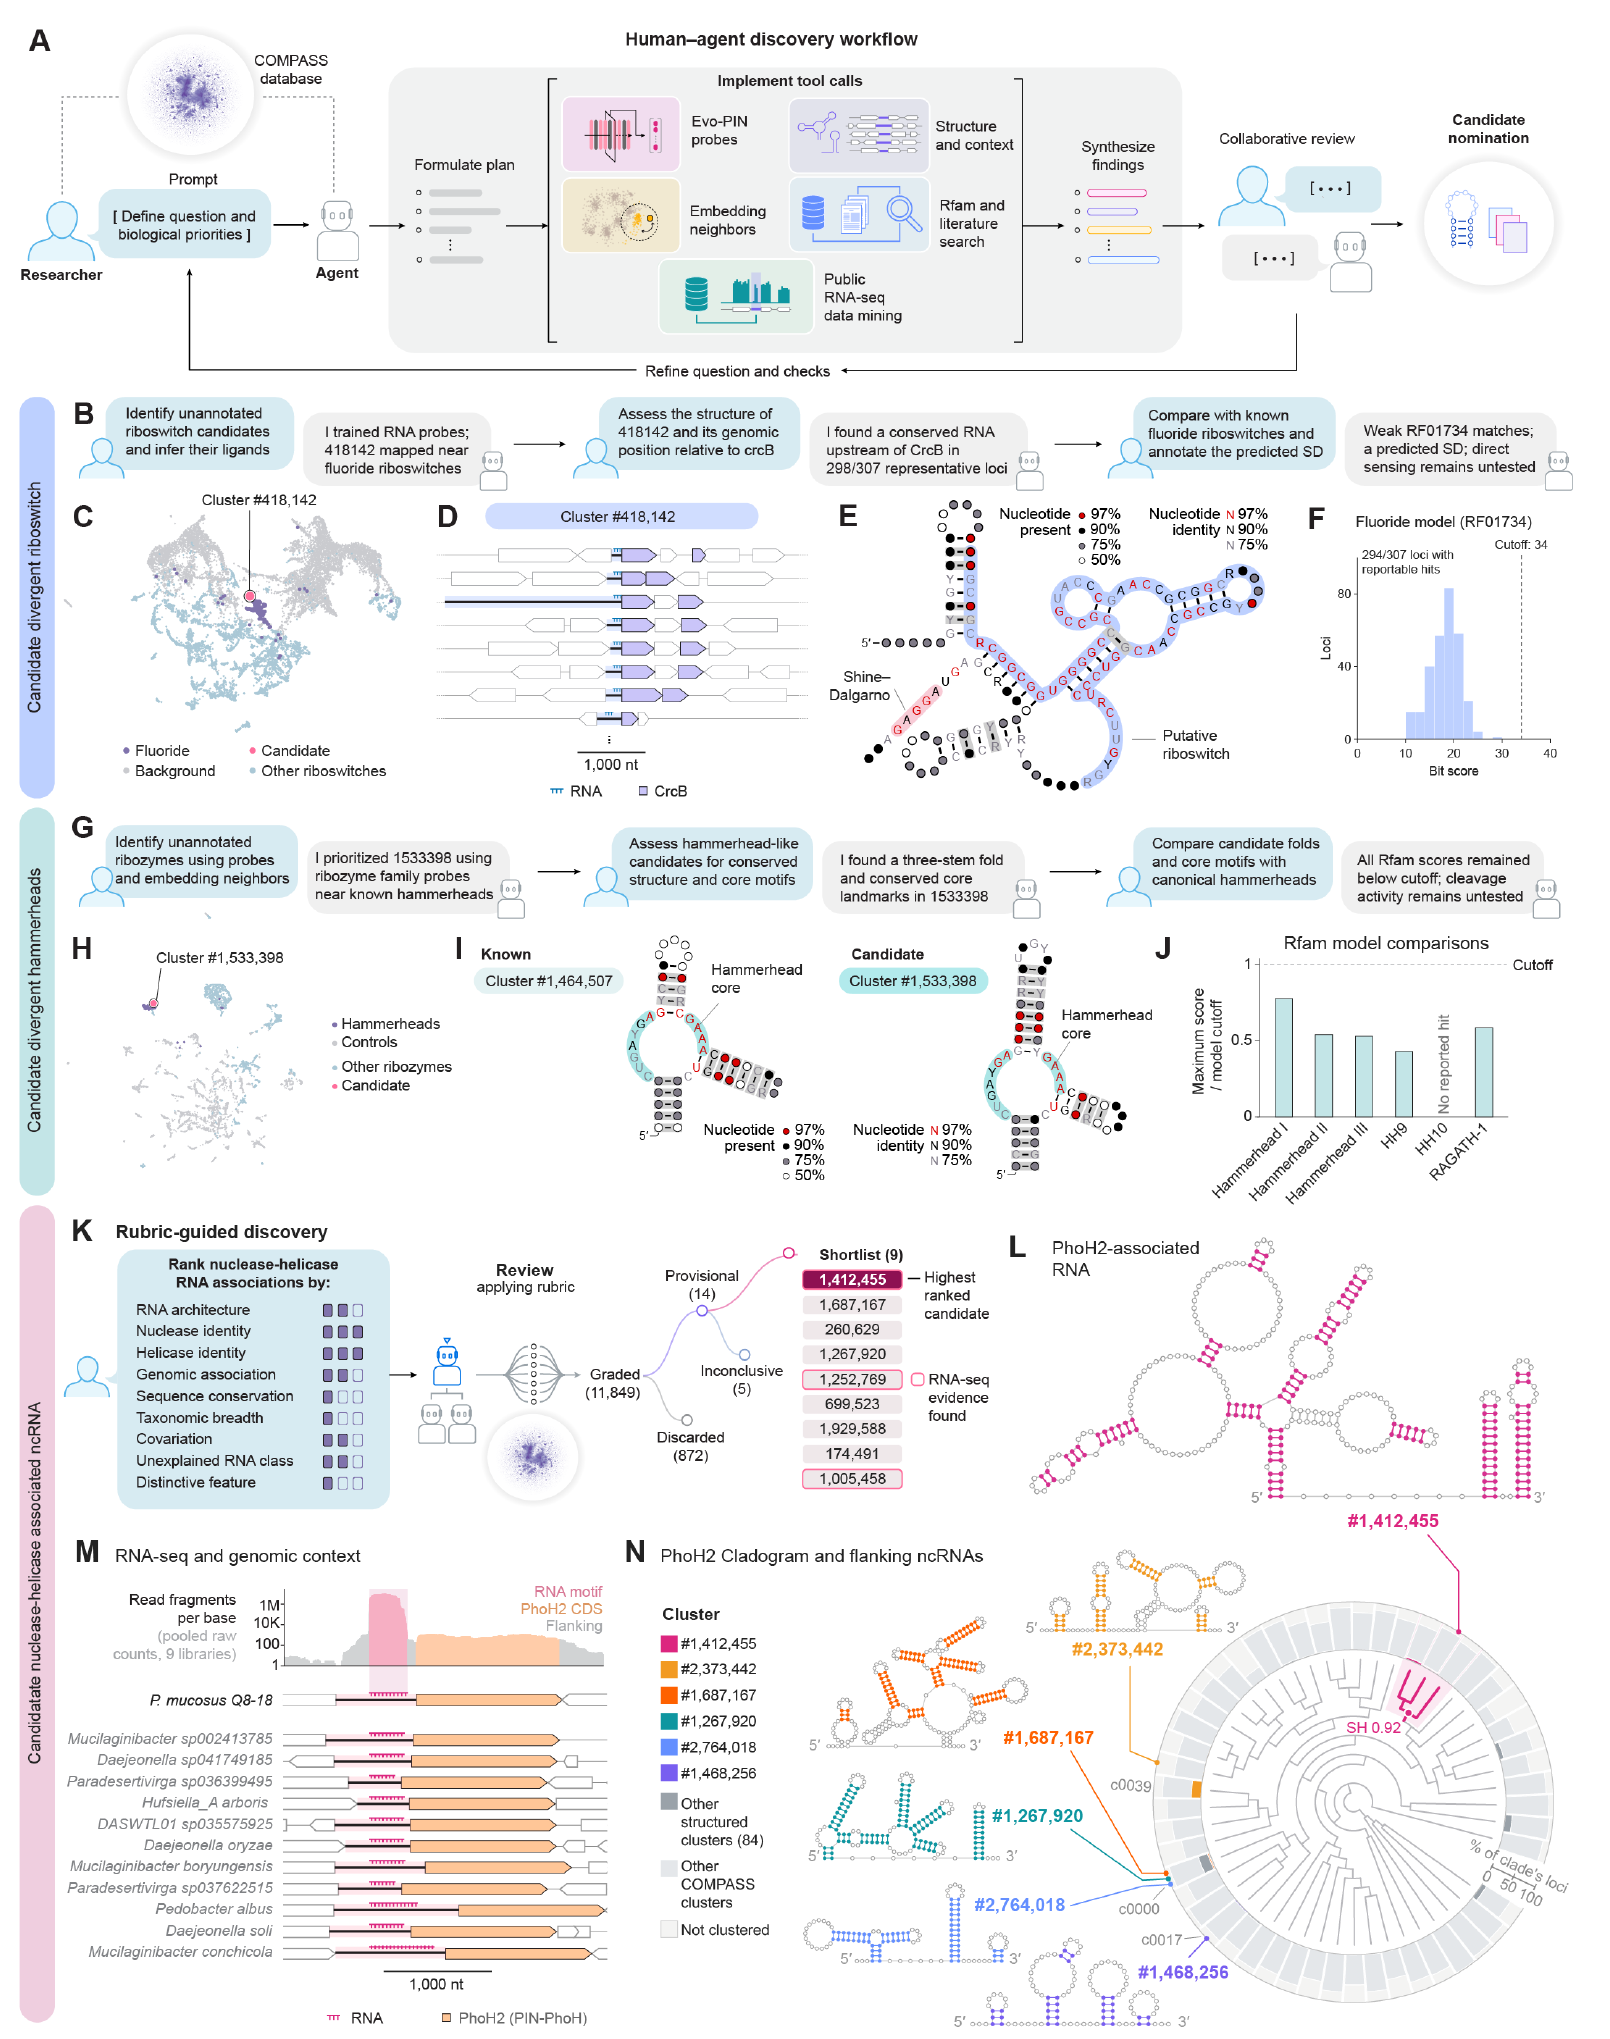
面对数百万聚类,研究者无法逐一追查。团队用 compass-agent 搭建研究者参与的工作流:人提出生物学问题与评价标准,智能体编写分析、检索文献和数据库、汇总结构及邻域证据,再由独立智能体复核。
一类任务是寻找已知功能的远缘成员。智能体在表征上训练简单分类器,分别搜索核糖开关与核酶:前者感知小分子并调节基因表达,后者直接催化反应。一个氟离子核糖开关候选簇含307个成员,均未达到原有 Rfam 家族模型的注释阈值,但保留可能的配体识别结构,并反复出现在氟离子通道CrcB基因旁。另一个锤头核酶候选簇有152个位点,保留三茎架构及CUGA核心,却未被六个既有锤头模型认出。
这两例说明多类证据可以补足单一注释阈值的盲点,不代表配体响应或催化活性已经测出。分类器也用了已知类别标签,不能把这一步称为完全无监督发现。
另一类任务更开放:在人设定证据标准后,智能体调查14,722个簇,评估11,849个“聚类—基序”假设,297个进入详细调查,得到14个暂定候选,最终只有1个满足全部评分标准。这比把上万个假设都算成发现,更能体现筛选的意义。
该候选与兼具核酸酶、解旋酶结构域的PhoH2蛋白相关:326个位点中,228个位于PhoH2基因5 kb范围内,148个紧邻该基因。智能体还分析了9份公开RNA测序数据,找到候选区域被转录的证据;不同PhoH2谱系附近也伴随不同RNA结构。它们共同支持后续实验,却仍不能证明RNA怎样影响PhoH2。
先改变找工具的方式,再谈治疗
Arc官方帖下,一条公开可见的读者评论问到:这项工作能否与癌症治疗进展结合?这个问题提示了应用期待,但本篇研究对象是原核生物非编码序列,没有癌症模型或治疗效果验证。近期价值更具体:缩小RNA与候选蛋白的实验搜索范围,找到值得开发的传感、调控或基因组工程部件。
论文目前为未同行评议预印本,新候选的分子功能仍待验证。研究者可以免登录浏览约25.5万个精选聚类,查看结构和基因邻域;通过模型上下文协议(MCP)接口,智能体可检索完整约514万个聚类。MCP连接需要登录,且并非每个簇都有结构与基序信息。
COMPASS 提供的不是一份已获认证的新工具目录,而是一张附有证据的候选地图。哪些RNA确实有功能、哪些蛋白是它的伙伴、哪些组合能成为好用的编辑工具,接下来要由实验回答。
来源与资源
| 资源 | 内容 | 链接 |
|---|---|---|
| 论文 | 正文、方法及补充图 | https://doi.org/10.64898/2026.10.21.760802 |
| COMPASS | 精选聚类交互图谱 | https://compass.arcinstitute.org/ |
| 官方说明 | 研究定位与网页收录范围 | https://compass.arcinstitute.org/about |
| 智能体入口 | MCP说明与使用入口 | https://compass.arcinstitute.org/agents |
| Arc官方线程 | 用户提供的发布帖及后续解读 | https://x.com/arcinstitute/status/2113365767052042615 |
| 读者讨论 | 关于癌症应用的公开提问,不作为研究证据 | https://x.com/OlafWoodall/status/2113366140382826525 |
配图均截自论文主图,保留完整分图;中文图注为独立概述。帖子讨论仅覆盖本次无需登录即可读取的内容,不代表全部评论。
沿着问题继续